

今天把單兵 Agent 和 Supervisor 架構放在同一批信上跑。
結果是:公平升級過的單兵 Agent 贏了 Supervisor 架構,55 比 50。
我花了一段時間確認這不是測錯了。確認完之後找到原因,改了 W1 的 prompt 裡的一行,Supervisor 追回到 55 平手,而且危險錯誤比單兵少。這個過程比分數本身有意思,所以今天從頭講。
拿 Day 04 那個單兵 Agent 來比是不公平的。它沒有檢索、沒有結構化輸出、沒有程式守門員——而這些東西跟「要不要拆成多個 Agent」是兩回事。前面 27 天我學到的大部分東西,單兵 Agent 也可以用。
所以我做了三個參賽者:
| 是什麼 | 有什麼 | |
|---|---|---|
| A | Day 04 的單兵 Agent | FAQ 塞在 prompt 裡、一個查訂單工具、輸出純文字 |
| B | 單兵 Agent v2 | 三個工具(查單、列單、FAQ 檢索)、Structured Output、程式守門員 |
| C | Supervisor 架構 | 主管+三位專員、Switch 派工、九道防線、審批分流 |
B 是今天真正的對手。 它拿到的東西跟 C 幾乎一模一樣:同一組 Data table 工具、同一個 bge-m3 向量庫、同一份結構化契約、同樣的「事實必須有來源」檢查、同樣的合規檢查。
唯一的差別是沒有拆開:一個 Agent 做完分類、查詢、寫信三件事。
B 的守門員就是把 C 散在三個地方的程式檢查搬到同一個 Code 節點:
// 1. 事實要有來源,沒有的丟掉(Day 11)
const facts = allFacts.filter(f => f && String(f.source ?? '').trim());
// 2. 該轉人工就不寄(Day 17)
const escalate = ['complaint', 'promo_coupon', 'other'].includes(intent);
// 3. 合規檢查(Day 13)
if (!draft.includes(SIGNATURE)) violations.push('缺少署名');
B 的 prompt 是今天一口氣寫的,裡面有 Day 17 的決策表、Day 12 的「檢索工具總是會回東西,你要自己判斷」、Day 13 的語氣規範、Day 11 的來源規則。它沒有針對這 62 封信逐案調過,而 C 被我調了 27 天。這一點後面會再提。
測試集是 Day 27 整理好的 62 封,外加 12 封從來沒用來調過任何東西的 holdout。
三個系統跑同一批信的結果如下圖。
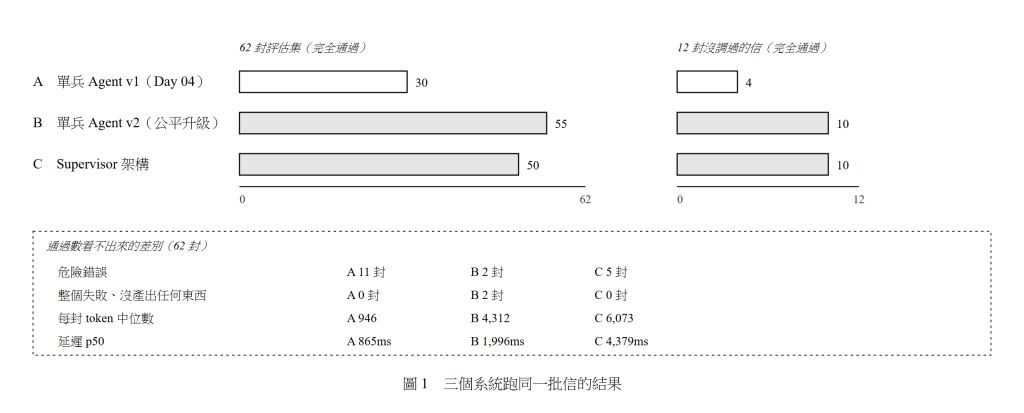
| 62 封 | A 單兵 v1 | B 單兵 v2 | C Supervisor |
|---|---|---|---|
| 完全通過 | 30 | 55 | 50 |
| 部分通過 | 21 | 3 | 7 |
| 失敗 | 11 | 2 | 5 |
| 整個失敗、沒產出東西 | 0 | 2 | 0 |
| 危險錯誤 | 11 | 2 | 5 |
| 每封 token 中位數 | 946 | 4,312 | 6,073 |
| 延遲 p50 | 865ms | 1,996ms | 4,379ms |
12 封沒調過的 holdout:A 4/12、B 10/12、C 10/12。
按難度拆開,差距的來源很清楚:
| A | B | C | |
|---|---|---|---|
| E 簡單(14 封) | 11 | 13 | 14 |
| M 中等(27 封) | 11 | 24 | 23 |
| H 困難(21 封) | 8 | 18 | 13 |
所有差距都在困難那一欄。 而且方向跟我預期的相反——我以為拆分的價值就在困難案例上。
A 是 30/62,11 個危險錯誤,其中 10 個是同一種:該轉人工卻自己回了。
Day 04 的做法是叫模型在回信開頭標註 [需人工處理]。17 封該轉人工的信,它只標對 7 封。客訴信、要折扣的信、看不懂的信,它都很熱心地回了。
holdout 上更慘,4/12。
所以從 A 到 B 的進步(30 → 55)是這 27 天真正的成果:檢索、結構化輸出、程式守門員。這些東西加起來把正確率拉高了 25 封。
但那 25 封裡,沒有一封是靠拆分換來的。
B 比 C 好的有六封,C 比 B 好的有三封。
C 比 B 好的三封:
list_orders_by_email({"customer_email":"..."})
list_orders_by_email({"customer_email":"..."})
list_orders_by_email({"customer_email":"..."})
...連續八次,然後重跑三次
這就是 Day 26 砍掉 W1 工具時看過的同一種死法:工具回了一個它用不上的結果,模型不會放棄,它會再呼叫一次同樣的工具,直到迭代上限用完。
B 比 C 好的六封裡,有三封是同一類,而且都是 C 的危險錯誤:
| 客人寫的 | C 的回答 | B 的回答 | |
|---|---|---|---|
| EV12 | 我的濾杯什麼時候寄? | 列出兩筆,請客人確認 | A10294 備貨中,9/17 送達 |
| EV56 | 那個淺焙的豆子到了嗎? | 列出兩筆,請客人確認 | A10293 已出貨,單號 8891234567 |
| EV59 | 那支日曬的寄了嗎? | 列出兩筆,請客人確認 | A10307 已出貨,9/15 送達 |
還有一封 EV51,就是 Day 27 那封轉寄的髒信——C 回答了客人明說「這個我收到了」的那一筆,B 正確回答了另一筆。
四封同信箱多筆訂單的信,B 四封全對,C 四封全錯。
我第一個猜測是 Day 22 的問題:主管把信壓成一句 clean_question,線索在這一步掉了。
去看才發現不是。C 的 clean_question 寫得很準:
EV12 客戶詢問濾杯的寄送時間。
EV56 詢問淺焙咖啡豆的到貨狀態。
EV59 詢問日曬咖啡豆是否已出貨
線索完整地傳下去了。W1 收到的工單上寫著「濾杯」「淺焙」「日曬」,W1 也確實用 email 查到了兩筆訂單,品項就在它手上。
它還是把兩筆都報了上來。
原因在 Day 11 寫給 W1 的查詢策略第 3 條:
3. 如果 list_orders_by_email 回傳多筆,全部回報,不要自己挑
這條規則是 Day 11 寫的,當時的問題剛好相反——W1 查到兩筆只報一筆,漏掉客人的訂單。所以我寫了一條「不要自己挑」把它堵住。
十七天後,這條規則變成另一個問題的原因。
而這件事只有在拆開的架構裡才會發生。W1 不知道客人為什麼問、不知道這封信的語氣、不知道後面要寫成什麼樣的回信。對一個只負責查資料的專員來說,「查到幾筆就報幾筆」是最安全的規則。真正能判斷「客人問的是濾杯那筆」的那個角色——也就是看過整封信的主管——手上沒有訂單清單。
資訊沒有丟,是判斷的位置和資料的位置被分在兩個地方。
單兵 Agent 沒有這個問題,因為信和訂單清單在同一個 context 裡,它直接比對就好了。
我把那條規則改成這樣(新檔 prompts/w1_v3.md):
3. 如果 list_orders_by_email 回傳多筆,先看工單的「要查什麼」裡有沒有足以指認的線索
   (品項名稱、下單時間、處理法、烘焙度等):
   - 剛好對得上其中一筆 → 只回報那一筆,並在 notes 寫下你是依據什麼判斷的
   - 對不上、或兩筆以上都符合 → 全部回報,用 subject 區分
   沒有線索的時候絕對不要自己挑一筆
先跑 Day 15 那份 20 題的 W1 考卷確認沒有退步——20/20,其中「多筆結果」那一類 3/3,跟改之前一樣。
然後重跑 62 封:
| 62 封 | B 單兵 v2 | C 原本 | C 改一行之後 |
|---|---|---|---|
| 完全通過 | 55 | 50 | 55 |
| 失敗 | 2 | 5 | 1 |
| 整個失敗 | 2 | 0 | 0 |
| 危險錯誤 | 2 | 5 | 1 |
| 困難(21 封) | 18 | 13 | 17 |
| 每封 token 中位數 | 4,312 | 6,073 | 6,382 |
| 延遲 p50 | 1,996ms | 4,379ms | 4,417ms |
holdout 12 封:B 10/12、C 10/12,危險錯誤各 1。
正確率打平。危險錯誤 C 比 B 少一個。代價是每封多付 48% 的 token、兩倍多的延遲。
把四欄放在一起看,我的結論是這樣。
第一,拆分本身沒有提高正確率。 55 比 55,holdout 10 比 10。真正把 30 拉到 55 的是檢索、結構化契約和程式守門員——那些單兵 Agent 一樣能用。
第二,拆分買到的是「不會整個垮掉」。 B 有兩封信整個失敗,各燒掉約 49,000 個 token 什麼都沒產出。C 一封都沒有。
原因是結構上的:C 的主管沒有工具可以呼叫(Day 18 選的 Switch 版把派工交給程式),所以它不可能在工具迴圈裡打轉;W1 的迴圈上限是 6 次而且只碰得到訂單工具。每一封信的工作量在架構上就有上界。 B 的單一 Agent 手上有三個工具和八次迭代,上界要靠模型自己收斂。
第三,拆分讓錯誤的位置變得明確。 C 剩下的那個危險錯誤是 EV16(該轉人工卻自己回),我知道它發生在分類那一步,改分類規則就好。B 的兩個危險錯誤也是分類問題,但那個分類是在同一次推理裡跟查詢、寫信一起做的——要改就得動那份什麼都管的 prompt,而動它會同時影響另外兩件事。
今天那個「改一行就追回五封」本身就是證據:在拆開的系統裡,我能把問題定位到一個 20 行的 prompt 的第 3 條。
第四,代價是真的。 每封信多付 48% 的 token、延遲從 2 秒變成 4.4 秒。如果你的量是一天 120 封,這些都是小錢;如果是一天 12,000 封,這是一個需要認真算的決定。
B 的 prompt 是我今天一口氣寫完的,只跑過一次 smoke test 就上場。C 是我調了 27 天的東西,而且就是對著這 62 封信調的。
在這種不對等之下,B 還是贏了第一輪。
這說明兩件事。一是 27 天累積的知識大部分可以寫進一份 prompt,不需要靠架構來承載;二是我對這份評估集的 overfitting 可能比我以為的少——因為真正把分數撐起來的是那些可以用一句話寫清楚的規則,不是逐案的微調。
holdout 的結果支持第二點:兩邊都是 10/12,跟 62 封上的比例差不多。
clean_question 把「濾杯」「淺焙」「日曬」都傳下去了。原因是 Day 11 寫給 W1 的一條規則「查到多筆全部回報,不要自己挑」,那條規則當初是為了堵住相反的問題。明天最後一天,把這 30 天的結論收起來,包括「什麼時候不該用 Multi-Agent」。今天的數字已經先回答了一半。


 iThome鐵人賽
 看影片追技術