
同一題目、同一次條件變更,比較回答速度、數值正確性與程式可用性。有些答案附了正確程式,正文卻寫出另一個結果。
2026年10月10日,六道題目各測一次初答與固定追問,共24份正式API回應。DeepSeek關閉思考,GPT使用供應端預設推理;以下比較的是這兩種配置,並非同等推理預算下的排名。
| 比較面向 | DeepSeek V4-Flash | GPT-6 Sol | 本次觀察 |
|---|---|---|---|
| ⚡ 初答速度 | 中位數47.00秒;範圍24.30~104.45秒 | 中位數57.02秒;範圍28.52~108.56秒 | DeepSeek中位數較短約10秒,但U5、U6由GPT較快 |
| ⏱️ 條件變更追問速度 | 中位數27.74秒 | 中位數29.73秒 | 接近;DeepSeek統計包含一次達上限截斷的回應 |
| 🎯 初答數值正確性 | U2、U5主要數值正確;U1、U3、U4、U6正文有重大錯誤 | 六題主要數值符合獨立核對 | 本次GPT主要數值較可靠,不換算成通用正確率 |
| 🧠 解釋品質 | 部分手算、統計解釋與依賴關係有誤;U5需清理試錯文字 | 統計假設、對偶證明與變更說明較一致 | 數值之外,仍需核對推導與適用條件 |
| 💻 程式可用性 | U1、U3及U4兩段程式能算對;U6算錯利潤且自帶斷言失敗 | 已執行的U1、U3、U4、U6程式主要輸出正確,U6通過自帶斷言 | 只評已實際執行的程式,不代表所有程式都已驗證 |
| 🔗 正文與程式一致性 | U1、U3、U4出現「程式正確、正文錯誤」 | 上述已執行題目的主要輸出與正文一致 | 不能把答案中標示的「執行結果」當成真實執行證據 |
| 🔄 條件變更表現 | 部分新數值正確,但仍有相依關係與跨月退款錯誤;U4追問截斷 | 六題主要變更結果符合核對 | 測的是固定條件變更,未測連續糾錯能力 |
| ✅ 回應完整性 | 12份中11份正常結束,1份達輸出上限 | 12份均正常結束 | 完整回應與答案正確須分開判斷 |
| 🎓 學生使用建議 | 可作思路與程式草稿候選,須自行重算並比對正文 | 本次較適合優先試用於數值分析、統計與演算法解題 | 作業交付前仍應理解假設與證明 |
| 💼 職場使用建議 | 適合具備驗證工具的草稿流程;月結與決策數值需特別查核 | 本次較適合優先試用於庫存、資源配置與資料月結 | 真實工作仍須加入邊界案例與獨立驗證 |
**看等待時間:本次DeepSeek初答中位數較短。看交付品質:本次GPT的主要數值、正文與程式結果較一致。**能自行執行與查核程式,可將DeepSeek列為草稿候選;需要較完整的數值解釋與條件變更分析,可優先試GPT。兩者都應經過驗證,才放入作業、報表或決策文件。
耗時包含網路、閘道、排隊與生成,每種配置每題只測一次;本次未量測人類查核及編修工時,因此不能直接推論誰能讓整份工作更快完成。
圖:使用gpt-image-2生成的概念封面。
學生拿AI解數值分析作業,上班族拿AI算庫存與月結,最需要的都是一件事:答案能不能驗證?一段流暢的推導,或者附在後面的Python程式,都不能單獨保證結論正確。
這次透過Crazyrouter API,把六道大學程度與職場模擬題交給DeepSeek V4-Flash和GPT-6 Sol。每題包含初答與一次固定的條件變更追問,共取得24份正式回應,再以獨立計算、完整枚舉及實際執行模型提供的程式核對結果。
在本次設定下,DeepSeek關閉思考後,六題初答耗時中位數較短;GPT的主要數值與解釋較一致。最值得注意的差異,出現在DeepSeek的部分回答中:程式能算出正確答案,正文卻報出錯誤結果。
這是特定入口、設定與六組題目的觀察,適合用來挑選下一步要測的工作流程,不能當成所有任務的模型排名。
測試日期為2026年10月10日,使用Crazyrouter的/v1/chat/completions入口,請求模型名稱為deepseek-v4-flash及gpt-6-sol。回應分別標示deepseek-v4-flash-0731與gpt-6-sol。本文以入口回傳的識別資訊命名,未獨立確認上游官方版本對應。
兩邊使用相同系統指示、題目與追問文字,未提供參考答案,也未開放搜尋或程式執行工具。追問包含各自的初答,因此追問的完整對話內容會不同。
**DeepSeek正式測試明確設定thinking: {type: "disabled"},GPT保留供應端預設推理設定。**因此,結果比較的是這兩種實際配置,不能解讀成同等推理預算下的能力差距。
除U5初答外,輸出上限均為12,000 tokens。U5的DeepSeek初答為8,192、GPT為16,384,兩份成功回應都未達上限。測試採非串流回應,最多四個請求同時進行;記錄的是完整回應耗時,並非首字出現時間。
另外一次DeepSeek的U5預設思考嘗試耗時176.79秒,達16,384 tokens上限後沒有正文,回報的生成tokens全部屬於推理。這次失敗另行記錄,沒有混入上述正式配置的速度統計;它也不能證明DeepSeek開啟思考後一定較差。
下文配圖整理自真實API回應,保留原始摘錄與標記,屬於回應摘錄圖表,並非官方介面截圖。
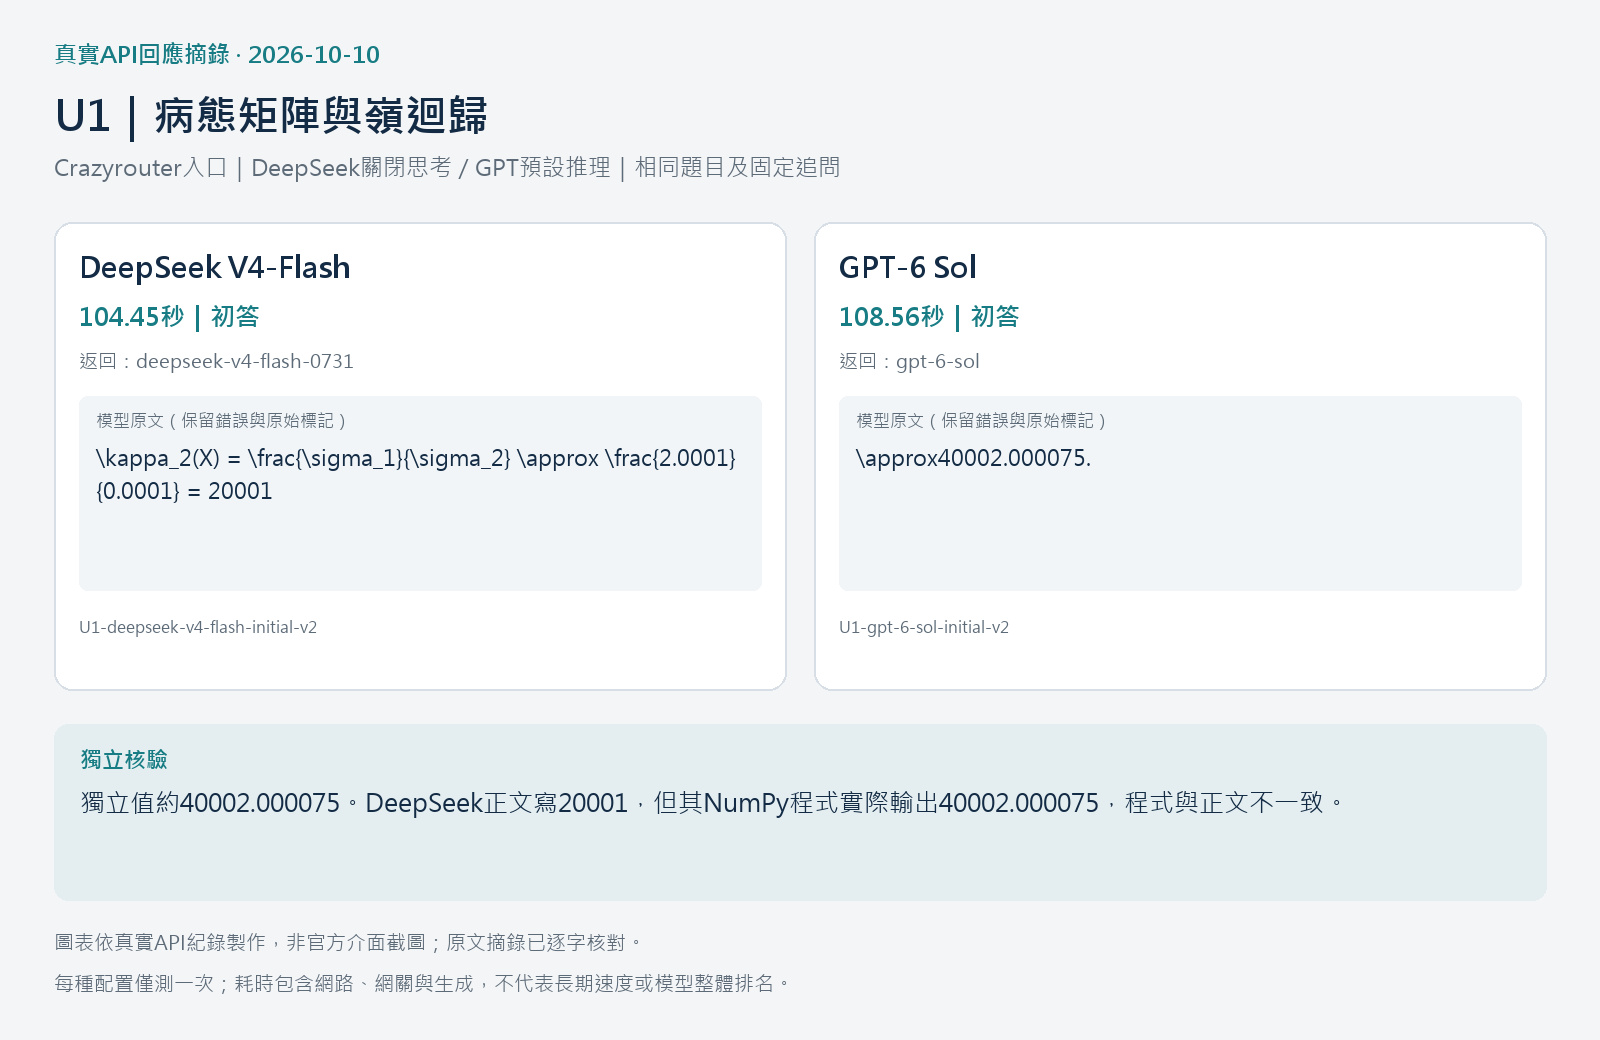
題目給定X=[[1,1],[1,1.0001]]、y=[2,2.0001],不加截距,再將第二筆觀測改為2.0002,要求比較普通解與嶺迴歸。
普通解從[1,1]變成[0,2]。輸入的相對變化只有約0.003535%,係數的相對變化卻達100%。矩陣的2-範數條件數約為40,002.000075,這就是不能只看訓練殘差的原因。
| 核對項目 | 獨立結果 | DeepSeek | GPT |
|---|---|---|---|
| 條件數 | 約40,002.000075 | 正文寫20,001;程式實際輸出正確值 | 主要數值正確 |
| λ=0.001,原始y的係數 | 約[0.99972508,0.99977507] | NumPy程式輸出正確,手算說明有誤 | 與核對一致 |
| λ=0.01,原始y的係數 | 約[0.99748142,0.99753130] | 追問正文數值錯誤 | 與核對一致 |
DeepSeek的問題不是所有程式都不能用,而是同一份答案內出現互相矛盾的數值。GPT的主要結果較一致,但同樣要理解正則化引入的偏差:兩筆訓練資料不足以保證較大的λ一定有較好的泛化表現。
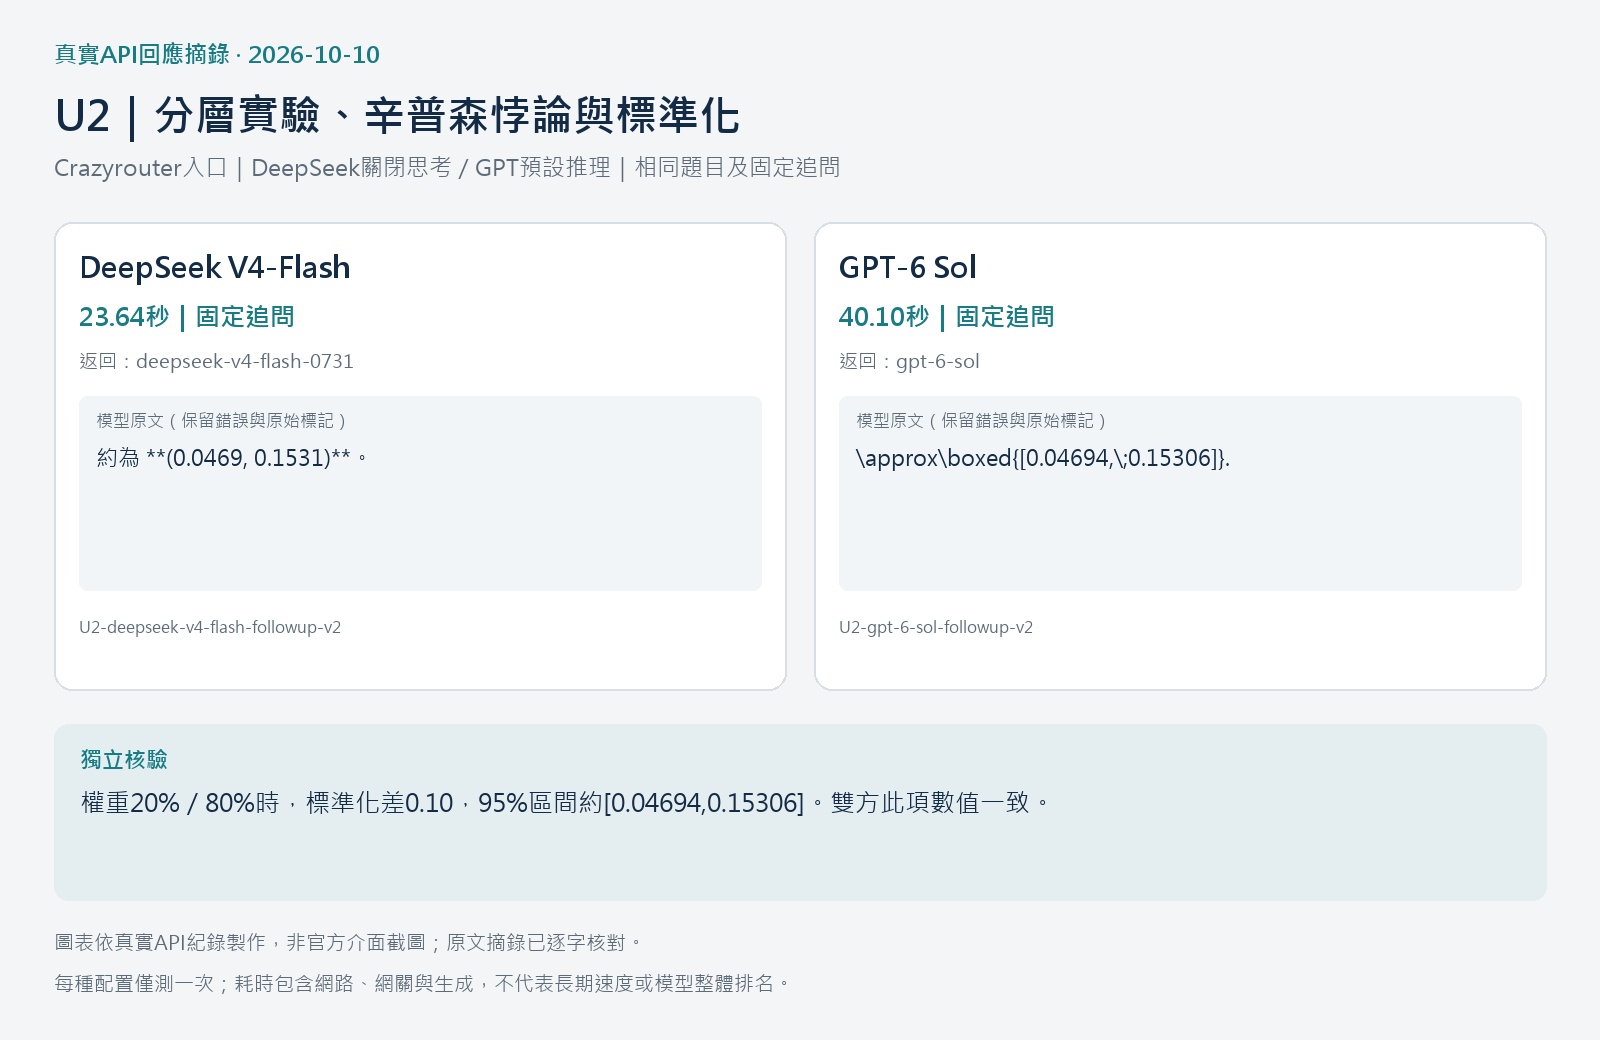
模擬教學資料中,高基礎層A、B達標率為90%與80%,低基礎層為20%與10%。但兩組學生組成不同,合併達標率變成A的27%、B的73%,方向反轉。
| 固定目標權重:高/低 | 標準化A率 | 標準化B率 | A−B | 標準誤 | 95%近似信賴區間 |
|---|---|---|---|---|---|
| 50%/50% | 0.55 | 0.45 | 0.10 | 0.023214 | [0.05450,0.14550] |
| 20%/80% | 0.34 | 0.24 | 0.10 | 0.027072 | [0.04694,0.15306] |
兩邊的主要數值都算對。DeepSeek初答卻出現不適用於本例的說明,例如暗示改變目標權重會改變差值,以及目標人口變大就能降低現有資料的不確定性。追問時,它正確指出兩層差值相同,因此加權後仍為0.10。
GPT較清楚區分標準化關聯與因果效果。學生自行選擇組別,沒有隨機分派;控制基礎程度仍不足以排除組內未量測的混雜。報告若要聲稱教學方法造成改善,必須補上識別假設與研究設計。
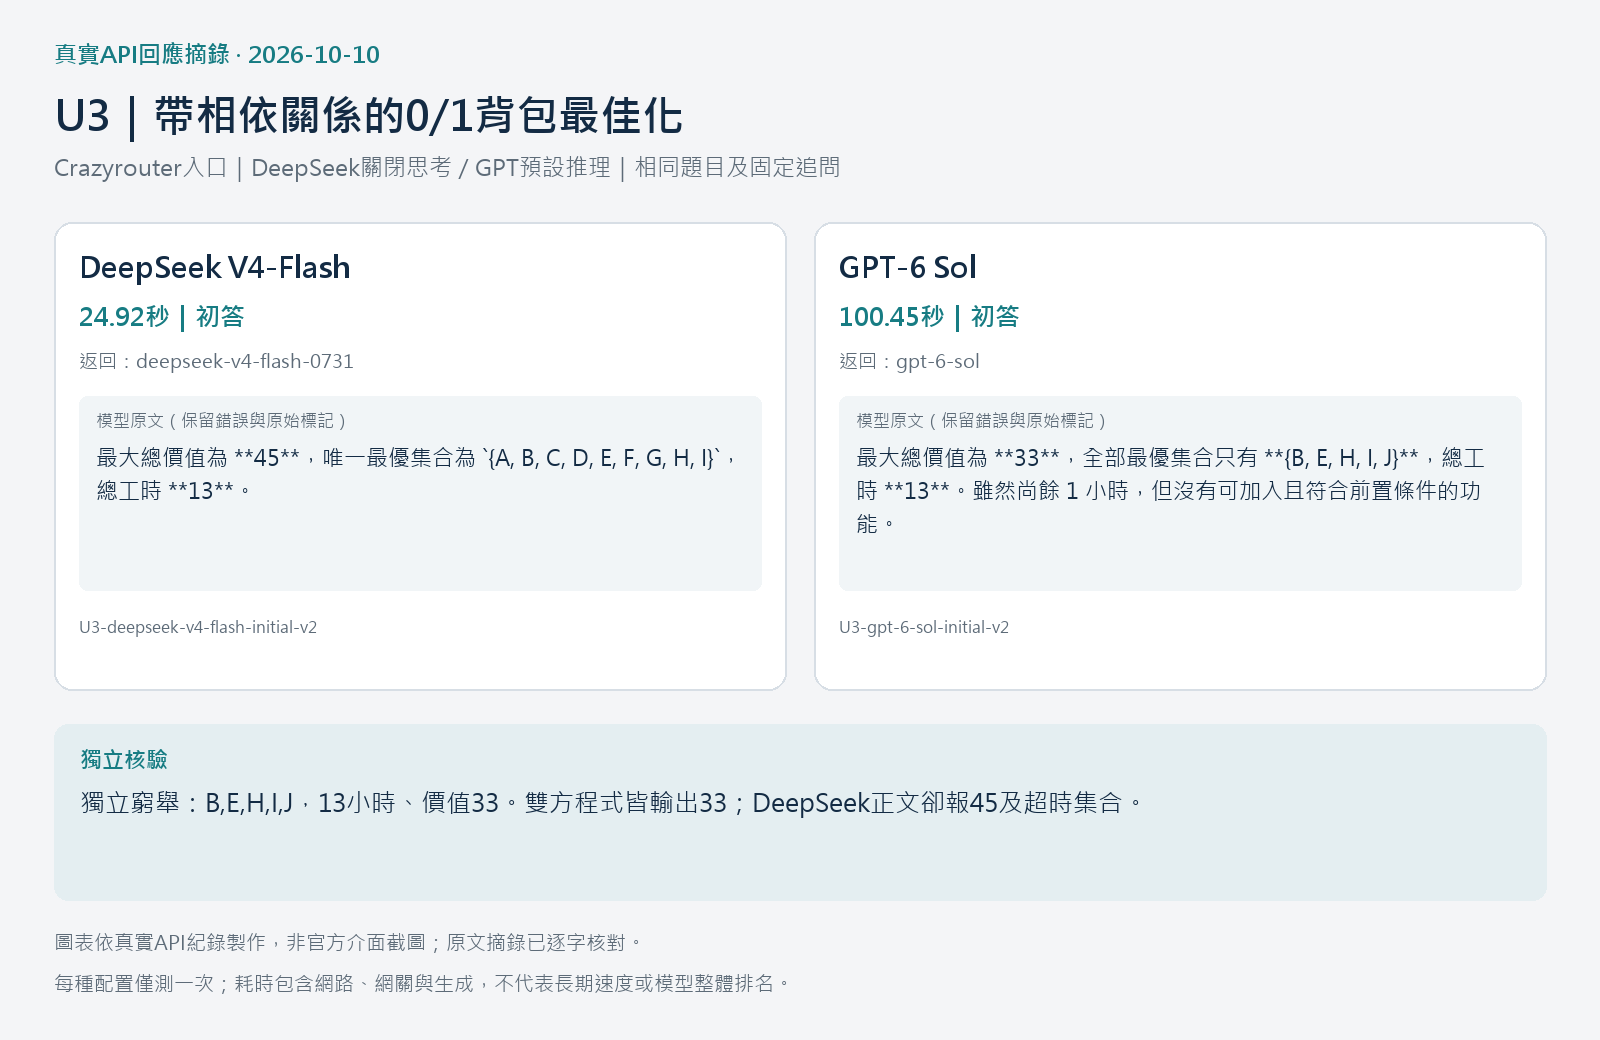
題目有10項不可分割功能,各自包含工時、價值與前置需求。例如F必須同時選C與D,J必須選I,而I又必須選B與H。上限為14小時,不能重複計算共同前置,也不能刪除前置要求。
完整枚舉1,024個子集合後,唯一最優集合為{B,E,H,I,J},工時13、價值33。
DeepSeek正文卻報出{A,B,C,D,E,F,G,H,I},聲稱工時13、價值45。實際加總為工時27、價值78,已超出限制。把它附上的Python程式真正執行後,卻得到正確的價值33。GPT的正文與程式都給出正確集合。
追問將上限改為12小時,並禁止D。新的唯一最優集合為{B,E,G,H},價值30,雙方都找到。但DeepSeek文字誤稱C依賴D;原題中C只依賴A,受到D禁用影響的是F。它的程式依賴表仍是正確的。
用AI做專題範圍規劃時,應核對集合是否符合限制,再核對價值;不能直接採用模型正文的「最優方案」。
這題同時限制庫存容量、採購預算與整數進貨量,計入售價、滯銷殘值及缺貨罰損,再最大化「期望利潤−風險權重×CVaR」。CVaR依題目公式計算最差10%的損失,不能任意把所有大於或等於VaR的情境一起平均。
| 條件 | 正確庫存(qA,qB) | 期望利潤 | CVaR | 目標值 |
|---|---|---|---|---|
| 預算30、風險權重0.5 | (5,6) | 33.225 | 5.5 | 30.475 |
| 預算24、風險權重1 | (5,4) | 30.375 | 2.5 | 27.875 |
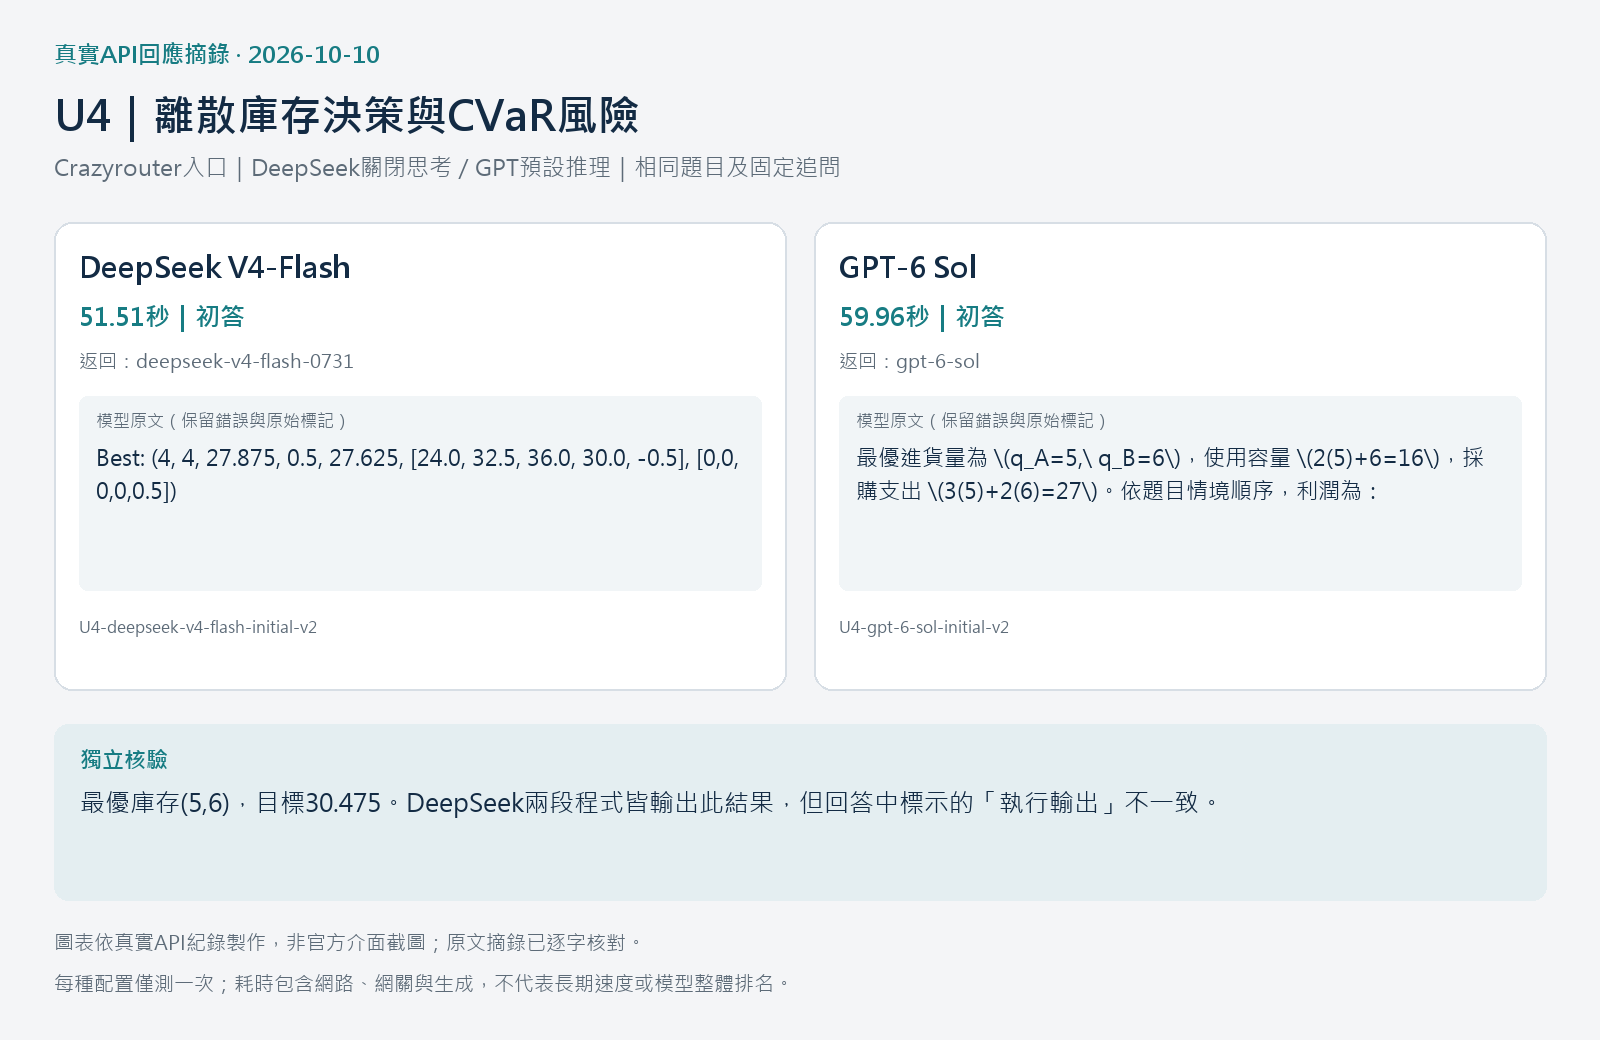
原方案五種情境利潤依序為[19,37.5,44,48,-5.5]。GPT的主要數值與枚舉結果一致。DeepSeek正文與標示的「執行輸出」卻寫成庫存(4,4)、目標27.625。
實際執行DeepSeek提供的兩段程式,兩段都輸出正確的(5,6)與30.475。這表示附上的文字輸出不能當成程式已被執行的證據。
條件變更後,DeepSeek出現正確的新庫存(5,4)與27.875,但仍把原最優方案記成(4,4),且回應達上限截斷。GPT的主要變更結果與獨立核對一致。
模擬工廠最大化40x+30y,限制為2x+y≤b、x+2y≤80、x≤45及非負產量。題目要求完整對偶、最優性證明與影子價格有效區間,接著新增整數限制。
| 情境 | 正確最優解(x,y) | 目標值 |
|---|---|---|
| b=100,連續產量 | (40,20) | 2200 |
| b=106,連續產量 | (44,18) | 2300 |
| b=110,連續產量 | (45,17.5) | 2325 |
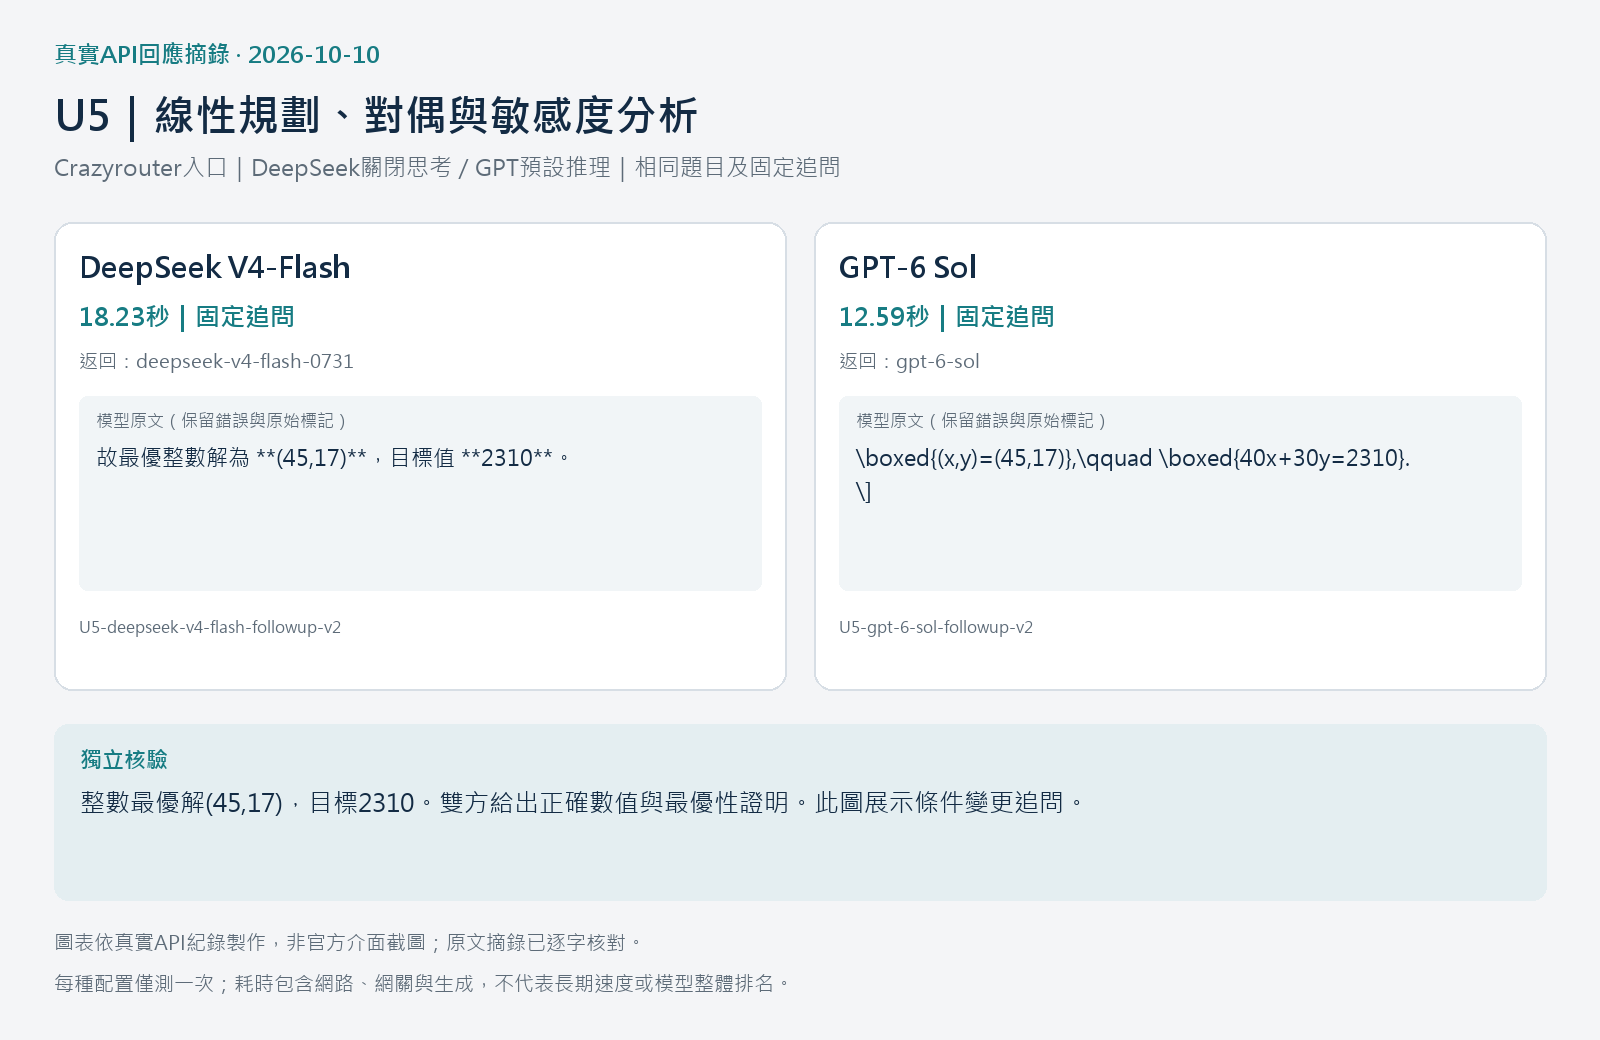
| b=110,整數產量 | (45,17) | 2310 |
雙方都得到上述主要結果,也找到目前基底保持可行的區間b∈[40,107.5]。原對偶解為(50/3,20/3,0);超過107.5後,不能繼續使用原影子價格線性外推。
GPT的論證較集中。DeepSeek包含較多試錯文字,部分互補鬆弛用語不精確,也把17.5向下取整稱為「四捨五入」。這些需要編修,但不應把用語問題誇大成最優數值錯誤。
最後一題是模擬事件資料:訂單與退款按最大修訂版去重,同一最大修訂版的內容衝突須隔離;UTC時間換算為Asia/Shanghai後,計算2026年10月收入與退款。退款沿用原訂單匯率,缺失成本不能補成零。
其中B訂單在9月付款,10月才發生退款。它不屬於10月收入,但本月退款仍須扣除。
| 月結項目 | 初始正確結果 | 修訂訂單與補齊成本後 |
|---|---|---|
| 收入 | 1830 | 1970 |
| 退款 | 220 | 710 |
| 淨收入 | 1610 | 1260 |
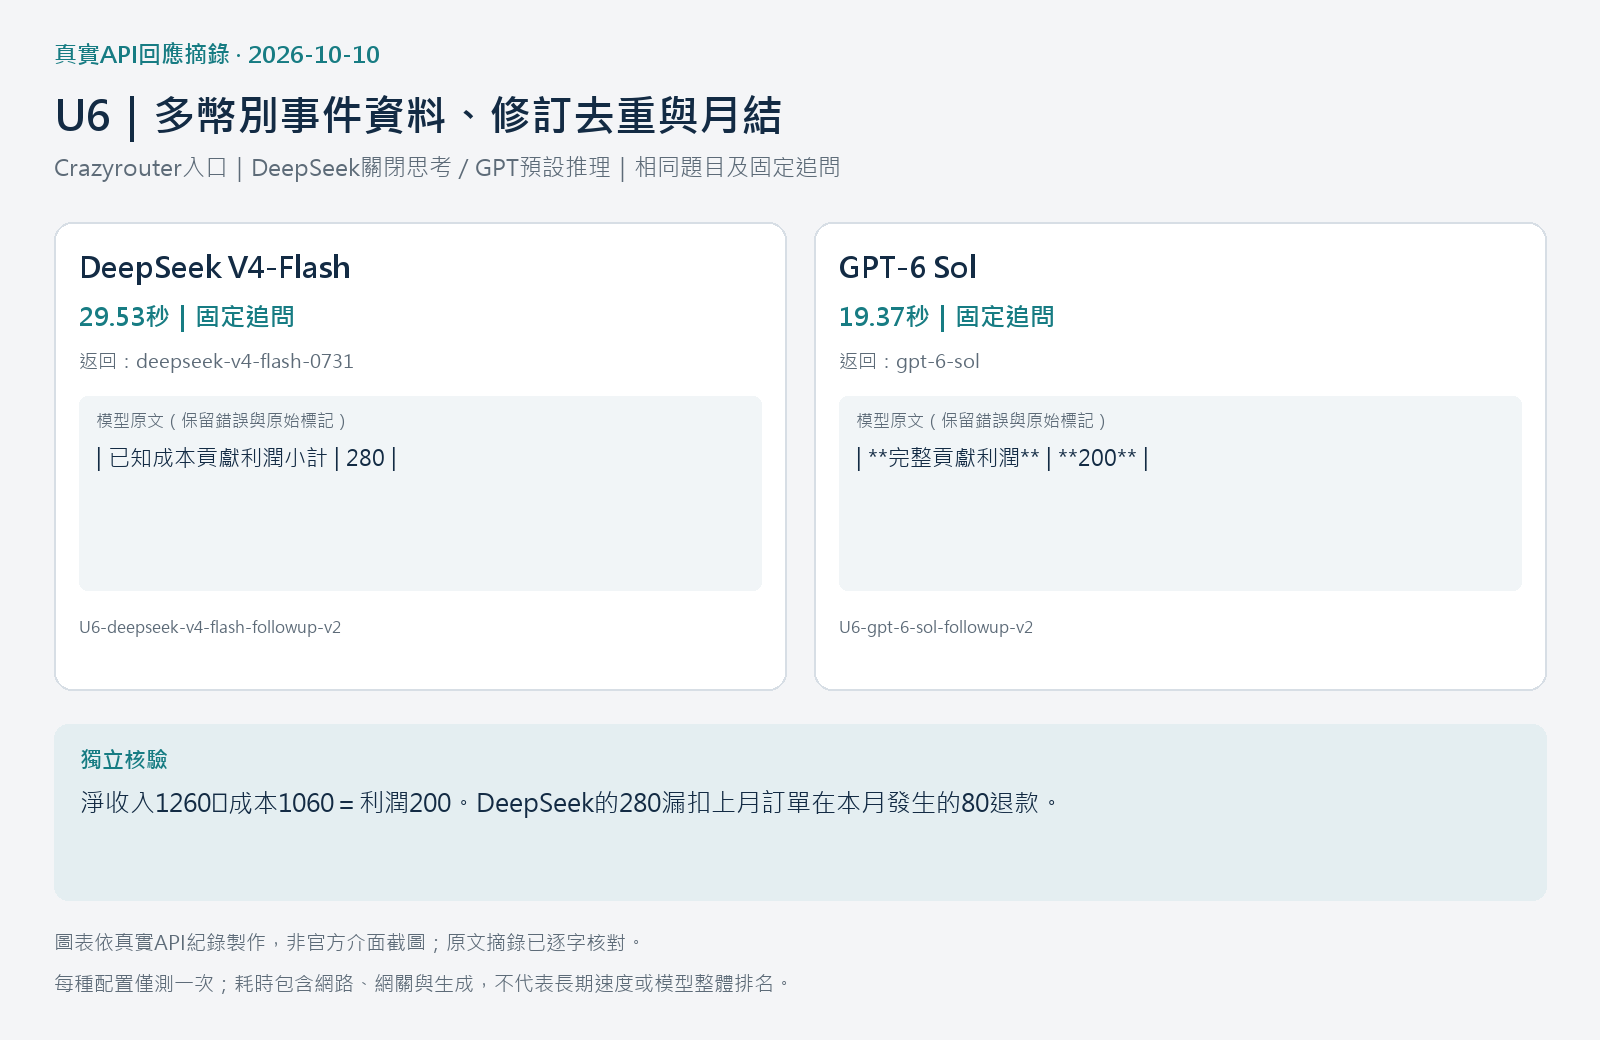
| 利潤 | 已知成本貢獻利潤小計490 | 完整貢獻利潤200 |
| 未知成本收入 | 210 | 0 |
以上金額均為題目的模擬業務數據。
兩邊初答的收入、退款與淨收入都正確,但DeepSeek把已知成本利潤寫成570,漏扣B的80退款;GPT得到490。實際執行初答程式時,DeepSeek也印出570,並在它自行加入的取消訂單隔離斷言處失敗。GPT程式得到490,且通過自帶斷言。取消訂單本身不認列收入,不能把DeepSeek的斷言當作題目要求。
追問新增D的最新修訂版與G的成本。D金額提高後,先前超限的RD退款變為有效,因此必須重新判定整份資料,不能只把訂單差額加到舊總表。正確完整利潤為1260−1060=200;GPT得到200,DeepSeek得到280,再次漏掉相同的80跨月退款。
這類錯誤特別容易藏在看似正確的總表裡。收入與淨收入正確,並不代表利潤口徑也正確。
| 使用需求 | 本次結果支持的選擇 | 交付前要做的事 |
|---|---|---|
| 大學數值分析、統計與演算法作業 | 本次配置下優先試GPT,主要數值與解釋較一致 | 自己重算,檢查假設與證明,避免直接提交AI答案 |
| 整理思路或取得可自行驗證的程式草稿 | DeepSeek關閉思考可列入候選,初答中位數較短,部分程式正確 | 執行程式,逐項比對正文結論 |
| 庫存、資源配置與條件變更分析 | 本次配置下優先試GPT,原方案與新方案較一致 | 以枚舉或求解器確認可行性與最優性 |
| 多幣別月結與業務資料處理 | 本次GPT較完整維持題目口徑 | 納入跨月、退款、修訂衝突與缺失成本的測試案例 |
DeepSeek在U2、U5的主要數值都正確,U1、U3、U4也提供了能得到正確初答結果的程式。因此,選型不宜只貼上「能用」或「不能用」的標籤;更實際的問題是,你是否具備驗證工具,以及正文出錯時會不會被直接帶進交付物。
本次沒有量測人類查核與編修工時,也沒有測試論文原文引用、文件上傳、搜尋或完整辦公軟體流程。較短的API等待時間,不能直接換算成較快完成作業或工作。
若把AI導入固定流程,可以保留三個交付欄位:正文結論、實際程式輸出、獨立核對值。三者一致,才進入報告或決策文件。
2026年10月10日查詢Crazyrouter公開資料時,GPT-6 Sol的discount及預設群組折扣欄位均為0.65,DeepSeek V4-Flash均為1;前者可理解為該入口當時公開標示的六五折係數,後者未標示相同折扣。DeepSeek另採時段分級規則,不能只看單一係數就認定所有時段條件相同。這些欄位不等於個別帳號的結算承諾,也不是官方訂閱方案優惠,適用條件以Crazyrouter模型優惠說明及帳號實際規則為準。
本次使用模擬題目,未進行服務隱私或安全稽核。真實學生資料、未公開研究、客戶名單與財務紀錄,應先確認組織允許的使用入口,以及資料保存、訓練用途、存取權限和第三方處理政策。模型把題目算對,不能取代這些確認。
不能這樣推論。這次DeepSeek關閉思考、GPT保留預設推理,每題也只測一次。可支持的結論是:在本次配置與題目中,DeepSeek初答耗時中位數較短,GPT主要數值與解釋較一致。
不代表。U1、U3、U4的DeepSeek程式實際產生正確結果,正文卻有錯。模型標示的「執行輸出」也須透過真正執行確認。
還不能。把自己常見且可核對答案的任務整理成小題組,保留例外情況與條件變更,再比較完整交付品質。這六題提供的是驗證方法與本次觀察,沒有涵蓋所有學習與工作需求。
本文使用AI協助撰寫。

 18924485322

 iThome鐵人賽
 看影片追技術