
上一篇把網站放到 Cloudflare 了。不過,網站不只有首頁。拿 口袋單字王 來說:按一下要播語音,登入後的模擬測驗還要保存紀錄。這些東西放哪裡?
如果把網站想成一家店,可以先分成三個角色:Worker 負責處理請求,R2 放檔案,D1 放一筆筆資料。 同樣叫「儲存」,音檔和測驗紀錄其實很不一樣。
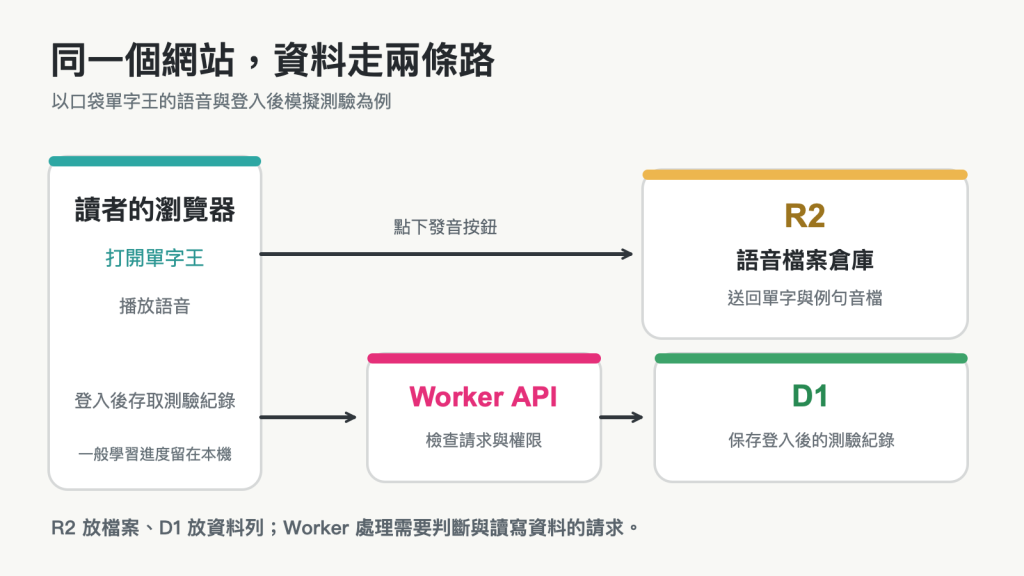
這張是「服務分工」概念圖,不是每一次網路請求的實際路由。口袋單字王的語音已放在 R2;至於瀏覽器是直接取得檔案,還是透過其他路由,會依網站部署設定而不同。
單字發音和例句語音是檔案。你可以想成店裡一箱箱商品:每個檔案有自己的名稱或路徑,網站需要時再去取。R2 就是 Cloudflare 提供的物件儲存服務,除了音檔,也常用來放圖片、影片或使用者上傳的檔案。它不是拿來查「某位使用者考了幾分」的那種資料表。(參考來源:Cloudflare Developers,R2 Overview;Public Buckets;R2 Pricing)
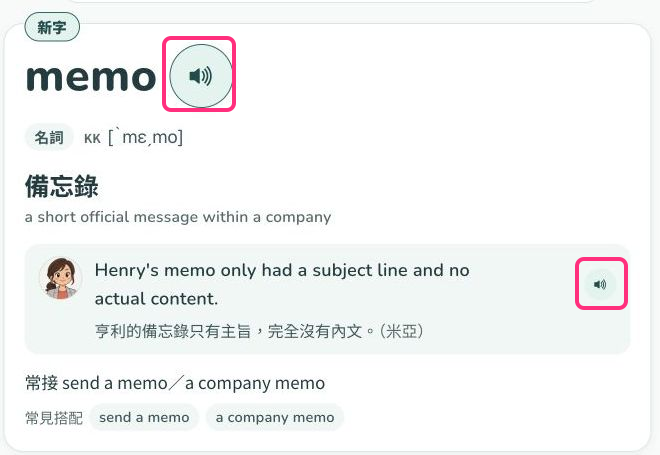
口袋單字王現在的語音就已經放在 R2。下面的網站畫面,我框了單字和例句的播放按鈕;你按的是網站上的按鈕,背後取用的則是語音檔。後面的 Cloudflare 畫面則是 R2 服務的入口示範,不是公開展示口袋單字王的音檔清單。

R2 的貯體預設不會直接公開在網路上。若要讓瀏覽器用網址播放音檔,還需要設定公開存取方式,例如自訂網域;另一種做法是由 Worker 讀取後再回傳。光把檔案丟進 R2,網站不會自己找到它。
用量怎麼算?截至這篇整理時,R2 的 Standard 儲存類型每月免費額度包含 10 GB-month 儲存量、100 萬次 A 類操作,以及 1,000 萬次 B 類操作;對網際網路的傳出流量不另收費。白話一點:存多少、上傳或列出幾次、讀取幾次,都要分開看。「傳出流量免費」不等於所有使用都免費;超過額度,或改用其他儲存類型,費用規則會不同。數字以你部署當下的官方頁面為準。
測驗紀錄不是一個個要播放的檔案。它更像帳本裡的一列:哪位使用者、哪次測驗、分數多少、何時完成。之後還會想查「我的歷史成績」。這種有欄位、會查詢和更新的資料,D1 會比把所有東西塞進一個 JSON 檔好管理。D1 是 Cloudflare 的 SQL 資料庫服務。(參考來源:Cloudflare Developers,D1 Overview;D1 Pricing;D1 Limits;Workers Pricing)
這裡有個容易誤會的地方:口袋單字王的一般學習進度留在瀏覽器,不會上傳;登入後的多益模擬測驗成績才存在帳號裡。 不要看到「有進度」就以為每一筆都進了 D1。
我在 Cloudflare 後台看到 vocab 這個 Worker 綁了 DB → vocab,也就是它有一個名為 DB 的 D1 綁定。下面只截服務入口和綁定關係,不打開任何使用者資料。
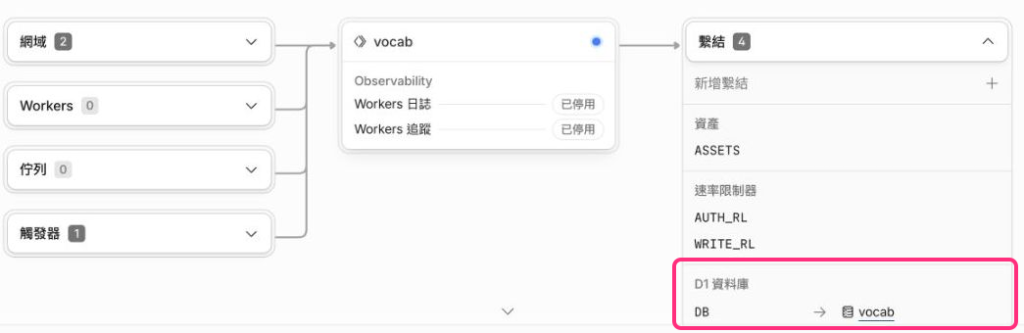
D1 的免費額度,不能只看「查詢次數」。目前 Workers Free 方案是每天 500 萬列讀取、10 萬列寫入;帳號總儲存量上限為 5 GB,而單一免費方案資料庫最多 500 MB。假設某個查詢掃過很多列,就算只回傳幾筆結果,讀取量也可能比較高。先把它當成提醒:資料表越大,越要注意查詢方式。實際限制與價格仍以官方頁面為準。
前端想保存登入後的測驗成績,通常不該直接把資料庫打開給所有瀏覽器。請求會先到 Worker:它可以檢查身分、確認資料格式,再決定要不要把紀錄寫進 D1,或從 D1 查回來。你可以把它想成店員,不能讓每個客人自己翻帳本。
Worker 也可以提供網站檔案;畫面裡的 ASSETS 就是靜態資源綁定。不過不是每個網頁或音檔請求都一定會執行你寫的 Worker 程式,實際路由要看設定。Workers Free 目前提供每天 10 萬次 Worker 請求;一般靜態資源請求另有不同計算方式,所以估算用量時要分清楚。
Wrangler 是 Cloudflare 的命令列工具。後台可以點選服務,專案裡則常用 wrangler.jsonc 記下設定。先建立 D1 資料庫和 R2 貯體,再把它們「接」到 Worker;建立資源與部署網站是兩件不同的事。下面是示意名稱,不是口袋單字王的正式設定,也不是叫你照抄 ID。(參考來源:Cloudflare Developers,Wrangler Configuration;D1 Get Started;R2 CLI)
npx wrangler d1 create my-records
npx wrangler r2 bucket create my-audio
建立 D1 後,把指令回傳的 database_id 填進專案的設定檔。若 Worker 需要直接讀取私有 R2 貯體,也加上 r2_buckets 綁定;如果音檔是透過公開的 R2 網址提供給瀏覽器,則不一定要替這個 Worker 加 R2 綁定。這也解釋了為什麼在 Worker 畫面看不到 R2 綁定,不能直接推論「語音不在 R2」。
{
  "name": "my-vocab",
  "main": "src/index.ts",
  "compatibility_date": "2026-10-03",
  "assets": { "directory": "./dist", "binding": "ASSETS" },
  "d1_databases": [
    {
      "binding": "DB",
      "database_name": "my-records",
      "database_id": "<建立 D1 後取得的 ID>"
    }
  ],
  "r2_buckets": [
    { "binding": "AUDIO", "bucket_name": "my-audio" }
  ]
}
上面的 DB、AUDIO 就是程式裡使用的名稱,例如 env.DB 和 env.AUDIO。不是設定檔一加就會自動生出測驗功能;你還要寫程式、建立資料表,以及處理誰能讀寫哪些資料。r2_buckets 那段是需要 Worker 直接存取 R2 時才加的可選例子。
這份設定是假設專案已有 src/index.ts,前端也已建置出 dist;如果檔案根本不存在,Wrangler 當然跑不起來。設定完,可以先用 npx wrangler dev 在本機測試。Wrangler 預設的本機開發模式會使用本機的 D1/R2 資料,不會因為你測試一下就直接改到正式資料;但如果你刻意改用遠端模式或執行帶有 --remote 的指令,情況就不同了。確認清楚再做。等本機測試沒問題,真的要上線時,才執行 npx wrangler deploy。
看到 Worker、R2、D1 和一大串設定,不用自己一次寫完。AI 很適合先幫忙看現有專案、拆小工作、寫第一版程式,再陪你測試。但要先把資料的去向說清楚,不然它可能很勤勞地幫你加一個其實不需要的資料庫。
以口袋單字王這樣的功能為例,可以一項一項請 AI 處理:
| 這一塊 | 可以請 AI 協助什麼 | 自己要確認什麼 |
|---|---|---|
| R2 語音 | 找出播放按鈕怎麼取得音檔,整理檔名、路徑與讀取失敗時的提示 | 按鈕真的播得出聲音;沒有把不該公開的檔案公開 |
| D1 紀錄 | 設計測驗紀錄的欄位,寫入與查詢程式,準備假的測試資料 | 登入後只看得到自己的紀錄;一般學習進度仍留在瀏覽器 |
| Worker API | 串起前端請求與 D1,檢查身分、輸入內容和錯誤處理 | 沒登入時不能存取紀錄;錯誤時不會把資料庫細節直接露給訪客 |
第一輪,我會先請它讀程式、說明打算怎麼做,不要立刻碰正式資料:
請先讀這個專案的程式與 wrangler.jsonc,整理目前的資料流。
語音檔已放在 R2;一般背單字進度只留在瀏覽器;登入後的模擬測驗紀錄使用 D1。
如果程式與文件寫的不一樣,請標出你在程式裡實際找到的內容,不要直接照舊文件猜。

這一輪先規劃「保存一筆登入後的模擬測驗紀錄」。
請列出需要改的前端、Worker、資料表,以及本機要怎麼測試。
先不要修改線上設定、寫入正式 D1 或部署;等我確認後再實作。
確認方向後,再讓 AI 一小段一小段做,並用假資料在本機測:存一筆、查回來、換另一組測試身分,看看會不會讀到不屬於他的紀錄。它可以幫你跑測試、整理錯誤,但涉及正式 D1 資料、R2 公開權限或真正部署時,還是要停下來看它準備改哪裡。AI 寫得快很好,資料跑錯地方就不太好笑了。😅
第一次接這些服務,不需要一次把完整單字網站做出來。先問自己:我要存的是檔案、一筆筆可查詢的紀錄,還是要處理一個請求? 檔案想 R2,紀錄想 D1,判斷與 API 想 Worker。這樣拆開,AI 幫你寫設定時,你才看得出它接錯哪條線。🙂
文章同步發表於 https://book.casper.tw/it2026/cloudflare-workers-r2-d1


 iThome鐵人賽
 看影片追技術