
昨天學會查指標了,但都是在正常狀態下查,看到的都是一片平靜。今天要故意製造一次事故,看它在指標上長什麼樣子
重做 Day 17 那個,讓 Container 一啟動就死。改 deployment.yaml,加回那行
command: ["sh", "-c", "echo starting; sleep 2; exit 1"]
套用之前先把 Prometheus 的頁面開著,等一下要對照
kubectl apply -f manifests/base
kubectl get pods -n ithome-lab
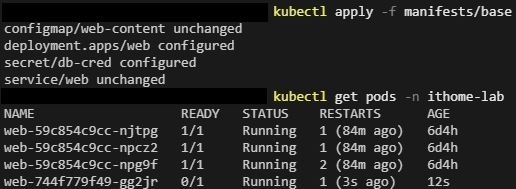
然後回到 Prometheus,等個幾分鐘讓資料累積
increase(kube_pod_container_status_restarts_total{namespace="ithome-lab"}[10m])
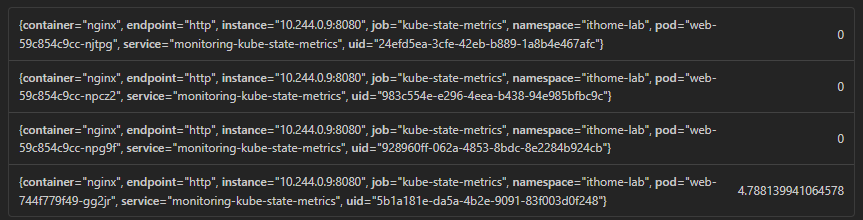
有東西了。昨天查同一行的時候整排都是 0,現在有一列不是
點上面的 Graph 分頁可以看曲線,會看到它從 0 開始一路往上爬
順便查一下死因
kube_pod_container_status_last_terminated_reason{namespace="ithome-lab"}

Error 代表非零的結束代碼,跟 Day 17 那個 Exit Code 1 對得上。如果做的是 Day 21 那個記憶體實驗,這裡會顯示 OOMKilled
前面的流程都是從 kubectl get pods 開始。但我已經知道要看 ithome-lab 這個 namespace。真實情況可能是叢集裡有幾十個 namespace、幾百個 Pod,而我收到的資訊只有使用者說某個功能怪怪的
指標的用途就在這裡。它可以一次涵蓋所有東西
increase(kube_pod_container_status_restarts_total[10m]) > 0

這行沒有指定 namespace,最後那個大於 0 是過濾條件。它回答的問題是「整個叢集裡現在有什麼東西不對勁」,這是 kubectl 做不到的,kubectl 你得先知道要看哪裡
所以兩邊的分工大概是這樣。指標負責發現,它掃得廣,能在我還不知道哪裡壞的時候指出方向;kubectl 負責診斷,它挖得深,Events、log、Last State 這些細節指標裡面沒有
反過來也成立。光看指標我只知道某個 Pod 在重啟,永遠不會知道它為什麼重啟,答案還是得靠指令去挖
Events 預設只留一小時,昨天發生的事今天什麼都查不到。但指標是存下來的時間序列,可以往回看很久,這對「這個問題是什麼時候開始的」這種問題特別有用
實驗做完把 command 拿掉
kubectl apply -f manifests/base
kubectl rollout status deployment/web -n ithome-lab
ok明天見 :D


 iThome鐵人賽
 看影片追技術