
今天把雲之島夥伴們放進同一座島,先看 Kubernetes 叢集由哪些部分組成,再沿著五條常見流程走一遍。
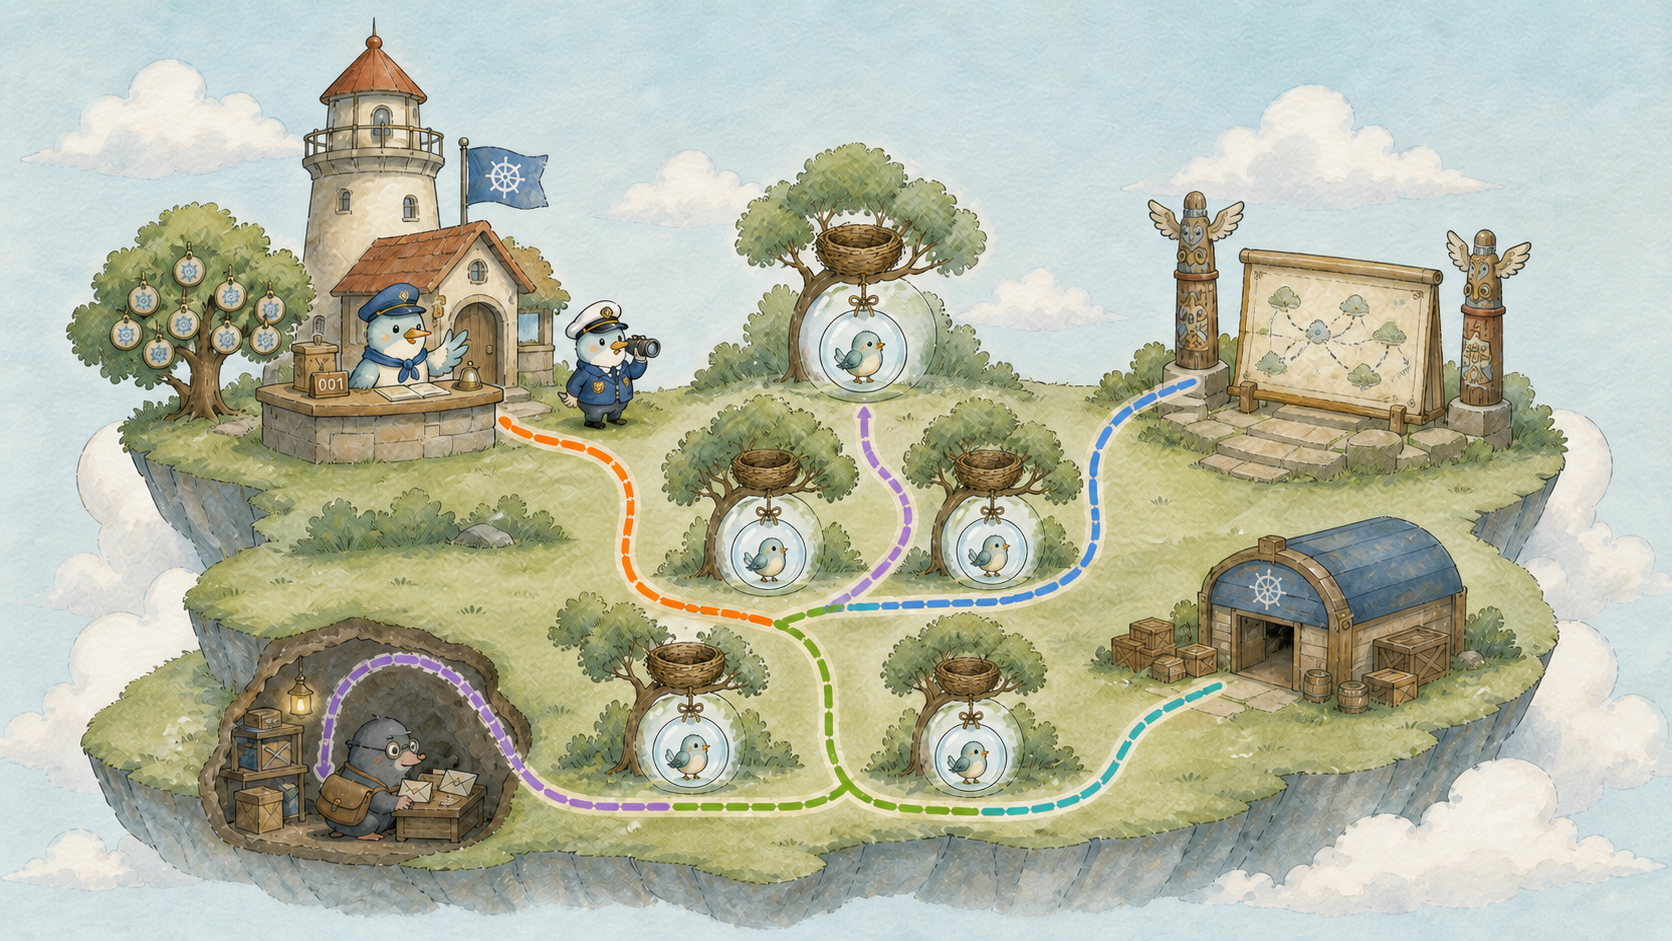
① 左上燈塔村(控制平面 / Control Plane)
燈塔櫃台(API Server):提供對外的 Kubernetes API 唯一存取入口。
記憶樹(etcd):高可用分散式資料庫,持久化保存叢集所有狀態資料。
選樹官(Scheduler):依據資源演算法,替尚未排程的 Pod 指派合適的 Node。
巡邏隊長(Controller Manager):驅動各類調和控制器,持續維持期望狀態。
② 島中央巢樹(工作節點 / Node)
管家松鼠(kubelet):接收控制面指令,掌管節點生命週期。
容器執行階段(Runtime):負責實際拉取映像檔並啟動容器。
工作負載主體:由泡泡 Pod 及其內部運行的小鳥 Container 組成。
外掛擴充機制:配置容器網路(CNI)指派 IP 與路由,透過容器儲存介面(CSI)掛載磁區;部署方式依各叢集架構彈性組合。
③ 右側出入口與通路(網路與服務抽象)
大門地圖看板(Ingress)與守門員(Ingress Controller):看板定義 HTTP/HTTPS 路由規則,實際由守門員反向代理分發請求。
圖騰柱(Service)與名單切片(EndpointSlice):柱子提供穩定的虛擬服務入口,後端健康的泡泡清單由名單切片精確記錄。
道路管理員(kube-proxy):主流的 Service 資料平面轉發工具;特定進階 CNI 亦可由專屬資料平面直接接管。
④ 地面儲存區(持久化儲存 / Storage)
倉庫(PersistentVolume,PV):代表叢集可供配置的持久化儲存實體,生命週期獨立於節點與容器。
借用單(PersistentVolumeClaim,PVC):工作負載通常透過 PVC,請求並使用綁定至相應的倉庫 PV。
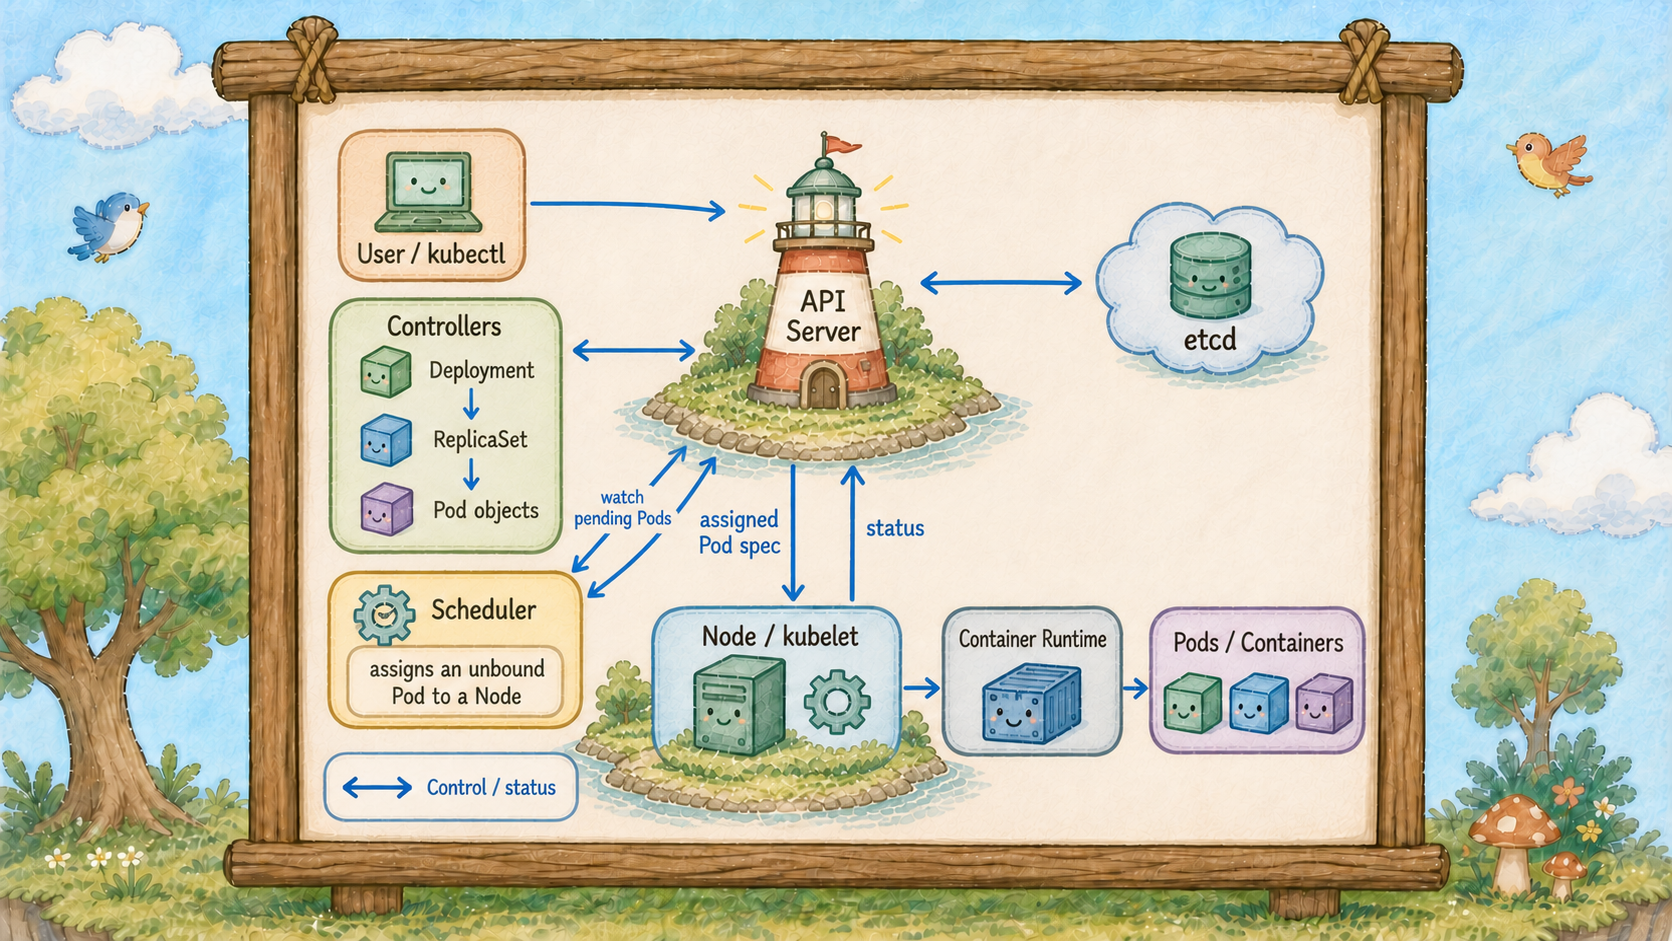
藍色箭頭表示元件透過 API Server 協作;kubelet 依已排程的 Pod 規格呼叫 Runtime,建立容器。
期望狀態如何經控制面調和並在 Node 執行?
吹哨子(kubectl)向燈塔櫃台(API Server)送出請求。
API Server 驗證並接受請求後,會將物件資料保存到記憶樹(etcd),再回覆請求結果。
看到 created 或 configured,代表 API 請求已成功,不代表 Pod 已經建立或應用程式已可服務。
這就是宣告式管理:使用者描述期望狀態,之後由控制器持續嘗試讓目前狀態接近期望狀態。
控制器透過 API Server 觀察它負責的物件,並在期望狀態與目前狀態有差異時建立或更新物件。
以三個副本 Deployment 為例:Deployment controller 建立或更新 ReplicaSet;ReplicaSet controller 建立或刪除 Pod,讓數量符合設定。
新建的 Pod 尚未指定 Node 時,Scheduler 會依資源需求(Requests)、限制條件與排程規則挑選合適的 Node,並將排程結果寫回 API。
被排程的 Pod 由目標 Node 上的管家松鼠(kubelet)負責。
kubelet 依 Pod 規格呼叫容器執行階段(Runtime),完成映像檔拉取以及容器的建立和管理;也會執行所設定的探針並回報 Pod 狀態。
一般情況下,Pod 是否 Ready 不只看一個容器:其中的容器都必須就緒,且其他就緒條件(若有設定)也要符合,才會被 Service 視為可接收流量。publishNotReadyAddresses 等設定可改變端點就緒狀態的處理方式。控制面暫時故障時,Node 上已執行的容器通常不會立刻停止;但控制平面無法正常工作期間,Cluster 可能無法排程新 Pod、調和工作負載或更新狀態。
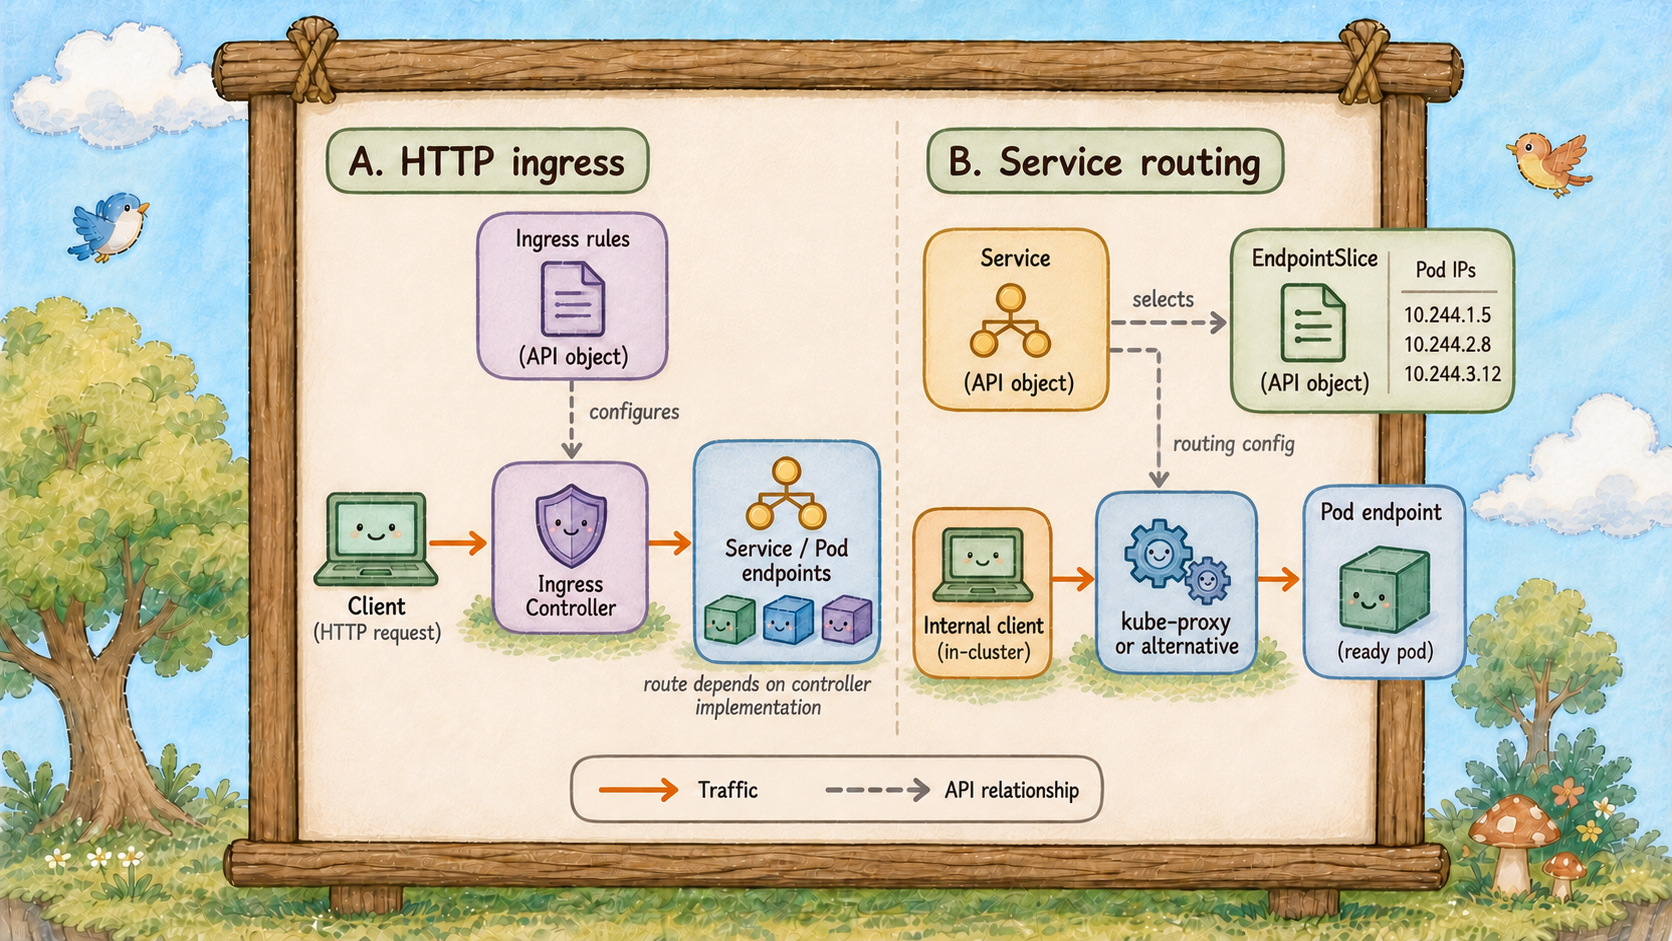
分開呈現 Ingress 與 Service 的流量關係。橘色箭頭表示封包流量;灰色虛線表示 API 資源關係。Service 對應的 EndpointSlice 提供後端端點資訊,資料平面依此轉送;Ingress Controller 的後端連線方式依實作而異。
Service controller 依 Service selector 找出符合條件的 Pod,並更新 EndpointSlice。Service 資料平面依 Service 與 EndpointSlice 設定,把送往 Service 的流量轉到後端 Pod。常見實作是 kube-proxy;有些叢集使用其他資料平面。
Ingress 是 HTTP/HTTPS 路由規則,Ingress Controller 才負責接收並處理流量。Controller 會依規則將請求導向指定後端;它連到後端的實際路徑取決於實作,不一定經過 Service 的 ClusterIP。Day 18 的圖示呈現的是一種簡化路徑。
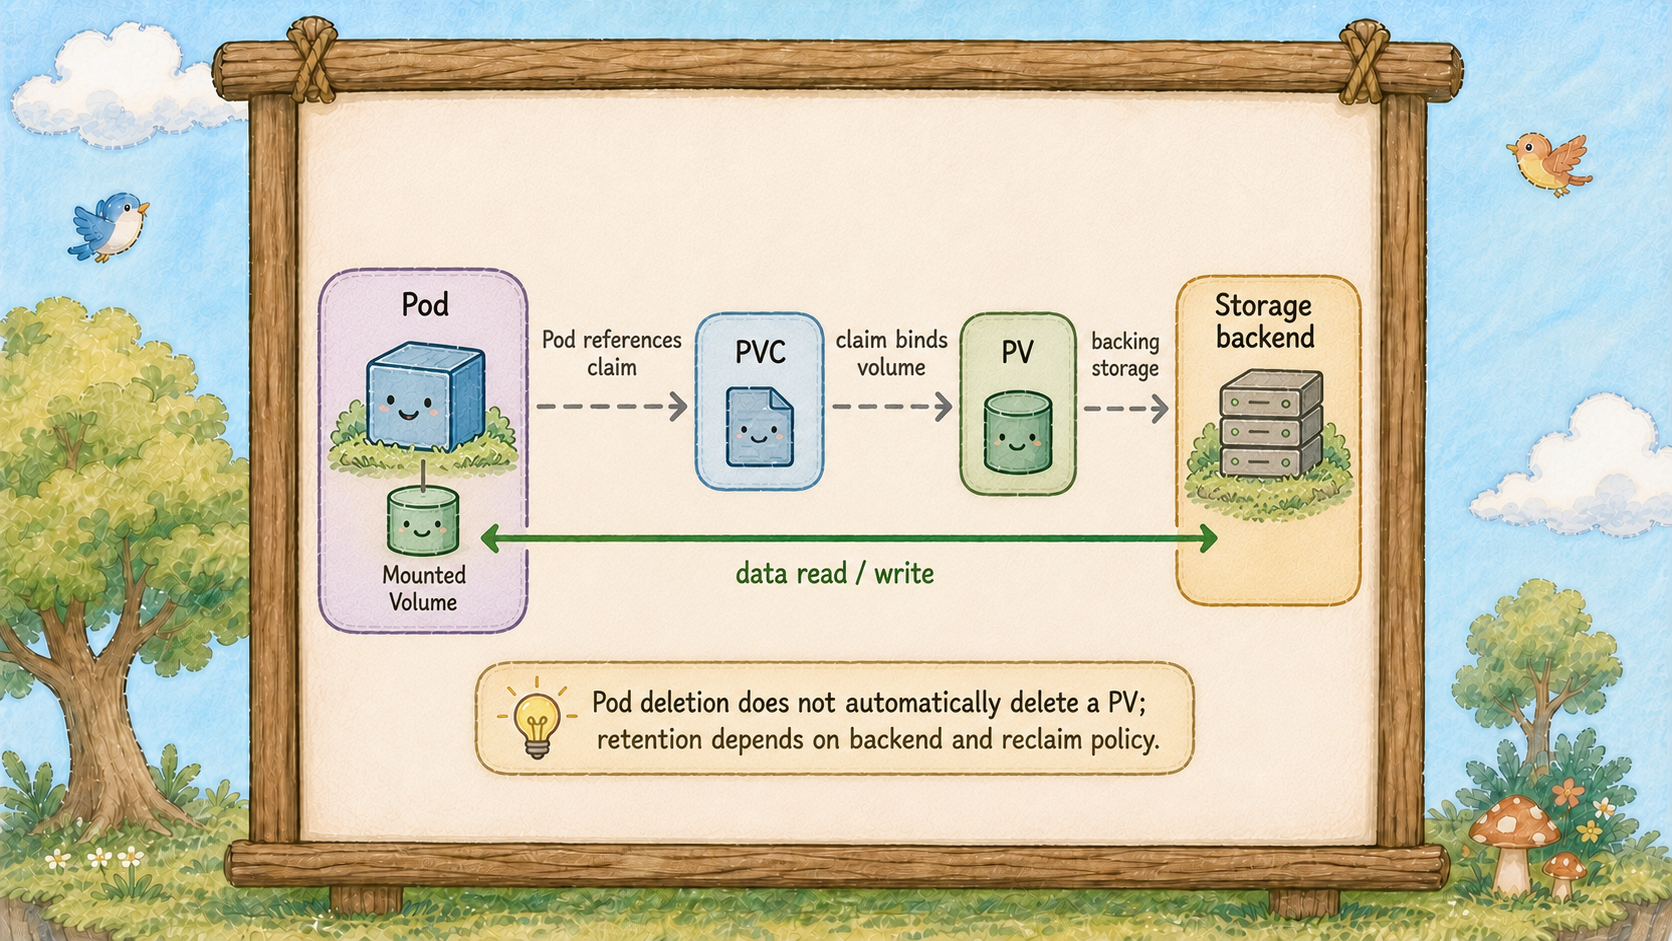
PVC/PV 的資源關係和實際資料讀寫:灰色虛線表示 Pod 引用 PVC、PVC 綁定 PV,以及 PV 對應底層儲存;綠色雙向箭頭表示 Pod 對掛載 volume 的資料讀寫。
容器可寫入自己的可寫入層,也可使用 Pod volume。
容器重啟時,其可寫入層的資料不應視為可靠的持久資料;emptyDir 可在同一 Pod 中供容器共享,並在容器重啟期間保留,但 Pod 被移除後,emptyDir 也會隨之刪除。
需要跨 Pod 保留的資料時,工作負載可透過 PVC 使用 PV。PV 的生命週期獨立於單一 Pod,因此刪除 Pod 不會自動刪除 PV;資料是否仍保留,還取決於實際儲存後端及 PV 的回收策略。
五條流程可以先記成:提交期望狀態、控制器調和、Node 執行、資料平面轉送、持久卷保存資料。
Kubernetes 是由多個獨立元件與控制迴圈透過 API 緊密協作的分散式系統。
控制器故障會影響它負責的調和工作;Scheduler 故障會讓新的待排程 Pod 無法獲派 Node;Node 或 kubelet 故障會影響該 Node 上的工作負載;網路或儲存外掛故障則會影響各自負責的功能。實際影響取決於故障範圍、叢集配置和應用程式行為。
前面實作「刪掉由 Deployment 管理的 Pod,它會再被補回來」的體驗,就是控制器持續調和的結果。如果直接刪除沒有控制器管理的泡泡 Pod,就不會自動重建。
先列出 kubectl all 集合中的常見資源:
kubectl get all -A -o wide
all 不是叢集所有資源的總表,不會列出 Node、PV 等資源,也不保證列出所有控制面元件。控制面元件是否以 Pod 顯示,取決於叢集部署方式。
再明確查看這系列操作涉及的資源:
kubectl get deploy,rs,pod,svc,ingress,pvc,hpa -A
kubectl get nodes
kubectl get pv
第一行查看各 namespace 的工作負載和服務資源;第二、三行查看叢集層級的 Node 與 PV。資源清單會隨 namespace 和實際操作而不同。
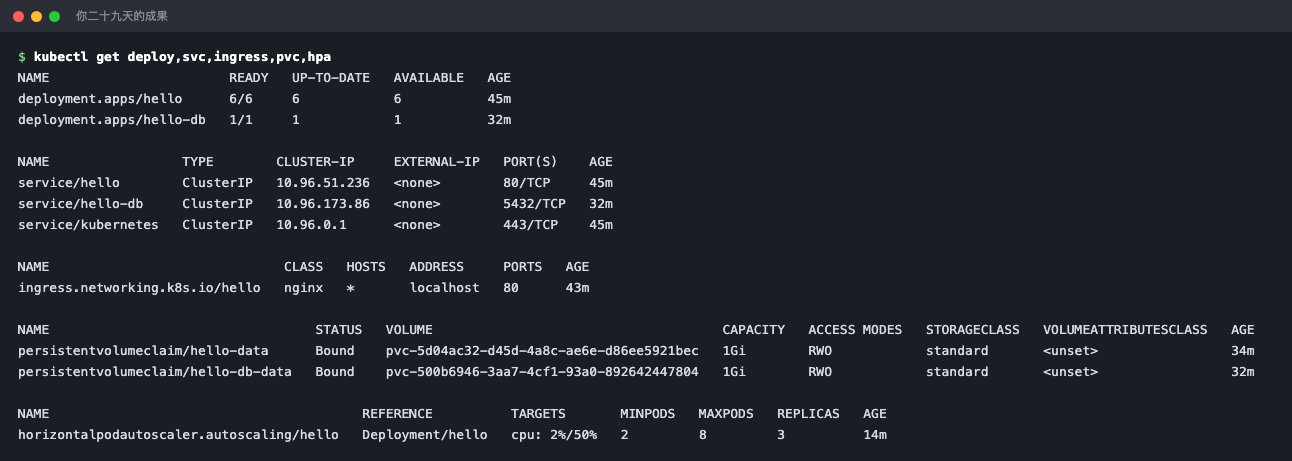
截圖當時,這個教學叢集有兩個 Deployment、三個 Service、一個 Ingress、兩個 PV 和一個 HPA。這是當時環境的數量,不是 Kubernetes 的固定配置。
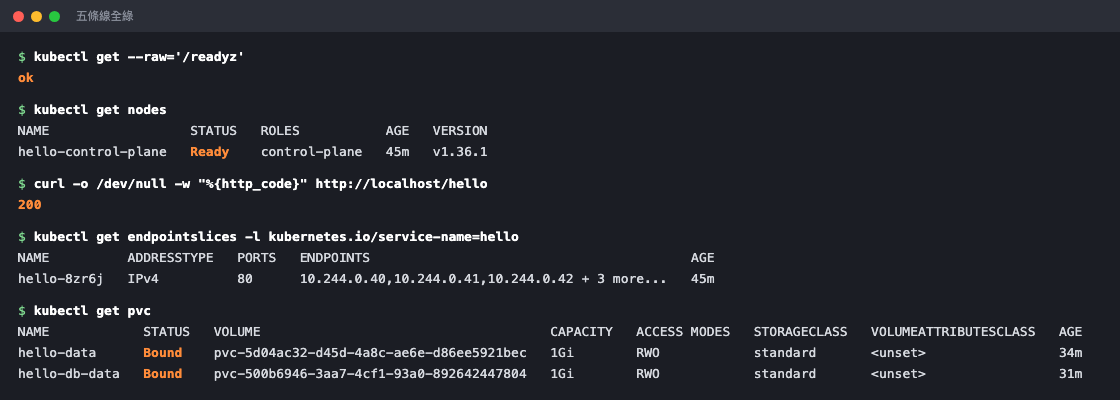
接著快速抽查 API Server、Node、外部入口、Service 後端和儲存配對狀態:
kubectl get --raw='/readyz' && echo
kubectl get nodes
curl -s -o /dev/null -w "外部入口 %{http_code}\n" http://localhost/hello
kubectl get endpointslices -l kubernetes.io/service-name=hello
kubectl get pvc -A
kubectl get pv
預期可看到 API Server readiness 檢查成功、Node 為 Ready、入口回應 200、hello 的 EndpointSlice 有後端,以及 PVC/PV 配對狀態符合預期。Bound 只表示 PVC 與 PV 已配對;如果要確認資料能在 Pod 重建後讀回,還要實際寫入並讀取測試資料。(是快速抽查,不涵蓋所有故障情境)。
Kubernetes 透過 API 物件和多個控制迴圈持續調和狀態,再由 Node、網路與儲存元件執行工作。


 iThome鐵人賽
 看影片追技術