
流量尖峰在半夜三點來,不可能守在電腦前面打 kubectl scale。
而白天沒人的時候,那些閒置的泡泡(Pod)還在燒錢。
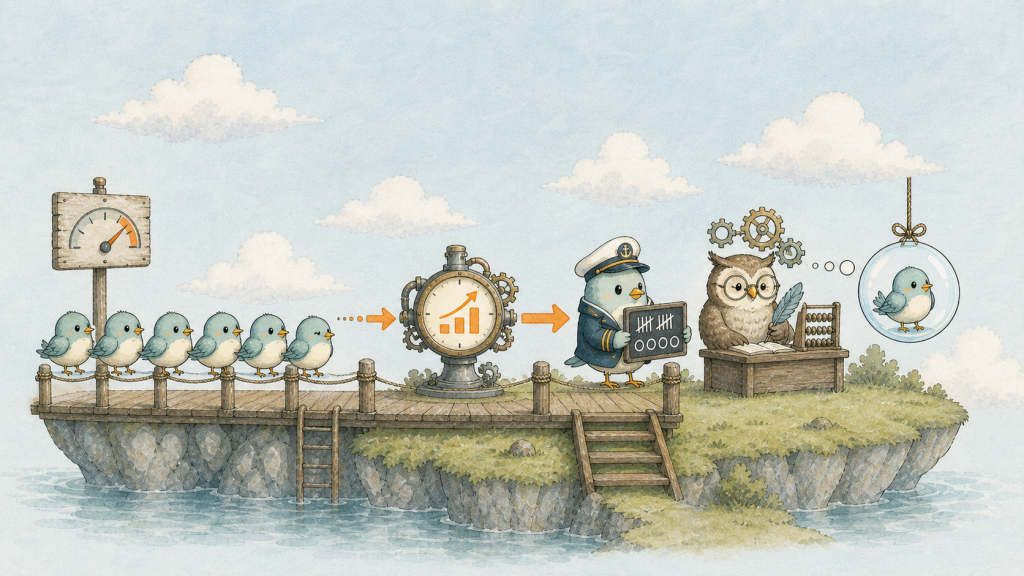
碼頭邊排著長長的人龍,自動調節旋鈕(HPA)把部署管家(Deployment)手上的期望副本數調高,右側的控制器再補出一顆新泡泡(Pod),旋鈕轉的正是期望副本數
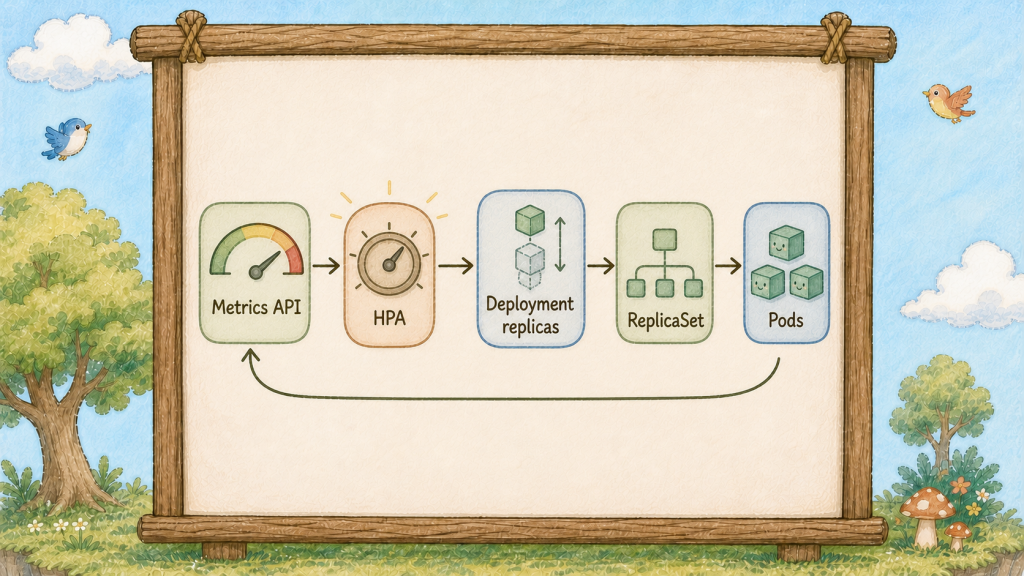
上一篇畫的 Resource Request(資源請求水位線,代表程式跟系統保證需要的最低資源),也有第二個用途。
自動調節旋鈕(HPA)做的事情,是根據指標調整目標工作負載的期望副本數。
它盯著現有 Pod 的資源使用率,跟設定的目標值比一比,修改 Deployment 或 StatefulSet 的 replicas;接著由 ReplicaSet 或 StatefulSet 控制器建立、刪除 Pod。
HPA 不直接建立 Pod。
注意這個關鍵字:使用率。自動調節旋鈕(HPA)算的是這個:
實際用量 ÷ Request = 使用率
,是 Request;Limit 不作為這個公式的分母。
下面那條 Request 線(資源請求),就是自動調節旋鈕(HPA)的計算基準;上面那條 Limit 線(資源上限)不參與計算。
這也帶出一個直接的後果:使用 CPU/記憶體 utilization 指標時,沒設 Request 的泡泡(Pod)通常無法計算使用率,分母是零,算不出來,目標值那欄會顯示 <unknown>。
計算公式很單純,可以自己心算:
需要的泡泡(Pod)數 = 現有泡泡(Pod)數 × (目前使用率 ÷ 目標使用率)
三顆泡泡(Pod)、目前平均 90%、目標 50%,那就是 3 × (90 ÷ 50) = 5.4,通常會朝 6 顆調整;實際還會受 tolerance、上下限、缺失指標與 stabilization 影響。
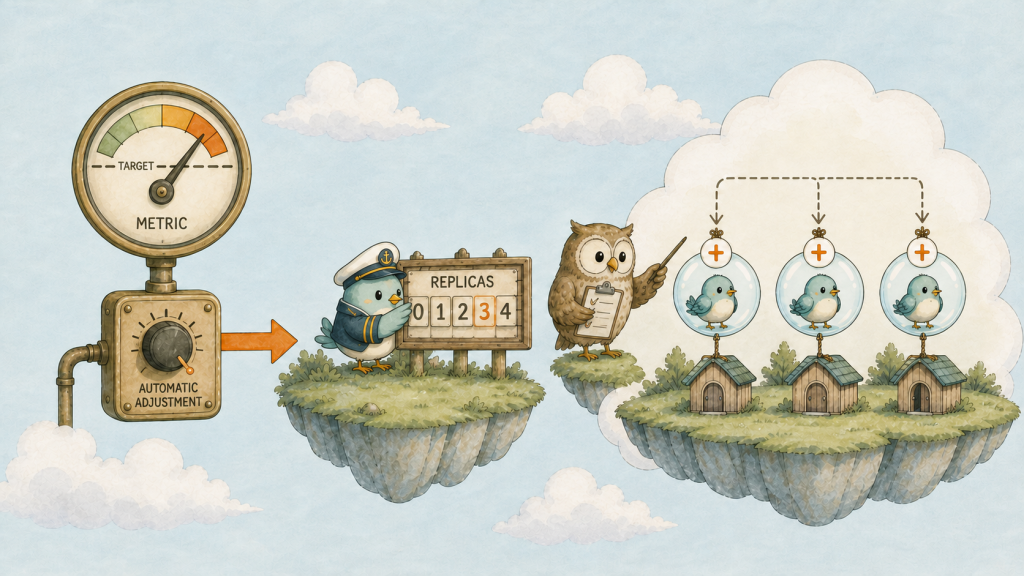
自動調節旋鈕(HPA)旁的指針錶指向高處,橘色箭頭指向部署管家(Deployment)手上的副本數牌,右側才由數泡泡(Pod)的貓頭鷹(ReplicaSet)補出泡泡(Pod)。
第一,自動調節旋鈕(HPA)要靠 metrics-server 才能運作。
它自己不會量任何東西,只是去問「現在用多少」。
上一篇已經裝好了,所以今天能直接玩;正式環境上如果沒人裝,HPA 就是一塊木頭,可能顯示 <unknown>,也可能在 HPA Events 或 controller log 裡看到 metrics API 錯誤。
第二,擴容不是瞬間的,縮容更慢。
中間有好幾層延遲:metrics-server 每十五秒收一次數據、自動調節旋鈕(HPA)每十五秒看一次、新泡泡(Pod)要拉 image 要啟動要等旗子(Readiness Probe)升起來。
從流量進來到新泡泡(Pod)真的能接客,抓一分鐘上下很正常。
縮容則是刻意設計成更慢的,預設要連續五分鐘確認用量真的降下來了才會開始收泡泡(Pod)。
這叫穩定窗口,目的是防止流量一抖動就瘋狂擴縮,那比不擴容還糟。
所以 HPA 適合處理持續一段時間的負載變化,瞬間尖峰仍要靠預留容量、佇列或其他流量控制策略。
上一篇我們畫好了資源Resource Request、也裝好了 metrics-server。接下來會裝自動調節旋鈕(HPA),然後灌流量給它看。
先確認 metrics-server 還活著:
kubectl top pods
有數字就繼續。(顯示 error 的話回上一篇重跑一次那三行安裝指令。)
裝自動調節旋鈕(HPA)。建立 hello-hpa.yaml:
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: hello
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: hello
  minReplicas: 2
  maxReplicas: 8
  metrics:
    - type: Resource
      resource:
        name: cpu
        target:
          type: Utilization
          averageUtilization: 50
scaleTargetRef 是「我要調整哪個部署管家(Deployment)」。minReplicas / maxReplicas 是上下界 ,maxReplicas 是必填欄位,數值要依成本上限推算,避免流量異常時副本數衝太高。
kubectl apply -f hello-hpa.yaml
kubectl get hpa
TARGETS 欄一開始可能顯示 <unknown>/50%,等三十秒讓它收到第一筆數據:
kubectl get hpa
變成 0%/50%、REPLICAS 是 3。沒流量,什麼都不用做。
現在灌流量。 開一顆一直打 Service 的 Pod:
kubectl run load-gen --image=busybox:1.36 -- sh -c "while true; do wget -q -O- http://hello > /dev/null; done"
盯著自動調節旋鈕(HPA)看,這行會每五秒更新一次:
kubectl get hpa hello --watch
(另開一個終端機同時看泡泡(Pod):kubectl get pods -l app=hello -w)
一分鐘內你會看到 TARGETS 那欄的第一個數字往上爬,超過 50% 之後 REPLICAS 開始增加:
NAME    TARGETS     MINPODS   MAXPODS   REPLICAS
hello   0%/50%      2         8         3
hello   85%/50%     2         8         3
hello   85%/50%     2         8         6
hello   42%/50%     2         8         6
控制器依照新的期望數量補出泡泡(Pod)。 而且注意最後一行 ── 泡泡(Pod)變多之後,平均使用率自動降回目標值以下,系統穩定了。這就是它的工作原理。
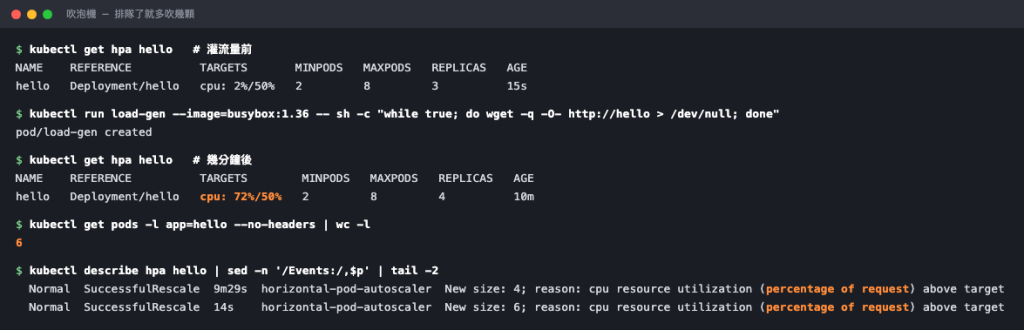
兩次 SuccessfulRescale:先擴到 4,再擴到 6。
實測補一句:一顆 load-gen 可能推不動它。 你的泡泡(Pod) CPU Request 只有 50m,但一個 busybox 迴圈打出來的量,往往只夠讓它擴到 4 顆就停住。想看到更明顯的效果,多開幾顆壓力泡泡(load-gen-2、load-gen-3…)再等一分鐘。
看自動調節旋鈕(HPA)自己怎麼說:
kubectl describe hpa hello | sed -n '/Events:/,$p'
New size: 6; reason: cpu resource utilization (percentage of request) above target。括號裡那句「percentage of request」,就是前面說的分母。
現在把流量關掉:
kubectl delete pod load-gen load-gen-2 load-gen-3
kubectl get hpa hello --watch
TARGETS 幾乎立刻掉回 0%/50%,但 REPLICAS 卡在 6 不動。等五分鐘,它才會開始一階一階往下收,最後停在 minReplicas 設的 2。
HPA 預設會快速擴容、延後縮容,這是穩定機制。 看到這個畫面不代表 HPA 失效。
收工前把它留著,明天不影響。
最後提醒一個常被忘記的搭配問題:HPA 和 Deployment 的 replicas 會打架。
你的 hello-deployment.yaml 裡還寫著 replicas: 3。現在自動調節旋鈕(HPA)把它調成 6,你如果手滑再 apply 一次那個檔案,數字會被拉回 3,然後自動調節旋鈕(HPA)又把它推上去,兩邊互相覆蓋。
正確做法是:服務交給 HPA 管之後,就把 Deployment 裡的 replicas 那一行刪掉。 之後 apply 就不會再去動數量,自動調節旋鈕(HPA)說了算。
但刪之前要先做一步:kubectl apply 會記住上次 apply 的內容,檔案裡少了 replicas,它會當成「你要刪掉這個欄位」,數量直接退回預設的 1 顆。所以先把紀錄裡的 replicas 拿掉,再改檔案:
kubectl apply edit-last-applied deployment/hello
在跳出的編輯器裡刪掉 replicas: 3 那行、存檔,接著才從 hello-deployment.yaml 刪掉同一行。
HPA 看的是用量除以 Request (資源請求),調整的是期望副本數;真正增減 Pod 的是工作負載控制器。


 iThome鐵人賽
 看影片追技術