
從 Day 26 到今天,我的 onprem-changes 倉庫裡累積了十張變更單(Change Request, CR)。每一張單在送審時都必須包含 ## Rollback 章節,CI 流程裡的 check.py 嚴格禁止這個區塊留白,若變更真的無法復原,申請人必須明確載明「無,原因為……」並強制將風險等級標記為 high。
這項規則確保了每一位工程師在發 PR 合併變更之前,心中都先預演過一次如果搞砸了該怎麼退回上一版。
但在紙上推演過與在線上環境踩過坑,中間永遠隔著現實的鴻溝。
今晚演練開始前,十張單裡已有八張標記為 done(CR-2026-0009 與 0010 排在今晚演練之後)。翻開這八段復原步驟,除了 CR-2026-0001 的虛擬機快照當初真的有拍(但後來沒用上,並隨隨後的追蹤事項刪除)之外,其餘七張的復原指令,全都是當初寫單的人坐在螢幕前「憑經驗推敲出來」的——從未有任何人在真實設備上敲下那行指令。
回顧過去的演練:
將已經上線的變更單,照著當初寫的 Rollback 步驟執行,精確量測從開始復原到系統驗證通」的時間(RTO),並將資料寫入 Day 15 的紀錄表與 Day 16~18 的 drills.jsonl,驗證無誤後再重新推回最新狀態。
Rollback 會在 Day 27 打造的稽核軌跡留下軌跡,也會觸發監控告警規則,這一切都必須在監控端精準對齊。這次演練本身也是一張標準的變更單——CR-2026-0011,具備維護窗口、告警靜音(Silence),以及明確的 Begin 與 End 標記。
測試與稽核:
今晚四次計時演練全部通過,RTO 分別是 19 秒、8 秒、4 秒與 14 秒。然而,在三個演練情境原本寫下的假設中,有兩個在實體環境上完全被推翻,而且結果都「比原本預期的更樂觀」。
但請注意,這絕非值得慶祝的好消息,這代表**當初寫在變更單裡的 Rollback 預期全憑空想。如果我沒有實際動手做,這個美麗的誤會將永遠躺在文檔裡,直到某天半夜真正炸機時才引爆。 : P **
drills/
檢視現有八張變更單的復原機制,其實歸納起來就幾種模式。挑選的原則是每種核心機制實測一次,且嚴格執行原單所寫的步驟,不擅自魔改或省略:
| 復原機制 | 對應變更單 | 原變更單 Rollback 步驟重點 | 本次實測作法 |
|---|---|---|---|
| 快照還原 | CR-2026-0001 (QDevice VM 升級 Debian 13) | Virtualization Station 還原至快照 CR-2026-0001-before,pve1 的 check.sh 需在一分鐘內回傳 0 |
執行。原快照已依規刪除,改用今晚拍的新快照模擬 |
| 設定反向變更 | CR-2026-0007 (FortiGate 60F 端的 syslogd3 設定) | config log syslogd3 setting 改回 set status disable |
執行。透過 REST API 送出 PUT {"status":"disable"},一分鐘後重新啟用 |
| 備份檔覆蓋與容器重啟 | CR-2026-0007 (日誌收集端的雙監聽器) | /opt/onprem-logs 以 *.bak-day27 還原覆蓋,docker compose up -d 重新部署回單一監聽器狀態 |
執行。停留 10 分鐘觀察日誌斷流狀況,隨後重做推進至新版 |
| 設定反向變更 | CR-2026-0002 (syslogd2)、CR-2026-0004 (webfilter) | 同上述第二種 | 不執行。0004 會在 Day 24 的 UTM 紀錄上挖出資料斷層 |
| 刪除資源 | CR-2026-0003 (封包側錄)、CR-2026-0006 (sudoers) | 刪除背景服務、移除 SSH 金鑰 | 不執行。0003 的 WORM 儲存批次本來就無法倒回 |
| 靜音規則過期 | CR-2026-0005 (授權風險告警) | 執行 amtool silence expire,TSV 清單倒回 |
不執行。會瞬間觸發 20 項授權告警大作 |
| 備份檔覆蓋 | CR-2026-0008 (稽核告警排除跳板工作站) | 以 *.bak-cr0008 還原覆蓋 |
不執行。與第三種機制重疊,且該單當天下午才剛結案 |
值得注意的是,兩張被評定為 risk: high 的變更單今晚都被排除在演練之外:
這次刻意保留這兩張高風險變更單,後文第六節會說明今天新寫的 Prometheus 規則如何持續監控並揪出這類從未經過 Rollback 驗證的高風險單。
Day 15 的 record.sh 是以每 2 秒輪詢一次 check.sh 並把結果倒進檔案,事後再回推時間軸。而今天的 drills/drill.sh 則是事件導向的設計:不主動記錄狀態,只持續監聽目標條件是否達成:
drills/drill.sh <label> <演練變更單號> <被復原的變更單號> [-t 逾時秒數] -- <驗證指令>
在開始 Rollback 的那一秒啟動它,腳本每 2 秒執行一次驗證指令,一旦回傳值為 0 立即終止計時,兩者差距即為真正的 RTO(秒數),若超過 -t 指定的時間仍未過關,則判定為 FAIL。
啟動與結束時,腳本會各向 systemd journal 寫入一行帶有 tag drill 的日誌,這讓 Day 27 的變更稽核報告能夠自動在維護窗口內比對出這些動作。最後,它會在 drills/drills.jsonl 追加一筆紀錄:
{"t0":"2026-10-12T11:39:22Z","label":"qdevice-snapshot-revert","cr":"CR-2026-0011","rollback_of":"CR-2026-0001","result":"OK","rto_s":19,"checks":6,"note":"..."}
這個 rto_s 是包含人為操作耗時的。在 Virtualization Station 介面點選快照還原、送出 REST API 請求,這些人類思考與滑鼠點擊的時間全部算在裡面。因為生產環境的 Rollback 步驟本來就是寫給工程師照著操作的,我量的正是「人類照著文檔做到底要花多久」。
此檔案會隨著演練紀錄一同發 PR 合併回主分支。日誌收集端的 Git Repo 每 15 分鐘自動同步一次(Day 26 的排程),兩支 Textfile Collector 會解析這份檔案:
onprem-metrics 的 drills-textfile.py 增設了 changes 來源,產出 drill_last_result{source="changes",label="qdevice-snapshot-revert"},無縫整合進 Day 20 的 DrillFailed 告警。onprem-changes 的 changes-textfile.py 則緊盯 rollback_of,為被復原的單子產出 change_rollback_last_drill_timestamp 等三項指標,並在 README 索引表自動加上「最後復原演練時間」。三個演練的驗證指令標準如下:
| 演練項目 | 驗證指令必須同時滿足的條件 |
|---|---|
| 演練 1 (快照還原) | pve1 上的 check.sh 回傳 0(仲裁 3 票皆在),且 VM 內於快照後建立的標記檔案必須消失(證明真的回到過去) |
| 演練 2 (API 設定倒回) | 收集端在最近 5 分鐘內收到 cfgpath="log.syslogd3.setting" 且帶有 status[disable->enable] 的日誌 |
| 演練 3 (容器 Rollback) | VictoriaLogs 的 /health 回應 200,且主機上的 ss -ltn 監聽埠中不再出現 515 |
| 演練 3 (重新推進前進) | /health 回應 200,且容器網路命名空間內存在來自 FortiGate 60F 連往 515 的 ESTABLISHED 連線 |
特別強調演練 1 的檢驗機制,快照還原絕對不能只驗 check.sh。若 VM 根本沒倒回快照、只是單純重啟了系統,仲裁票數一樣會回傳 0。只有在拍快照後於 VM 內部寫入金鑰標記檔,並在還原後確認該檔案確實蒸發,才能證明時光真正倒流。
CR-2026-0001 原文第一條寫著:「在 Virtualization Station 將 VM 還原至快照 CR-2026-0001-before,預期 1 分鐘內完成」。
然而到了 10/11,這個快照早已依照變更單的結案要求刪除。也就是說,這份當初寫好的 Rollback 計畫在今天根本無法執行。退而求其次只剩下第二條備案,依據文件手動重建 VM,耗時 10 分鐘,且必須在 PVE 叢集執行 pvecm qdevice remove 再重新配對。
這是一個不錯的示範提醒,變更單上的快照 Rollback 方案是有有效期限的,其壽命完全取決於底層快照的保留週期。
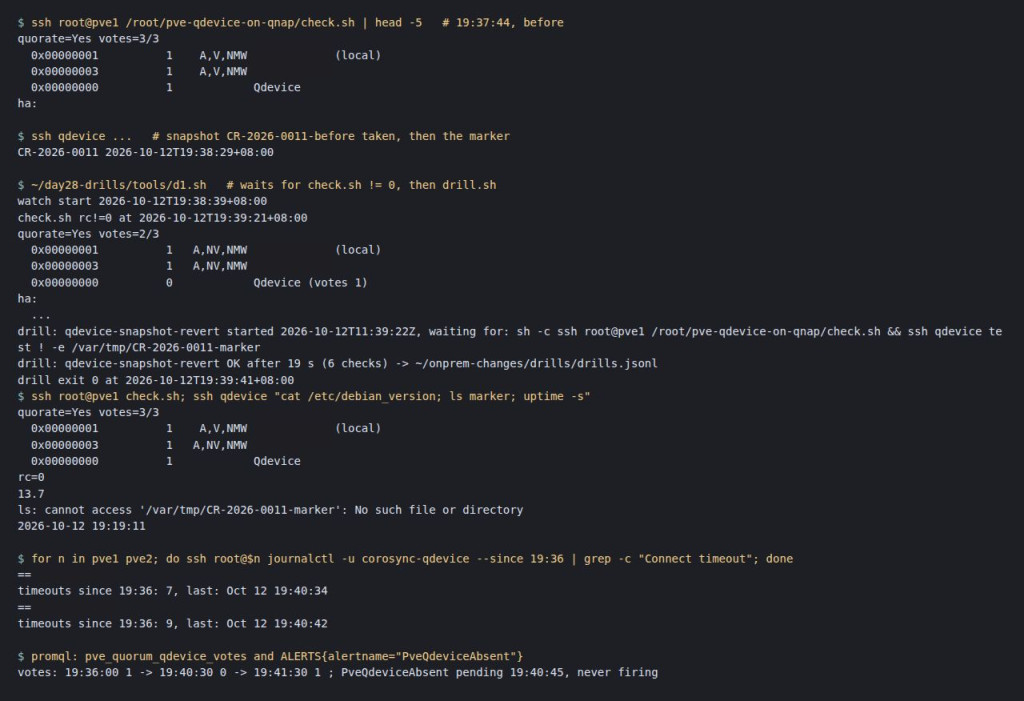
今晚改用演練前現拍的新快照 CR-2026-0011-before。因為 VM 內早已拔除工作站的 SSH 公鑰,因此先在主控台暫時加入公鑰、拍照、寫入時間戳標記檔(19:38:29),接著由 Virtualization Station 關機、還原快照、開機。工作站腳本監控到 pve1 的 check.sh 回傳 1(仲裁中斷)時,立即啟動 drill.sh 計時。
原先預期:
參考 Day 15 與原變更單紀錄,VM 從關閉到拉起約需 1~3 分鐘,Quorate 全程保持 Yes(2/3 票),Prometheus 的 PveQdeviceAbsent(for: 2m)可能會進入 Pending 狀態,由維護窗口的 Silence 壓制。
實測結果:check.sh 在 19:39:21 回傳 1(quorate=Yes votes=2/3),drill.sh 於 19:39:22 啟動,19:39:41 即驗證通過,RTO 僅 19 秒,歷經 6 次檢查。
比預期快上數倍的原因非常直觀,但唯有實測才會發現:Virtualization Station 在虛擬機開機狀態下拍攝的快照包含了記憶體狀態(Live Snapshot)!還原之後 VM 不是冷開機跑 systemd 初始化,而是直接從拍攝的那一毫秒繼續跑。
這帶來了兩個有趣的副作用:
uptime -s 依然維持在 19:19:11。此外,check.sh 過關不代表 QDevice 通訊已完全穩定。兩台 PVE 節點的 corosync-qdevice 用戶端在 19:39:17 發現 qnetd 無回應後,便持續陷入 Connect timeout,pve1 直到 19:40:34 才重新連上,pve2 則是 19:40:42。也就是說,在仲裁票數看似正常的背後,其實過了一整分鐘通訊才真正修復。
還原後 VM 的標記檔確實消失,系統版本停留在 13.7。
然而,在稽核這段操作時,我意外踩出了一個潛藏的未爆彈:
照理說,QNAP NAS 的系統事件日誌應該巨細靡遺地記下快照建立、VM 關閉、還原、啟動的每一秒。但日誌收集端竟然一筆紀錄都沒有收到。
深入追查發現:10/11 19:12 起,主 NAS 的對外連線(Outbound)IP 從跳掉了,因為有二張網路卡。然而日誌收集端的防火牆 DOCKER-USER 允許清單只放行了原本的 IP,所以收集端主機的 kernel log 裡每秒都有一條無聲的哀號:
[DOCKER-USER DROP] SRC=ip DPT=514
這導致主 NAS 的日誌在這整整 25 小時內完全失蹤,而稽核報告裡的計數卻安靜地顯示為 0。在維運的世界裡,安靜的 0 往往比滿江紅的報警更致命。這項缺漏被立刻立單列入追蹤,不在今晚的變更範圍內節外生枝。
CR-2026-0007 是將 FortiGate 60F 的事件日誌接入收集端的 Port 515。它的 Rollback 步驟第一條,就是透過指令將 syslogd3 關閉。
在演練前,我的技術推論是這樣的:
FortiOS 的設定變更日誌(Event
0100044546)是在設定生效後才產生。當管理者送出關閉syslogd3的瞬間,日誌輸出通道既然已經被拔掉,這筆「關閉 syslogd3」的日誌就絕對送不出來,只會留在防火牆本機記憶體中。因此收集端應該只看得到「開」,永遠看不到「關」。
實測結果徹底推翻了這個推論。
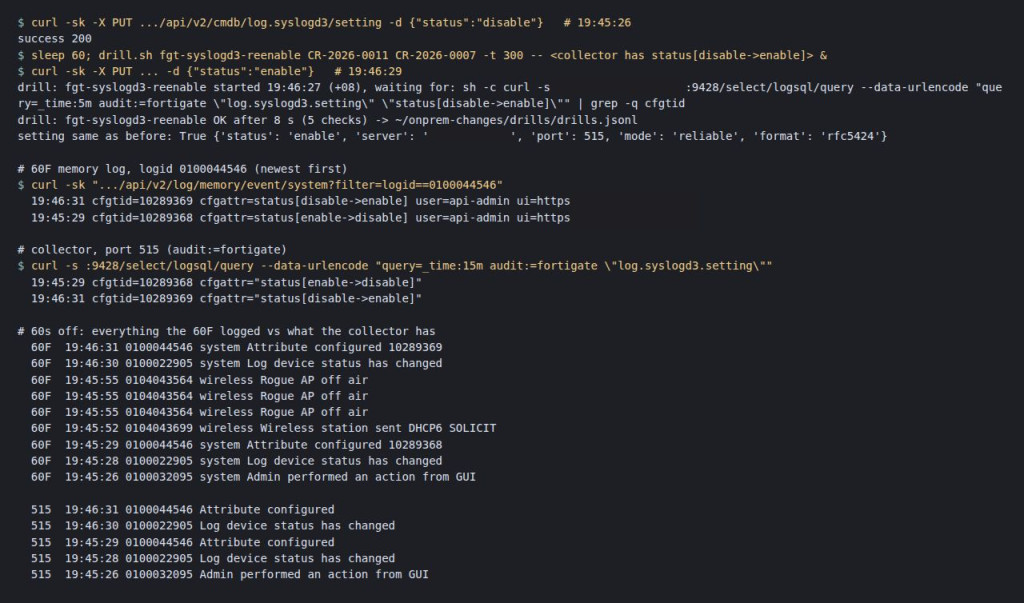
19:45:26 透過 API 送出停用,60 秒後(19:46:29)送出啟用,drill.sh 於啟用前 2 秒就位,RTO 僅 8 秒,5 次檢查全數通過。打開日誌比對,兩筆變更紀錄在防火牆本機記憶體與遠端收集端雙雙存留:
| 操作動作 | cfgtid | cfgattr 內容 | FortiGate 60F 本機記憶體日誌 | 收集端 Port 515 |
|---|---|---|---|---|
| 停用 (Rollback) | 10289368 | status[enable->disable] |
19:45:29 | 19:45:29 (成功抵達) |
| 啟用 (重做) | 10289369 | status[disable->enable] |
19:46:31 | 19:46:31 (成功抵達) |
每一筆之前還各伴隨一筆 0100022905 Log device status has changed,同樣毫髮無傷地送達收集端。
這證明 FortiOS 的底層實作是先將這筆事件寫入既有的 TCP 連線通道,完成 Flush 之後,才真正關閉 Socket 與服務。這與之前做的推論完全相反(原廠文檔並未提及這項細節)。在停用的 60 秒空窗期內,防火牆本機僅產生了 4 筆本就被過濾規則排除的無線網路日誌,因此沒有漏掉任何關鍵稽核事件。
Day 27 曾提過機器寫下的紀錄沒有人能事後竄改,至少在 FortiOS 7.6.7 上,關閉日誌的這個動作,會忠實地把自己給記錄下來。但這是在特定版本實測出來的行為,未來升級韌體仍需重新驗證,這也正是我規劃 90 天巡檢規則的原因。
CR-2026-0007 的後半段在收集端:Docker Compose 擴充了第二組 Syslog 監聽埠(515)。這部分的 Rollback 就是把 docker-compose.yml.bak-day27 還原覆蓋並重啟容器。
問題在於當 515 被拔掉後,FortiGate 60F 的 syslogd3 會連不上。在這段服務中斷的真空期內,防火牆產生的資安稽核事件會流向何方呢?
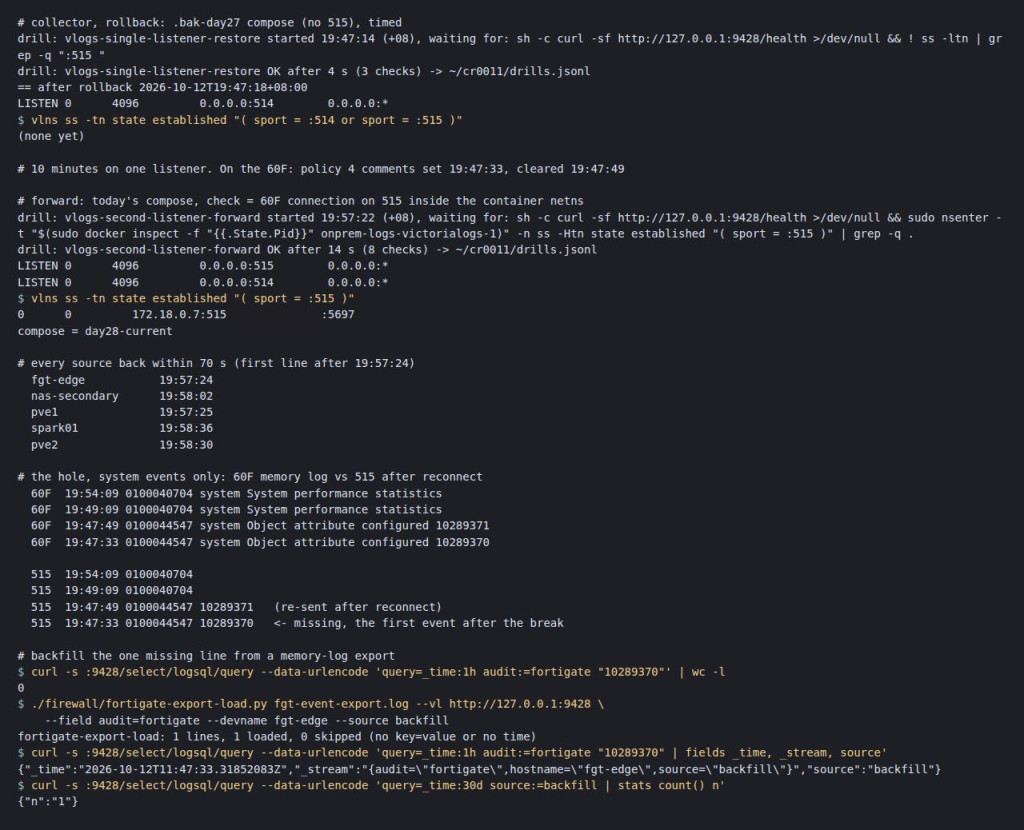
19:47:14 啟動 Rollback,19:47:18 通過驗證,RTO 僅 4 秒,主機僅剩 514 埠在監聽(514 專跑流量日誌,10 分鐘內正常吞吐了 1,765 筆紀錄)。
在刻意停留的 10 分鐘中斷期間,從工作站對防火牆發起無害的變更:
comments 寫入字串(cfgtid 10289370)藉此製造幾筆理論上收集端無法接收的設定異動事件。
10 分鐘後(19:57:22),執行前進重做,覆蓋回新版 Compose 並重建容器,19:57:36 驗證通過,RTO 14 秒。Port 515 總計關閉了 10 分 18 秒。
在演練前,原稿設計的驗證指令是在主機上執行:
ss -tn state established "( sport = :515 )"
但在演練前試跑時赫然發現這行指令永遠不會回傳 True!
因為 Port 515 是透過 Docker DNAT 轉發進容器內的,TCP 連線狀態僅存在於容器的網路命名空間(Network Namespace),在宿主機本體上只能看見 docker-proxy 的 LISTEN 狀態。如果照原案跑,drill.sh 會一路枯等到 300 秒逾時報錯。
最後決定將指令改為透過 nsenter 鑽入容器命名空間檢查,且每次檢查動態取得最新容器 PID:
sudo nsenter -t "$(sudo docker inspect -f '{{.State.Pid}}' onprem-logs-victorialogs-1)" -n ss -Htn state established "( sport = :515 )"
驗證指令本身的可靠性,也必須在演練前經過驗證。
之前預期 FortiOS 在 Reliable Syslog(TCP)斷線期間的日誌會直接丟棄。
實測結果如下:
| 防火牆 60F 記憶體日誌紀錄 | logid | 收集端重啟連線後的狀態 |
|---|---|---|
| 19:47:33 Policy 4 comments 寫入 (cfgtid 10289370) | 0100044547 |
遺失(未收到) |
| 19:47:49 Policy 4 comments 清除 (cfgtid 10289371) | 0100044547 |
成功補送收到 |
| 19:49:09 系統效能統計資訊 | 0100040704 |
成功補送收到 |
| 19:54:09 系統效能統計資訊 | 0100040704 |
成功補送收到 |
真相大白:FortiOS 的 Reliable Syslog 具備本地緩衝機制,會在連線恢復後自動補送斷線期間的事件。
唯一遺失的,只有斷線當下的第一筆紀錄。
合理推論是這樣的,該筆紀錄寫入了當初已被遠端中斷、但本地 TCP Stack 尚未判定逾時的 Half-Open 連線中,防火牆在應用層誤以為傳送成功,直到下一次嘗試寫入時觸發 RST/錯誤,才驚覺連線已死,隨後的日誌才正式轉入本地緩衝區等待重送。
黑洞不是 10 分鐘,而是精確的一筆。
既然知道只缺一筆,就把它補齊。從防火牆的 REST API(/api/v2/log/memory/event/system/raw)撈出暫存日誌,利用 Day 24 的 fortigate-export-load.py 將遺失的那一筆補回 VictoriaLogs。
為了避免污染正常的日誌流,我加上了標籤隔離:
./firewall/fortigate-export-load.py fgt-event-export.log \
  --vl http://127.0.0.1:9428 \
  --field audit=fortigate \
  --devname fgt-edge \
  --source backfill
透過明確標記 source:=backfill,既能保證稽核日誌流的完整性,又能在事後追查時清晰識別出這是補載的數據。所有日誌來源在容器重啟後 72 秒內全數恢復正常通訊。
這個演練顛覆了原變更單的思維,本來只寫了如何把容器設定還原,卻未提還原造成日誌斷流該如何稽核與回補。 因此這次在變更單範本中補上了關鍵指引:「若 Rollback 會導致資料流中斷,必須載明資料斷層的比對方式與補回流程。」
演練終於告一段落,檢視三個關鍵維度的變化:
執行 audit-report.py --since 2026-10-12T19:00:00+08:00,維護窗口內共擷取到 118 筆特權操作,全數自動歸戶至 CR-2026-0011:
未關聯變更單的異常操作為 0。
維持不變。這是刻意的設計,若演練真的把 Debian 13 還原為 12,清單與告警就必須倒回重跑。
在 changes 告警群組新增了兩條關鍵規則:
| 告警規則名稱 | 觸發條件 | 本次演練後狀態 |
|---|---|---|
ChangeRollbackUndrilled |
狀態為 done 且風險等級為 high 的變更單,若在 drills.jsonl 裡從未有過 Rollback 紀錄時觸發 (Info) |
Firing。精準抓出 CR-2026-0004 與 CR-2026-0005 兩張我今晚刻意避開的高風險單 |
ChangeRollbackDrillStale |
變更單狀態為 done,但最近一次 Rollback 演練已超過 90 天時觸發 (Info) |
OK。今日為首次演練,尚未逾期 |
為什麼只鎖定 high 風險?
因為在現有 10 張變更單中,若連 Medium 都納入,告警清單會瞬間塞滿 5~7 張單,久了工程師只會對告警疲乏。將焦點鎖定在 High,讓它常駐在每日維運晨報中,時時刻刻提醒團隊:「這兩顆定時炸彈的復原開關,至今還沒有人敢去按過一次。」
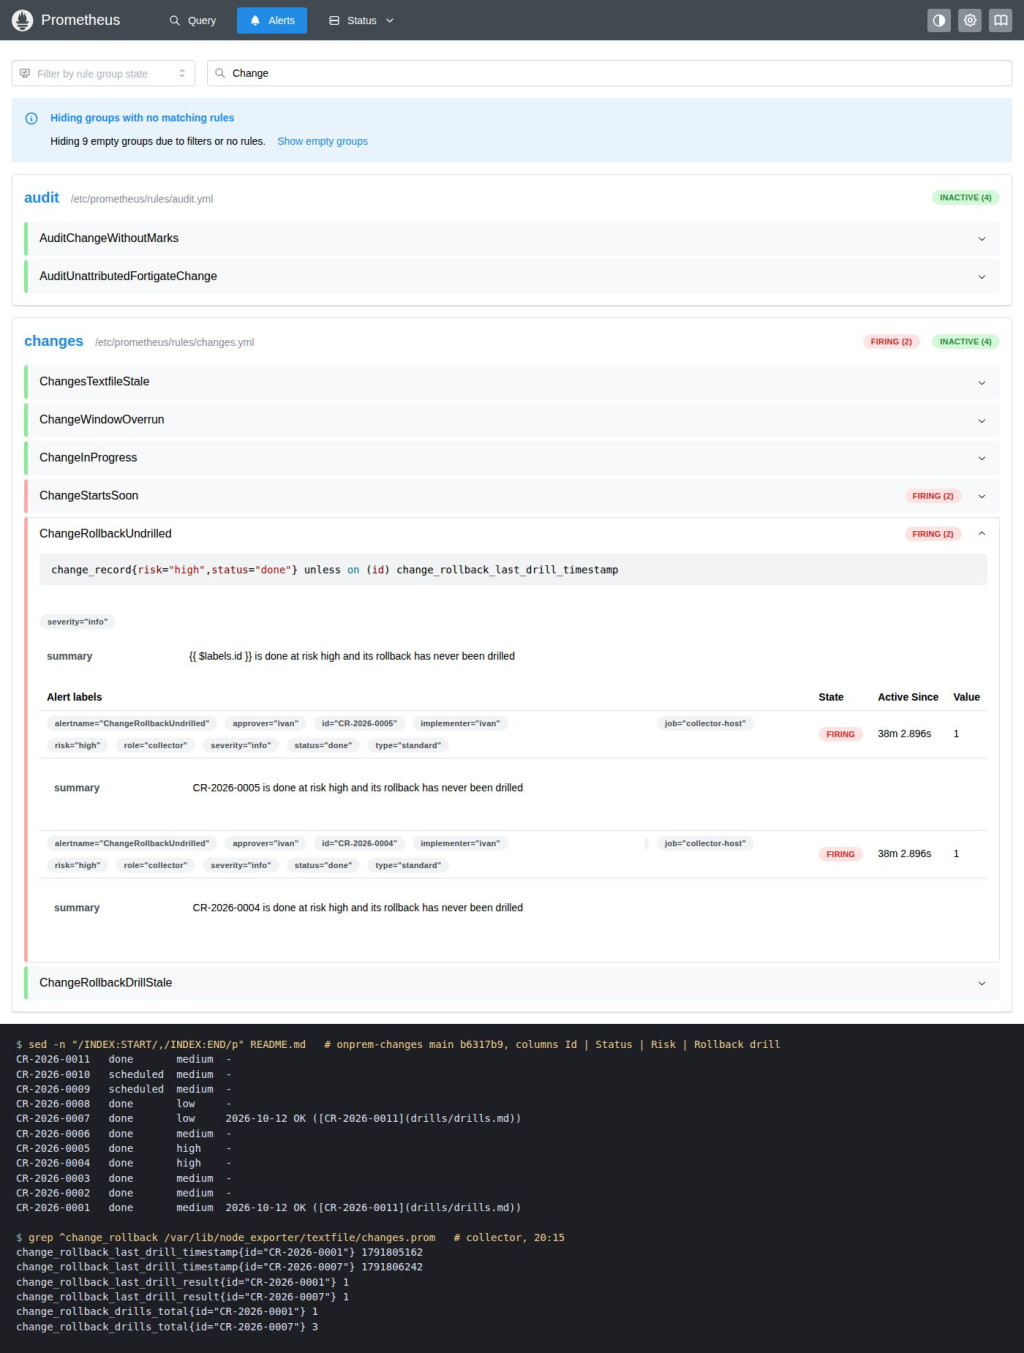
以下為本次演練在現場終端機中實際執行的指令摘要:
# 1. 演練變更單合併就位。維護窗口開始,在收集端下達 begin 標記,並部署新版規則與排程
sudo -u metrics /opt/onprem-changes/scripts/change-mark.sh begin CR-2026-0011
sudo cp ~/cr0011/onprem-metrics/prometheus/rules/changes.yml /opt/onprem-metrics/prometheus/rules/changes.yml
sudo install -m 0644 ~/cr0011/onprem-metrics/systemd/collector.cron /etc/cron.d/onprem-metrics
curl -s -X POST http://127.0.0.1:9090/-/reload && curl -s -X POST http://127.0.0.1:9093/-/reload

# 2. 演練 1:QDevice 快照還原(工作站執行)
ssh qdevice 'echo "CR-2026-0011 $(date -Is)" > /var/tmp/CR-2026-0011-marker'
drills/drill.sh qdevice-snapshot-revert CR-2026-0011 CR-2026-0001 -t 600 -- \
  sh -c 'ssh root@pve1 /root/pve-qdevice-on-qnap/check.sh && ssh qdevice test ! -e /var/tmp/CR-2026-0011-marker'

# 3. 演練 2:FortiGate syslogd3 API 停用與恢復(工作站執行)
curl -sk -X PUT -H "Authorization: Bearer $FGT_TOKEN" -H 'Content-Type: application/json' \
  "https://<fgt-edge>:10443/api/v2/cmdb/log.syslogd3/setting" -d '{"status":"disable"}'
sleep 60
drills/drill.sh fgt-syslogd3-reenable CR-2026-0011 CR-2026-0007 -t 300 -- \
  sh -c 'curl -s http://<collector>:9428/select/logsql/query --data-urlencode "query=_time:5m audit:=fortigate \"log.syslogd3.setting\" \"status[disable->enable]\"" | grep -q cfgtid' &
sleep 2; curl -sk -X PUT -H "Authorization: Bearer $FGT_TOKEN" -H 'Content-Type: application/json' \
  "https://<fgt-edge>:10443/api/v2/cmdb/log.syslogd3/setting" -d '{"status":"enable"}'; wait

# 4. 演練 3:收集端容器還原與重做(收集端執行)
sudo cp -p docker-compose.yml docker-compose.yml.day28-current
drills/drill.sh vlogs-single-listener-restore CR-2026-0011 CR-2026-0007 -t 300 -- \
  sh -c 'curl -sf http://127.0.0.1:9428/health >/dev/null && ! ss -ltn | grep -q ":515 "' &
sleep 2; sudo cp docker-compose.yml.bak-day27 docker-compose.yml && sudo docker compose up -d; wait

# ... 停留 10 分鐘,期間在防火牆修改 Policy 4 產生測試事件 ...

# 重新推進前進狀態(利用 nsenter 鑽入容器網路空間驗證連線)
drills/drill.sh vlogs-second-listener-forward CR-2026-0011 CR-2026-0007 -t 300 -- \
  sh -c 'curl -sf http://127.0.0.1:9428/health >/dev/null && sudo nsenter -t "$(sudo docker inspect -f "{{.State.Pid}}" onprem-logs-victorialogs-1)" -n ss -Htn state established "( sport = :515 )" | grep -q .' &
sleep 2; sudo cp docker-compose.yml.day28-current docker-compose.yml && sudo docker compose up -d; wait

# 5. 填補日誌斷層:比對記憶體與收集端差集,精準回補 1 筆遺失事件
./firewall/fortigate-export-load.py fgt-event-export.log --vl http://127.0.0.1:9428 --field audit=fortigate --devname <devname> --source backfill

# 6. 收尾與產生稽核報表
sudo -u metrics env CHANGES_DIR=/opt/onprem-changes/changes /opt/onprem-logs/audit/audit-report.py --since 2026-10-12T19:00:00+08:00
sudo -u metrics /opt/onprem-changes/scripts/change-mark.sh end CR-2026-0011
自動化測試驗證:
onprem-changes 的 tests/test_drill.sh 邊界測試(包含延遲成功、逾時失敗、非零 Exit Code 與參數防呆)。promtool test rules 針對兩條新規則的邏輯驗證(High 風險警示、過期天數判斷)。test_check.py 過去依賴空倉庫才能過測的隱蔽 Bug。實體環境驗證結果(CR-2026-0011,歷時約 23 分鐘):
Day 29:當 AI Agent 走進維運現場,存取控制與授權閘道
這一整週我建構了變更單、狀態標記、稽核軌跡以及今天的 Rollback 演練,核心目的只有一個:讓每一次線上變更都處於透明、可控且可逆的狀態。
明天的挑戰是,如果下指令的不再是工程師,而是一個具備自主推理能力的 AI 維運代理程式(Ops Agent),它的變更單該由誰審核?它的 Begin 標記由誰下達?它的權限邊界該停在哪裡?哪些動作必須強制保留人類審查(Human-in-the-loop)?
Day 23 的 CAP_NET_RAW、Day 27 的唯讀 API 權限,以及今天實測出來的 Rollback 步驟,都將成為協助人類管控 AI 代理人的安全韁繩。
系列文章與程式碼索引:onprem-ops-30days
本日程式碼:onprem-changes v0.2.0(drills/、CR-2026-0011)、onprem-metrics v0.3.3、onprem-logs v0.5.3
Day 1|系列規劃與場域總覽:從跑得起來到可長期維運,先談為什麼要封裝
Day 2|Container Station 薄殼架構:QPKG 骨架、生命週期腳本與狀態頁
Day 3|版本鎖定與供應鏈:image digest、SHA256SUMS 與授權檔
Day 4|GitHub Actions 自動打包與 release:從 git tag 到可驗證的套件
Day 5|案例 Jellyfin 與 Roon:硬體轉碼的裝置直通與主機網路
Day 6|案例 changedetection.io 與 Homepage:資安與資訊公告監看 + 整合入口
Day 7|在地自建 ComfyUI 的生存指南:自建 Image 鎖定、GPU 直通與三層目錄架構
Day 8|案例實戰:Open WebUI + Ollama 重構記,把專案回到通用框架會省下什麼呢?
Day 9|容量規劃:用模型與硬體搭配矩陣決定地端節點與儲存規格
Day 10|上游引擎一改版,地端 AI 環境用的配方壞了怎麼辦 ? patch 移植實戰紀錄
Day 11|DGX Spark 節點基線:DGX OS 初始設定、帳號與 SSH 加固
Day 12|熱與統一記憶體守護:取樣器、自動降載與長時間負載實測
Day 13|別讓節點踩爆模型!NFS 集中模型庫的單寫多讀、權限凍結與完整性治理
Day 14|儲存規劃與路徑實測:RAID 60 與 RAIDZ2 試算,SSD、NFS、iSCSI 載入時間解析
Day 15|Proxmox VE 雙節點 HA:Virtualization Station 上的 QDevice
Day 16|Proxmox VE 備份與還原:HDP for Business Beta 的排程、保留與還原演練
Day 17|儲存設備備份策略與還原演練:快照、HBS 3 與 3-2-1 備份策略
Day 18|3-2-1 的最後一步:異地物件儲存、保留政策與冷熱資料成本精算
Day 19|指標收集:把前十八天的取樣器接進同一個時間序列
Day 20|儀表板與告警,打造一個簡潔的單一面板
Day 21|日誌集中與保存:節點不裝新代理,封存要能比對
Day 22|被擋下的封包才是便宜情報:從防火牆靜默盲點到日誌降噪與自動化告警
Day 23|日誌找不到原因?從 tcpdump 最小權限封包擷取到 WORM 封存的網路排錯實戰
Day 24|稽核問「某台工作站上個月連到哪裡了」?FortiGate AUP 雙軌日誌實踐:線上 LogsQL 檢索與離線對帳修煉
Day 25|資產生命週期與授權 EOL 監看:到期日只是一個數字,通通收進 Prometheus 時間序列!
Day 26|變更管理實戰:串起 Git 變更單、監控與日誌,讓每次改動都有跡可循
Day 27|自動化稽核比對:當機器留下的日誌,對上工程師寫的變更單(VictoriaLogs × FortiGate × PVE)
Day 28|Rollback 實戰演練:沒真正執行過的復原步驟,永遠只是一場美麗的假設
Day 29|打造地端維運的 AI 圍欄:Agent 授權閘道實作,無工單即無工具,無核准即無不可逆變更
Day 30|完賽總結|算清一年的電費、硬體折舊與雲端代價:地端 AI 維運 30 天留下的真實資產



 iThome鐵人賽
 看影片追技術