

回顧 Day 1,當時拋出了一個看似簡單的核心問題,「把服務跑起來」與「能夠長期維運」之間,究竟隔著多遠的距離?
當時拆解出的四大待解決問題是:
三十天過去,每一類問題底下,如今都有具體的 GitHub Repo、變更申請單與自動化排程在默默運轉。來到最後一天,專注做好三件收尾工作:
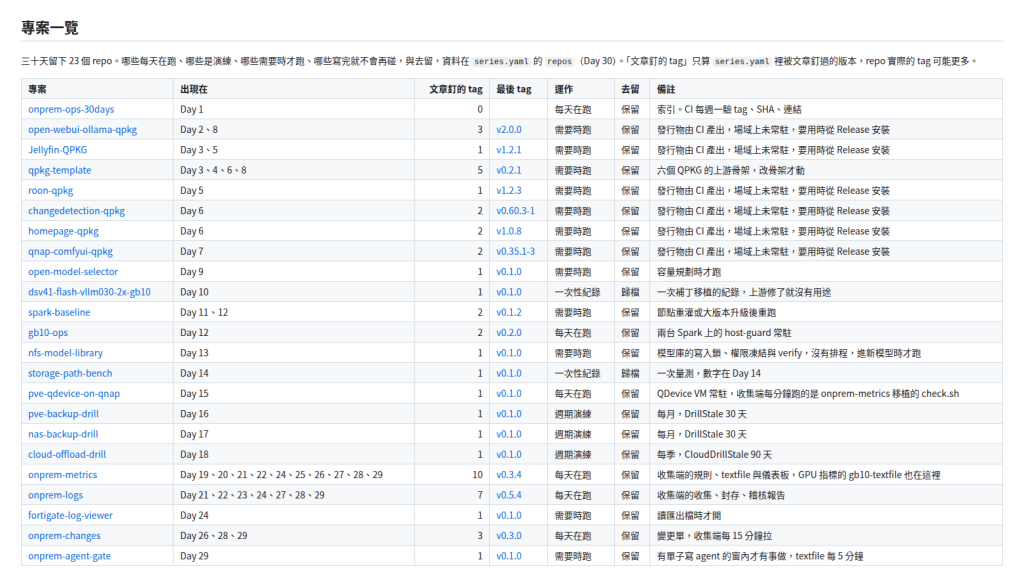
整個系列的所有脈絡與程式碼,皆已收錄於索引用 repo onprem-ops-30days。其中的 series.yaml 是專案的單一真實來源(Single Source of Truth),lab/cost.yaml 與 scripts/cost.py 是成本模型,lab/checklist.md 則是這三十天的實戰沉澱。這個索引 Repo 本身也是 23 個成員之一,每週一固定跑一次 CI,確保每一個文章標籤(Git Tag)與 SHA 校驗值正確、每篇連結暢通無阻。
在 series.yaml 中,除了記錄每天對應的儲存庫、Tag 與 commit SHA,今天特別擴充了 repos 區塊,定義了兩個核心屬性:runs(目前以何種形式運作)與 fate(去留命運)。透過 render.py 自動生成 README 中的專案一覽表,並藉由 check.py 嚴格把關,確保文章中提到的 Repo 與設定檔嚴格一對一吻合,多一個或少一個,CI 都會直接報錯中斷。
| 運作方式 | 數量 | 涵蓋儲存庫 |
|---|---|---|
| 常態執行(服務常駐、Cron 或自動排程) | 6 | 索引儲存庫、gb10-ops、pve-qdevice-on-qnap、onprem-metrics、onprem-logs、onprem-changes |
週期演練(自帶 drills.jsonl) |
3 | pve-backup-drill(每月)、nas-backup-drill(每月)、cloud-offload-drill(每季) |
| 隨選執行(需要時才啟動) | 12 | 6 個 QPKG、qpkg-template、open-model-selector、spark-baseline、nfs-model-library、fortigate-log-viewer、onprem-agent-gate |
| 一次性紀錄(封存唯讀) | 2 | dsv41-flash-vllm030-2x-gb10、storage-path-bench |
這張盤點清單的初版並非如此。原本草稿有列出 6 個 QPKG 與模型庫列入執行,但實際上為了資源精簡,平常 6 個 QPKG 僅保留停用狀態的 ComfyUI,沒用到的套件就卸載,需要時再打開或安裝。然而這正是第一階段「容器與套件封裝」的價值所在,軟體打包成 GitHub Release,需要時隨時能還原出與當天完全一致的環境。而模型庫的 verify 指令稿自 Day 13 寫完後,也並未掛上自動排程,因此歸類為隨選執行。
在常態執行的多個項目中,其真實運作樣貌:
pve-qdevice-on-qnap 常駐的是仲裁用的 QDevice 虛擬機器(VM),收集端每分鐘以指令稿拉取指標。gb10-ops 則是兩台 GB10 節點上常駐守護的 host-guard。關於去留,僅有兩個 Repo 被設為封存(Read-only):
三個演練 Repo 的程式碼邏輯大同小異,都是計時並寫入一筆 drills.jsonl。如果合併成單一 onprem-drills,固然能省下重複的 README,但代價是三套系統的演練歷程會混雜在同一個 Git Commit Log 中。
演練紀錄的核心價值在於它緊緊綁定著特定的目標系統與時間軸。 例如 Day 28 的服務回退演練(Rollback Drill),就選擇把它放在 onprem-changes 的 drills/ 目錄下,因為回退行為是與工單緊密相連的。也因為這樣,確立了相對簡單的原則,演練紀錄必須跟著被演練的標的走。
另外,Git Tag 的數量也反映了專案的演進,onprem-metrics 在 11 天內被文章釘了 10 個 Tag,onprem-logs 在 9 天內推了 9 個 Tag(文章引用其中 7 個)。文章堅持釘死 Tag 而不指向 main 分支,雖然讓版本號滾動得極快,但能確保讀者在一年後點開任何一天的文章連結時,看到的依然是當天那一刻一模一樣的程式碼。
計算一年的真實用電成本,需要兩個關鍵數字:每台設備的平均功耗 與 實際適用電價。前者靠實測,後者靠邊際模型精算。
硬體規格銘牌上的瓦數往往高估數倍,而待機與滿載的功耗差距極大。
我們原先規劃透過不斷電系統(UPS)取得全域數據:Day 19 在 NAS SNMP 中採集了 qnap_ups_load_percent。然而實測才發現,兩台 NAS 回傳的值皆為 -1(未正確回報 UPS 負載)。更棘手的是,該指標在 Prometheus snmp.yml 採集器中被解析為字串標籤(Label),指標本身的 Sample Value 永遠為 1。這意味著即便接上 UPS,做 avg_over_time 也只會恆等於 1。這條路行不通,也成了後文會提到的典型「安靜的盲區」。
最終,最可靠的量測途徑是智慧插座電表。本場域配置了兩顆支援能源監控的 Tapo P110M,自 9 月起全時記錄兩台 GB10 的逐日耗電度數:
| 量測期間 | GB10 (節點 131) | GB10 (節點 141) |
|---|---|---|
| 9/10 至 10/12(含兩天高壓負載測試) | 59.7 W | 58.0 W |
| 10 月份(常駐單一 LLM 模型、極少外部請求) | 54.4 W | 54.4 W |
對比 GPU 監控數據(Day 19 的 gb10-textfile),GB10 在這 10 天內的 GPU 功耗軌平均僅有 12.2 W 與 11.4 W,而插座實測為 54 W。這證實了 GPU 功耗僅佔整機功耗的兩成多,絕不能單憑 GPU 指標推算全機電費。
表格採計包含高壓測試在內的長期全機平均值,不再額外做閒置與負載的時間加權,因為加權結果已經如實反映在逐日累計電費中。其餘設備因插座數量有限無法長開實測,改採原廠規格典型值或工程估計值,並在表內嚴謹標註來源。冷氣部分並非實測,而是採用總功耗除以冷氣能源效率標準(CSPF 7.0)推算全年移除廢熱所需的份額上限:
| 設備項目 | 數量 | 平均功耗 (W) | 數據來源 | 每月度數 (kWh) |
|---|---|---|---|---|
| NVIDIA DGX Spark 運算節點 | 2 | 58.9 | 實測(Tapo 逐日能耗) | 85.9 |
| QNAP NAS(主儲存) | 1 | 87.0 | 原廠規格典型值 | 63.5 |
| QNAP NAS(備份副機) | 1 | 40.5 | 原廠規格典型值 | 29.6 |
| PVE 虛擬化節點(Intel 桌機) | 1 | 25.0 | 工程估算 | 18.2 |
| PVE 虛擬化節點(AMD 迷你主機) | 1 | 10.0 | 工程估算 | 7.3 |
| FortiGate 60F 防火牆 | 1 | 10.2 | 規格平均值 | 7.4 |
| FortiAP 221E 無線基地台 | 2 | 12.4 | 原廠規格值 | 18.0 |
| 交換器(2.5G & 10G SFP+) | 1 | 5.0 | 工程估算 | 3.6 |
| 網管交換器 | 1 | 32.8 | 原廠規格最大值 | 24.0 |
| GPU 開發工作站(每日開機 8 小時) | 1 | 80.0 | 工程估算 | 19.5 |
| 機房冷氣(場域散熱份額) | 1 | 54.2 | 熱負載推算(CSPF 7.0) | 39.6 |
| 合計 | 317.0 |
所有數值均維護於 lab/cost.yaml,未來若有新實測數據,只需更新該列即可自動連動。
本場域屬於一般家庭用電(非時間電價累進費率)。依據台電現行電價級距,夏月(6~9 月)與非夏月共有六段累進級距。
計算地端設備電費時,最常見的錯誤是用整張帳單的「平均電價」來算。設備運作是在既有的家庭用電之上「往上疊加」。同樣消耗 317 度電,疊在原本每月只用 78 度的低用電戶,與疊在原本就消耗 800 度的高用電戶,每度電所承擔的邊際電價差非常巨大。
本場域最近一期台電帳單整戶每月用電為 395 度,扣除設備的 317 度,可推得家戶基本生活用電為 78 度。這 317 度的機房用電疊加在 78~395 度區間,橫跨了 120 度以下、121~330 度、331~500 度三個級距。
| 家戶基礎用電(度/月) | 場域全年邊際電費 | 平均每度邊際成本 |
|---|---|---|
| 78 度(本場域實況) | 9,439 元 | 2.48 元/度 |
| 200 度(一般家庭情境) | 11,426 元 | 3.01 元/度 |
| 400 度(中度用電情境) | 16,053 元 | 4.22 元/度 |
| 800 度(小型工作室情境) | 24,282 元 | 6.39 元/度 |
資料顯示,隨著基礎用電不同,一年的邊際電費差距可達 2.6 倍。在這個實際場域與推估模型的低基期環境中,一年機房電費僅需 9,439 元,但如果搬到本來耗電就大的辦公室,年電費將飆升至 24,282 元。較耗電的就會是兩台 NVIDIA DGX Spark 或者是 NVIDIA AI 伺服器、高階顯示卡 Pro 6000 的設備等等,再來則是冷氣機。
設備年限採用內部折舊週期設定,GB10 與工作站設為 4 年,NAS、迷你主機與網路設備設為 5 年,骨幹交換器設為 7 年,二手桌機設為 3 年。購入成本中,GB10 兩台合計 201,800 元,工作站升級卡與記憶體 21,266 元,其餘依台灣通路新品市價估算。防火牆採硬體買斷無額外授權年費,冷氣為既有設備不計折舊。
經精算,地端硬體全年折舊攤提為 97,440 元(其中一半以上為兩台 GB10 的 50,450 元)。加上電費 9,439 元,全場域一年的地端總持有成本(TCO)為 106,878 元。
這就換來一個現實,電費佔比不到一成,硬體折舊才是真正的成本呢。
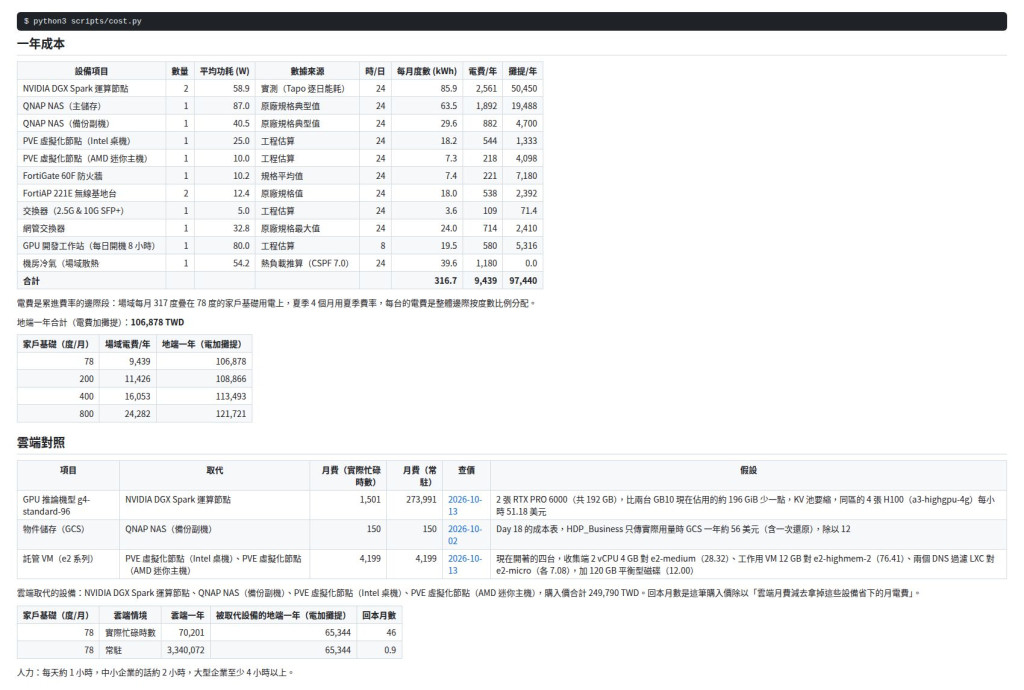
兩台 GB10 具備 256 GB 統一記憶體(Unified Memory),目前實際載入模型佔用約 196 GiB。公有雲上沒有完全對應的機型,在 GCP(asia-east1 台灣機房)中,能塞入同等模型的最小可行規格為 g4-standard-96(配置雙張 RTX PRO 6000,共 192 GB VRAM,每小時 11.70 美元,若選四張 H100 則每小時高達 51.18 美元),但這二套租起來的算力遠超過二台 GB10 所能提供的。備份副機對照 Google Cloud Storage(GCS),虛擬化工作負載則對照四台 e2 系列託管虛擬機器。
以匯率 32.08 計算,我們設定了兩種雲端使用情境:
| 服務項目 | 對應地端取代設備 | 雲端月費(實際忙碌 4 小時) | 雲端月費(全時常駐 730 小時) |
|---|---|---|---|
| GPU 推論執行個體(g4-standard-96) | 兩台 GB10 | 1,501 元 | 273,991 元 |
| 物件儲存服務(GCS 冷儲存) | 備份副 NAS | 150 元 | 150 元 |
| 雲端虛擬機器(e2 執行個體 4 台) | 兩台 PVE 節點 | 4,199 元 | 4,199 元 |
| 每月合計 | 5,850 元 | 278,340 元 |
在計算回本週期時,必須只採計雲端真正能取代的設備(兩台 GB10、備份 NAS、兩台 PVE 節點,購入硬體總價共 249,790 元)。防火牆、交換器與無線網路即使上雲依然不可或缺,不應算入分母:
| 評估情境 | 雲端年費 | 被取代設備的地端年成本(電費+折舊) | 投資回本週期 |
|---|---|---|---|
| 動態開機(每月僅用 4 小時) | 70,201 元 | 65,344 元 | 46 個月(約 3.8 年) |
| 服務常駐(每月 730 小時全開) | 3,340,072 元 | 65,344 元 | 0.9 個月(不到 1 個月) |
這兩個極端情境呈現了近 50 倍的差距:
然而,動態開關機也伴隨著不可忽視的工程隱藏成本,假設需要使用的夠大模型權重達 333 GiB,在 GB10 上啟動載入服務需耗時約 8 分鐘,若在雲端冷啟動,加上拉取映像檔與權重的傳輸時間,根本無法應對即時互動式應用。
在持續執行的 6 個儲存庫中,核心邏輯高度集中在收集端(Collector VM,配置 2 vCPU / 4 GB RAM)。以下是它在台北時間(UTC+8)典型一天的排程工作(Cron Jobs)全景:
| 執行頻率 | 執行工作內容與機制 | 對應章節 |
|---|---|---|
| 每分鐘 | 透過 SSH 執行 nas-textfile.sh 採集兩台 NAS 狀態,以受限的金鑰執行 pve-quorum-textfile.sh 抓取 PVE 節點票數,將 QDevice 仲裁狀態寫入 Prometheus 指標 |
Day 15, 19 |
| 每 5 分鐘 | 執行 gatectl textfile,採集 AI Agent 閘道的決策次數、待審核佇列數與雜湊鏈狀態 |
Day 29 |
| 每 10 分鐘 | 以 1 小時滾動視窗產出三份監控報告:fw-report.py(防火牆阻擋紀錄)、aup-report.py(資安合規雙軌審計)、audit-report.py(管理員動作與變更視窗核對),各自產出 .prom 檔案 |
Day 22, 24, 27 |
| 每 15 分鐘 | 自動 git pull 更新變更儲存庫,changes-textfile.py 記錄維運視窗狀態,drills-textfile.py 彙整讀取五組 drills.jsonl(PVE、NAS、雲端備份、日誌、變更回退) |
Day 20, 26, 28 |
| 每小時 :40, :55 | 從 GB10 與 PVE 節點拉取網路封包擷取批次(使用 rrsync -ro),15 分鐘後對索引驗證 SHA-256 校驗碼 |
Day 23 |
| 每天 07:35 | eol-textfile.py 自動更新軟硬體資產 EOL/EOS 到期日,並連線向 FortiGate 檢查硬體授權狀態 |
Day 25 |
| 每天 08:10, 08:20 | archive-day.sh 將前一個 UTC 日的日誌匯出為 JSONL 並寫入 WORM 唯讀保護儲存,10 分鐘後由 verify-archive.sh 執行完整性比對 |
Day 21, 27 |
| 每週一 08:15 起 | 產出過去 7 天的防火牆事件、AUP 合規與維運稽核等三份週報 | Day 22, 24, 27 |
| 持續監控 | Prometheus Alerting Rules 每分鐘評估,Alertmanager 負責每日告警彙整推播 | Day 20 |
| 每週一 10:00 | 索引儲存庫執行 GitHub Actions CI,全自動驗證所有文章 Tag、SHA 指標與外部連結有效性 | Day 1 |
這張時間表,就是地端「具備長期維運能力」的具體骨架。每一列排程背後,都掛載著「靜默失效偵測規則」,排程一旦卡死或逾期未跑,監控系統立刻發出警報。而這也突顯了收集端目前作為單一故障點(SPOF)的脆弱性。
我們將三十天所建立的規則提煉成一張標準檢核清單:lab/checklist.md。清單中每一條都是能明確回答「Yes / No」的具體問題:
如果任何一題你的環境回答不出來,那一格就是下一張架構改善工單的題目。
這張清單最後一段列出的缺漏,比已完成的部分更值得省思:
systemd-journald 尚未配置自動上傳。approval_exception),缺乏第二雙眼睛的交叉審查,如果把閃光也加進去就會有二人進行更好的審查。在這三十天的實務中,有三件事不斷被驗證:
Day 28 進行回退演練時,原本預期停用 syslogd3 會遺失大量日誌,實測卻發現緩衝區機制極佳,斷線十分鐘僅遺失一筆紀錄。Day 29 預期 AI 模型會嘗試調用未授權工具,但實測 MCP 客戶端在前端就嚴格阻絕了管道。甚至今天完稿前,還誤以為 UPS 負載可以輕鬆換算瓦數。沒有親自動手驗證的預期,即便寫在報告裡再合情合理,也終究只是未經證實的假設。
Day 28 意外發現主 NAS 的日誌早在 25 小時前就已中斷,回溯後確認整整漏收了 28 小時。這段期間,收集端的防火牆規則默默丟棄封包,而異常稽核指標 AuditUnattributedActions 顯示的卻是歲月靜好的數值 0。UPS 指標也是如此,設備回傳 -1,Prometheus 採集到的 Sample 卻永遠是 1。
一般的監控規則只能抓出採集器死掉了,卻抓不出採集器正常跑,但來源端送出假資料。身為維運工程師,看到儀表板上的 0 與 1 時,必須追問它背後的真實意圖。
在這個系列中,所有的工單核准都由同一人執行,如實記錄 approval_exception,在 Day 29,在 AI 協作下生成、再由工程師手動驗證執行,在今天的成本核算中,也明確區分出哪些數字是插座實測、哪些只是規格估算。
誠實地記錄系統的限制與取捨,遠比假裝系統完美無瑕有用得多。真正專業的稽核員與資深工程師,看得懂這背後的價值。
# 1. 儲存庫對照驗證:比對 series.yaml 與 README,確保文章與程式碼一致
python3 scripts/render.py && python3 scripts/check.py --offline

# 2. 成本模型驗證:檢查欄位完整性與手算單元測試
python3 scripts/cost.py --check
python3 -m unittest discover tests

# 3. 產出 Markdown 成本報表與 JSON 結構化資料
python3 scripts/cost.py
python3 scripts/cost.py --json

# 4. 查詢 GPU 負載統計(過去 30 天內 GPU 使用率 > 10% 的累計小時數)
curl -s 'http://127.0.0.1:9090/api/v1/query' \
  --data-urlencode 'query=count_over_time((gb10_gpu_utilization_percent > 10)[30d:1m]) / 60'
三十天前,這套地端環境只停留在服務跑得起來的實驗室狀態。
三十天後,它每分鐘自動仲裁叢集票數、每十分鐘稽核系統變更與防火牆阻擋、每天清晨完成防竄改日誌封存、每週一自我驗證整個專案的程式碼索引。任何系統改動都留有工單可查,缺少工單會主動告警,架構回退曾被親手驗證,AI Agent 的存取被牢牢限制在閘道後方。
全場域一年耗電不到一萬元台幣,設備硬體攤提接近十萬,每天需要花費約一個小時的人力維運。
它仍舊是小型的地端環境,資料收集端也有單點故障風險,部分網路設備仍飄在在監控視線之外。但所有的邊界已清楚標記在 Checkist 之中,未來仍有機會持續改善(Continual Improvement),這也是 ISO 27001 資訊安全管理系統最重要的訴求和功能,PDCA(規劃-執行-檢查-行動)的循環架構,再來個 30 天吧。: P
v1.0.0 / part-3
參考資料
lab/cost.yaml
Day 1|系列規劃與場域總覽:從跑得起來到可長期維運,先談為什麼要封裝
Day 2|Container Station 薄殼架構:QPKG 骨架、生命週期腳本與狀態頁
Day 3|版本鎖定與供應鏈:image digest、SHA256SUMS 與授權檔
Day 4|GitHub Actions 自動打包與 release:從 git tag 到可驗證的套件
Day 5|案例 Jellyfin 與 Roon:硬體轉碼的裝置直通與主機網路
Day 6|案例 changedetection.io 與 Homepage:資安與資訊公告監看 + 整合入口
Day 7|在地自建 ComfyUI 的生存指南:自建 Image 鎖定、GPU 直通與三層目錄架構
Day 8|案例實戰:Open WebUI + Ollama 重構記,把專案回到通用框架會省下什麼呢?
Day 9|容量規劃:用模型與硬體搭配矩陣決定地端節點與儲存規格
Day 10|上游引擎一改版,地端 AI 環境用的配方壞了怎麼辦 ? patch 移植實戰紀錄
Day 11|DGX Spark 節點基線:DGX OS 初始設定、帳號與 SSH 加固
Day 12|熱與統一記憶體守護:取樣器、自動降載與長時間負載實測
Day 13|別讓節點踩爆模型!NFS 集中模型庫的單寫多讀、權限凍結與完整性治理
Day 14|儲存規劃與路徑實測:RAID 60 與 RAIDZ2 試算,SSD、NFS、iSCSI 載入時間解析
Day 15|Proxmox VE 雙節點 HA:Virtualization Station 上的 QDevice
Day 16|Proxmox VE 備份與還原:HDP for Business Beta 的排程、保留與還原演練
Day 17|儲存設備備份策略與還原演練:快照、HBS 3 與 3-2-1 備份策略
Day 18|3-2-1 的最後一步:異地物件儲存、保留政策與冷熱資料成本精算
Day 19|指標收集:把前十八天的取樣器接進同一個時間序列
Day 20|儀表板與告警,打造一個簡潔的單一面板
Day 21|日誌集中與保存:節點不裝新代理,封存要能比對
Day 22|被擋下的封包才是便宜情報:從防火牆靜默盲點到日誌降噪與自動化告警
Day 23|日誌找不到原因?從 tcpdump 最小權限封包擷取到 WORM 封存的網路排錯實戰
Day 24|稽核問「某台工作站上個月連到哪裡了」?FortiGate AUP 雙軌日誌實踐:線上 LogsQL 檢索與離線對帳修煉
Day 25|資產生命週期與授權 EOL 監看:到期日只是一個數字,通通收進 Prometheus 時間序列!
Day 26|變更管理實戰:串起 Git 變更單、監控與日誌,讓每次改動都有跡可循
Day 27|自動化稽核比對:當機器留下的日誌,對上工程師寫的變更單(VictoriaLogs × FortiGate × PVE)
Day 28|Rollback 實戰演練:沒真正執行過的復原步驟,永遠只是一場美麗的假設
Day 29|打造地端維運的 AI 圍欄:Agent 授權閘道實作,無工單即無工具,無核准即無不可逆變更
Day 30|完賽總結|算清一年的電費、硬體折舊與雲端代價:地端 AI 維運 30 天留下的真實資產


 iThome鐵人賽
 看影片追技術