
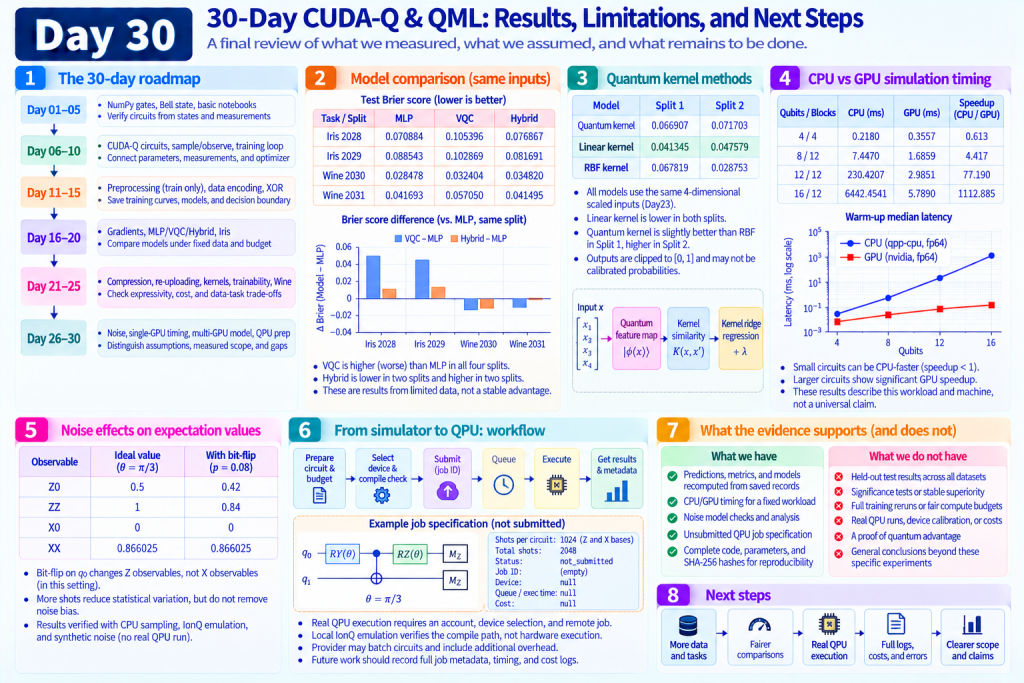
Day 29 用本地理想抽樣、硬體後端預演與合成雜訊核對小電路輸出,並留下尚未提交的 QPU 工作規格。今天把整條路線收束成一份可回查的結論:哪些數字來自實測、哪些來自模型假設、哪些問題仍未回答。
想像一間工作室清點工具與成品:每一件都標上「量過/只推算過/還沒試過」。準確率、計時比值、噪聲曲線看起來都像「結果」,但若不連同資料切分、輸入資訊與執行條件一起讀,就很容易把不同層級的證據揉成一句總評。本章沿著量子基礎、CUDA-Q 電路、QML 建模與硬體執行準備,從保存的預測與計時重新計算指標,讓結論能追溯到原始紀錄。
本日實作是證據彙整程式與測試。它從既有 JSON 重新核算分類指標、模型選擇與計時比例,產生系列證據報告及來源雜湊清單。本章使用保存的候選與選定結果,未追加訓練。
Day30 audits the series as an evidence chapter: it recalculates metrics from saved Day20–29 records, separates model comparisons, simulator timing, noise checks, and unsubmitted QPU plans, and states what the small experiments support versus what still needs held-out data, fair controls, full cost logs, and physical hardware runs. No historical experiments were rerun end-to-end.
CUDA-Q 是執行量子程式的工具;QML 是量子機器學習。本系列用 CPU/GPU 模擬量子電路;QPU 則是真實量子處理器。後端是實際執行計算的工具;本地預演只驗證編譯與模擬流程,並非硬體執行。量子優勢需要在明確任務與條件下,證明量子方法相對於適當傳統方法的優勢——不能只由 GPU 模擬加速推論。
| 階段 | 實作內容 | 現在能做的事 |
|---|---|---|
| Day01–05 | NumPy 量子閘、Bell 狀態、基礎實驗筆記本 | 從狀態與量測核對電路 |
| Day06–10 | CUDA-Q 量子電路程式、sample/observe、反覆更新參數的訓練流程 | 把參數、量測與最佳化器串起來 |
| Day11–15 | 僅使用訓練資料的前處理、資料編碼、XOR 分類器 | 保存訓練曲線、模型保存檔與分類邊界 |
| Day16–20 | 梯度、MLP/VQC/Hybrid、Iris 二分類 | 在固定資料與預算下比較模型 |
| Day21–25 | 壓縮層、資料重複編碼、核函數、可訓練性、Wine | 檢查表達方式、成本與資料任務的關係 |
| Day26–30 | 噪聲、單 GPU 計時、多 GPU 模型、QPU 預演、證據彙整 | 分辨模型假設、實測範圍與部署缺口 |
NumPy 是 Python 數值運算套件。量子閘改變量子狀態;Bell 態具有糾纏,兩個量子位元無法各自獨立描述。sample 回傳量測抽樣計數;observe 計算量測結果依機率加權的平均(期望值)。XOR 任務在兩個輸入不同時標為 1、相同時標為 0;分類邊界是模型區分不同類別的分界。
資料編碼將輸入轉成量子操作;壓縮層把多個特徵合併成較少數值;資料重複編碼讓同一輸入在電路中再次影響操作。最佳化器依損失或梯度更新權重;可訓練性描述這種更新是否容易有效改善目標。
關鍵轉變是開始能追問:「這個結果是怎麼得到的?」每個準確率都可以追溯到資料切分、前處理規則、參數選擇、後端與輸出格式。
完整 30 篇文章與每日可執行檔清單在彙整報告。檔案齊全代表程式與紀錄存在,不表示今天重跑過全部歷史實驗。
Day 20 的 Iris 二分類使用 99 筆去重資料,每組資料切分的測試資料只有 21 筆;Day 25 的 Wine 二分類使用 119 筆,每組資料切分的測試資料為 26 筆。兩天各有兩組資料切分,不能把它們當大量獨立重複。詳見Day20 報告與Day25 報告。
訓練資料用來建立前處理規則與更新權重;驗證資料用來選擇候選模型;測試資料在選定後評分。隨機種子控制資料打亂或起始權重,方便重現同一組設定。
PCA(主成分分析)將原始特徵組合成較少的新座標;PCA2 表示保留兩個主成分。MLP(多層感知器)是傳統神經網路;VQC(變分量子分類器)透過調整電路角度學習;Hybrid 結合傳統運算與量子電路。
Brier 分數是預測值與 0/1 標籤的平均平方誤差,越小越接近標籤。準確率只看分類是否正確;混淆矩陣分別記錄各真實類別被判成哪些類別。
下面只比較同一天、同資料切分、同 PCA2 輸入的 MLP/VQC/Hybrid。數字是選定模型的測試資料 Brier,越小越好:
| 任務/資料切分 | MLP | VQC | Hybrid |
|---|---|---|---|
| Iris 2028 | 0.070884 | 0.105396 | 0.076867 |
| Iris 2029 | 0.088543 | 0.102869 | 0.081691 |
| Wine 2030 | 0.028478 | 0.032404 | 0.034820 |
| Wine 2031 | 0.041693 | 0.057050 | 0.041495 |
VQC 在這四個配對的 Brier 都比 MLP 高。Hybrid 有兩個配對較低、兩個較高;Wine 2031 差值只有約 −0.000198。這些是有限資料上的描述,不足以做穩定優勢或顯著性主張。重新核算表
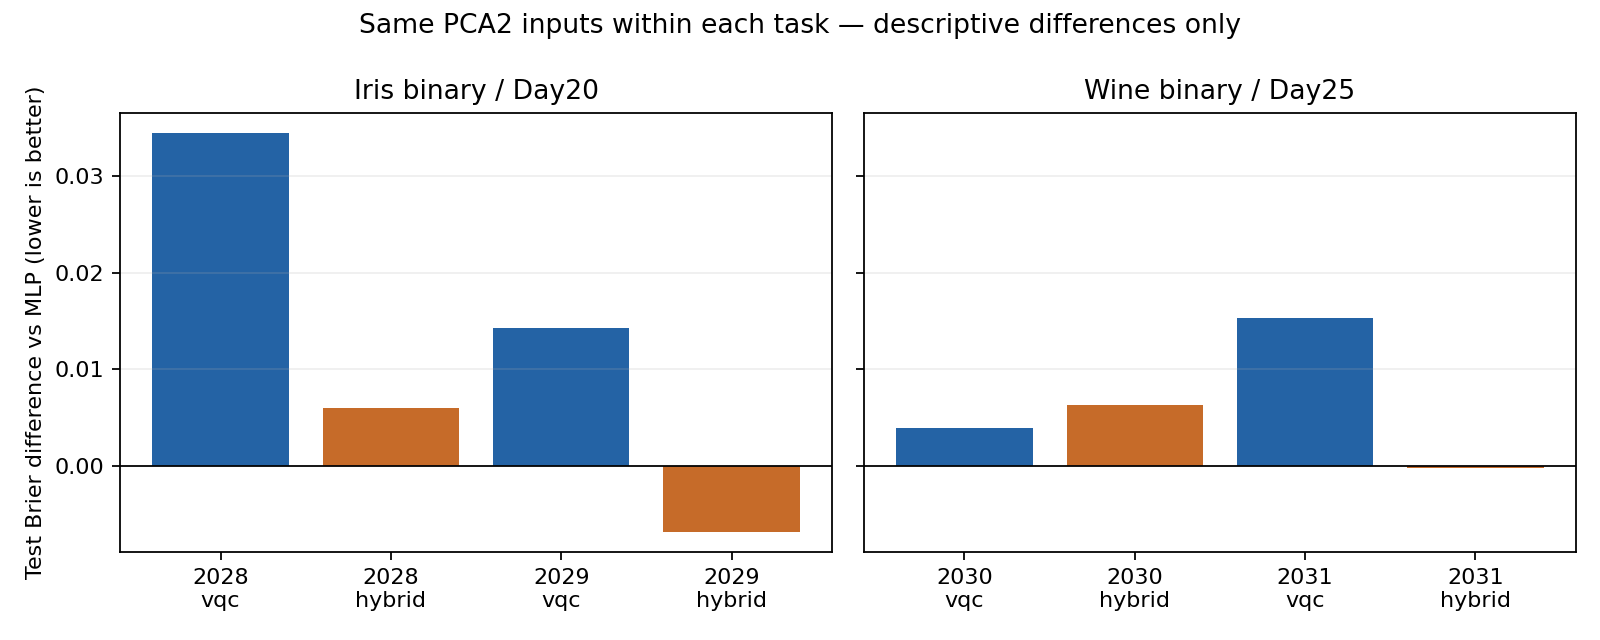
顯著性主張需要評估差異是否超出隨機波動;本章表格只是保存結果的比較,未完成這類推論。目標函數是訓練時希望降低的誤差;收斂表示繼續更新後結果趨於穩定。
不同模型有不同參數量;相同目標函數評估預算也不等於相同更新步數、時間或充分收斂。因此這份對照支持「在這套固定協定下得到這些結果」,不能推出某個模型族已達最佳表現。
Logistic13 將十三個標準化特徵加權後,以 sigmoid 函數轉成 0 與 1 之間的值。標準化先減去訓練平均值,再除以描述分散程度的標準差。電路深度是必須依序完成的操作層數。
Day 25 還保留看到全部 13 維特徵的 logistic13:Wine 2031 的測試資料 Brier 為 0.032224。它是實用完整輸入比較基準,與 PCA2 模型的輸入資訊不同,不能用來單獨歸因量子層效果。分析模型表現時,應先檢查降維是否丟失任務所需的資訊,再評估電路深度。
量子特徵映射將每筆輸入轉成量子狀態;量子核函數計算兩筆狀態的相似度。相似度矩陣保存樣本兩兩比較的數值;核嶺迴歸利用這張矩陣求出樣本係數,再加權組合成預測。λ 是正則化強度,用來限制預測函數大小,降低過度迎合訓練資料的風險。
Day 23 改用固定量子特徵映射與傳統核嶺迴歸。它沒有訓練量子權重,仍然需要檢查相似度矩陣、λ 選擇及完整前處理。
線性核依輸入內積衡量相似度;本章引用的版本另含常數項。內積是將對應特徵相乘後相加。RBF(徑向基底函數)依資料間距離計算相似度,距離越遠,相似度越低。
兩個資料切分的量子核測試 Brier 分別為 0.066907、0.071703;線性核為 0.041345、0.047579;RBF 為 0.067819、0.028753。量子核在第一組略低於 RBF,第二組較高;線性核在兩組都較低。Day23 報告
這三者使用相同四維縮放輸入;Day 20 則是 PCA2。即使來自 Iris,也不能把跨日結果合併成隔離單一因素的比較。核嶺迴歸將超出 [0, 1] 的分數截斷到邊界,也不保證機率已校準——例如輸出 0.8,不一定對應約八成的實際發生率。
本系列完成兩種 QML 建模路徑:可訓練電路與固定量子核函數。兩條路都需要傳統模型比較基準、資料切分與完整成本紀錄。
fp64 是以 64 位元保存實數的雙精度格式。暖機是在正式計時前先執行數次,降低首次準備工作的影響;延遲是呼叫開始到結果可用的等待時間。以下速度比均為 CPU 時間中位數除以 GPU 時間中位數;中位數是多次結果排序後的中間值。
Day 27 依序量測相同電路、相同權重與 fp64 條件下的 CPU/GPU 暖機後延遲。小電路 4 量子位元/4 區塊的 CPU/GPU 約 0.613,當時 CPU 較快;16 量子位元/12 區塊約 1112.885,當時 GPU 較快。Day27 原始報告
OpenMP 是 CPU 平行運算機制;此處只用一個執行緒。RY/RZ 分別繞 Y 與 Z 軸旋轉;CZ 是受控相位閘;全域 Z 量測將所有位元的 ±1 記分相乘後取平均。
這個比值有明確的比較條件:qpp-cpu、單一 OpenMP 執行緒、特定 RY/RZ/CZ 電路、全域 Z 量測量的直接期望值計算。它不是對最佳傳統機器學習系統的比較,也不是 GPU 普遍快千倍。Day 30 重新核算了全部 8 組 fp64 配對,而非只留下最大的比例。
還有一個容易混淆的事實:Day 20/25 共 28 次訓練都是 NumPy CPU 參考計算;這兩天的 CUDA-Q 訓練呼叫次數皆為 0。 CUDA-Q CPU/GPU 核對的是凍結模型的電路求值。不能拿 NumPy 訓練時間除以 GPU 求值時間,稱為 QML 訓練加速。
早期 Day 10 確實執行了 CUDA-Q 反覆更新參數的訓練流程;兩件事並不衝突。每個實驗都需要分別記錄訓練使用的計算工具,才能正確解讀訓練與驗證的成本。
凍結模型表示保持已訓練的權重與資料處理規則不變。位元翻轉以機率 p 交換 0 與 1;q0 是第 0 個量子位元。ZZ 對兩位元結果相同記 +1、不同記 −1,再取平均。
Day 26 對凍結 Wine VQC 的末端 q0 加入位元翻轉。資料切分 2030 在 p=0 時 Brier 約 0.032404,p=.3 時約 0.124883;準確率卻同為 96.15%。Day26 報告
原因是這個特定噪聲位置將 ZZ 期望值乘上正的縮放係數,分數往 0.5 靠近但未必越過分類門檻。分類標籤可以不變,預測品質仍然變差。只看準確率,會漏掉這種變化。
一次 shot 是一次狀態準備與量測;抽樣變異是有限次量測造成的統計波動。校準資料記錄真實裝置當時的操作與誤差特性。
Day 29 用另一個可解析電路確認:更多 shots 會降低抽樣變異,卻不會將合成噪聲下的 ZZ 期望值 0.84 恢復成理想值 1。三模式的 90 組計數全部在本地執行,這不是硬體校準資料。Day29 報告
梯度描述參數小幅改動時目標函數的變化率;初始化是設定起始權重。
Day 24 也讓「梯度小」這句話更具體:需要一起看初始化、量子位元數、深度與目標涵蓋的量子位元範圍。那一天的 768 個初始化、1,536 個單參數梯度是小規模診斷,沒有證明所有量子神經網路(QNN)在規模持續增加時是否仍容易訓練,更不能直接推論分類準確率。Day24 報告
| 問題 | 本系列證據 | 尚缺的證據 |
|---|---|---|
| 單 GPU 是否能加速此模擬? | Day27 特定設定實測 | 其他 CPU 調校、電路與規模 |
| 多 GPU 能提高多少容量/速度? | Day28 可重現假設模型 | 真實多卡、互連、分散與最高記憶體用量量測 |
| 硬體後端能否編譯此小電路? | Day29 IonQ 本地預演 | 遠端裝置接收與實際執行 |
| 真實 QPU 是否有實用 QML 優勢? | 本系列未測量 | 同任務品質、端到端成本與可重複硬體結果 |
互連是 GPU 之間交換資料的連線;分散運算將同一工作拆給多個裝置。端到端成本包括資料處理、訓練、量測、等待與取得結果的整段流程。
Day 28 的 16 組容量、12 組延遲情境有公式與比較基準來源,但沒有多 GPU 實測。Day 29 的 2048-shot 工作規格仍為 not_submitted,實體 QPU 工作數為 0。排隊與費用是未知值,不是零。
因此,本系列既沒有證明量子優勢,也沒有證明 QML 不可能有用。它將下一步需要驗證的問題縮小到能實際設計實驗的程度。
evidence.py 不用啟動 CUDA-Q,直接讀保存的資料並執行以下核對:
JSON 是保存結構化資料的文字格式;SHA-256 是由檔案內容計算的摘要,用來確認來源版本是否一致。
輸出 evidence.json、報告與 Brier 差值圖。--check 會比較當前來源、彙整 JSON 及報告;來源或結果變動時要求重新產生,避免舊結論悄悄沿用新實驗。
.venv 是專案獨立保存套件的虛擬環境;Matplotlib 是繪圖套件;MPLCONFIGDIR 指定其設定與快取目錄。
# 產生彙整與圖表;沿用既有環境,不需 GPU 或帳號。
MPLCONFIGDIR=/tmp/day30-matplotlib .venv/bin/python articles/day30/evidence.py

# 純標準函式庫核對,沒有 GPU 或 Matplotlib 也能執行。
python3 articles/day30/evidence.py --check

# 彙整邏輯、損壞資料與保存結果測試。
python3 -m unittest discover -s articles/day30 -p 'test_*.py'
依賴入口:requirements-day30.txt。重跑只覆寫 results/day30/ 的本日產物。這是保存資料的一致性核對,不是重新計算所有模型電路求值、證明全部前處理無誤或重跑 30 天 GPU 測試;舊實驗的時間戳記與限制仍保留在原日報告。
以下是本專案的後續實驗規格,尚未執行。各項實驗需要先訂定足以影響模型選擇的品質與成本條件。
| 問題 | 下一個實驗 | 事先約定的判讀方式 |
|---|---|---|
| 模型差異是否穩定? | 用新的評估設計與保留資料,比較相同輸入的傳統模型/VQC/Hybrid | 先定最小實用 Brier 改善幅度、重複規格與成本上限,再看測試資料 |
| 瓶頸是不是資訊壓縮? | 配對完整輸入比較基準、PCA、可訓練壓縮層與資料重複編碼 | 分開報告表達方式、輸入資訊與最佳化器預算,不只比參數量 |
| 有限 shots 會否改變選模? | 凍結候選模型,對固定量測次數預算重複評估驗證資料 | 檢查排名與預測不確定性;不以測試資料反覆選 shot 數 |
| GPU 收益能否延伸? | 固定精度與電路,增加合理 CPU 執行緒對照和記憶體量測 | 保留全部設定與原始時間;容量、延遲、吞吐量分別報告 |
| QPU 硬體落差有多大? | 選定可用裝置後,先執行 Day29 的小型已核對工作 | 保存工作、校準、shots、編譯、排隊、費用,再決定是否搬模型 |
容量表示能容納多大的狀態;延遲表示單次工作等待多久;吞吐量是每秒完成多少工作。三者需要分開量測。保留資料是建模與選參數時不查看、留待最後評估的資料。
目前 Iris/Wine 結果已在開發過程中被反覆看過;即使每一天遵守驗證資料選參數,也不應把這些測試資料當成永遠未見的資料。下一輪若要做更強主張,需要新的保留評估設計。
如果 QML 沒有達到事先定義的實用品質或成本條件,就保留較簡單的傳統模型方案。若在充分對照後出現可重複差異,再投入更大的模擬或硬體預算。這是一個能被結果改變的決策流程。
本章核對的是既有保存資料的一致性:20 個選定模型的 60 組指標、Day26 的 18 組噪聲評估、Day27 的 8 組 fp64 中位數比值、Day28 假設模型的基準雜湊,以及 Day29 本地 280,320 shots 與未提交狀態。系列已建立可訓練、可核對、可重現的工程流程。
本章沒有重訓模型、重跑全部歷史 GPU 測試或提交實體 QPU。現有小型實驗不足以證明量子優勢,也不足以否定 QML 的潛在用途。GPU 模擬加速≠完整 QML 訓練加速≠量子優於經典;本地預演≠真實硬體結果。
後續若要評估 QML 在特定任務中的用途,仍需依任務需求設計完整的品質與成本對照,並以新的保留資料與事先訂定的判讀標準為準。
本章數值取自專案保存的實驗紀錄。數值入口為Day20、Day23、Day24、Day25、Day26、Day27、Day28、Day29。
方法與官方後端文件見 REFERENCES.md,實作行為以各章固定的軟體版本為準。完整 30 天目錄、Roadmap。
[N1] Shreeya Sanjeev Gokhale et al. “A review of quantum machine learning algorithms, applications, and emerging advantages.” Discover Computing 29, 226 (2026);綜述論文。原始來源;完整書目。
本章彙整品質、成本與限制;這篇綜述可銜接後續研究方向。外部文獻提供比較脈絡,本章數值仍以專案保存的實驗紀錄為準。



 iThome鐵人賽
 看影片追技術