
二元搜尋樹靠「左小右大」決定往哪邊找(每個節點左子樹裡的鍵值都比它小,右子樹裡的都比它大),搜尋、插入、刪除都只要沿著一條路往下走,時間是 O(h),h 是樹高。樹長得矮時,h 大約是 log₂ n;但如果把資料由小到大依序插入,每個新節點都接在最右邊,整棵樹變成一條鏈,搜尋就退化成 O(n)。
解決辦法是:每次插入或刪除後,檢查樹有沒有長歪,歪了就馬上調整回來。這類會自己維持平衡的二元搜尋樹,稱為平衡二元搜尋樹,最早被提出的就是 AVL 樹,名稱取自提出者 Adelson-Velsky 和 Landis 的姓氏開頭。
作為系列的最後一篇,先把 AVL 樹介紹完,最後再回頭看看這三十天走過的路。
以下 n 代表節點數,h 代表樹高:樹根在第 1 層,最深的節點在第幾層,樹高就是多少;空樹的高度是 0。範例假設鍵值不重複。
每個節點都可以算出它的平衡因子(balance factor):
平衡因子 = 左子樹的高度 − 右子樹的高度
正的代表左邊比較高,負的代表右邊比較高,0 代表一樣高。AVL 樹是一棵二元搜尋樹,而且每個節點的平衡因子都只能是 −1、0 或 1,也就是左右子樹的高度最多差 1。接下來的圖中,節點右上角的數字都是平衡因子。
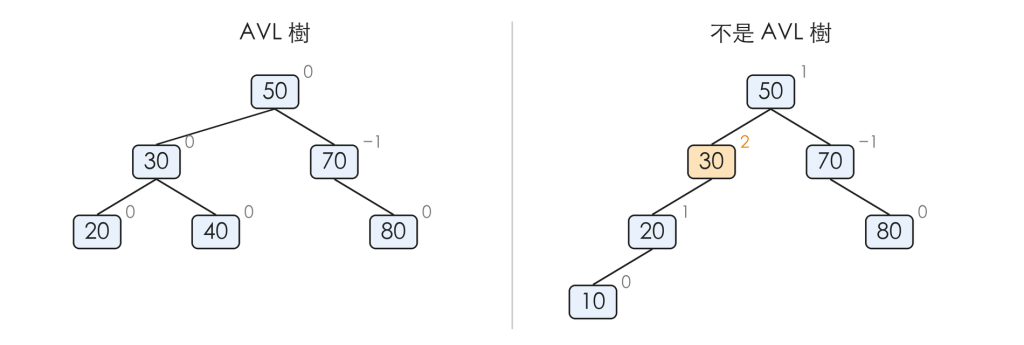
右邊那棵樹,樹根的平衡因子沒問題,但 30 的平衡因子是 2,所以它不是 AVL 樹。規定針對每一個節點,只檢查樹根是不夠的。
插入新節點後,從新節點往上一路到樹根,有些節點的子樹變高了,平衡因子可能變成 ±2。從新節點往上找到的第一個這樣的節點,就是要調整的地方,以下稱為失衡的節點 A。
調整的方法稱為旋轉(rotation):只改幾個指標,讓某個子節點升上來、A 降下去,同時維持左小右大。
新節點插在 A 的左子節點的左子樹,稱為 LL 型。設 A 的左子節點是 B,下圖的橘色圓點代表新節點:
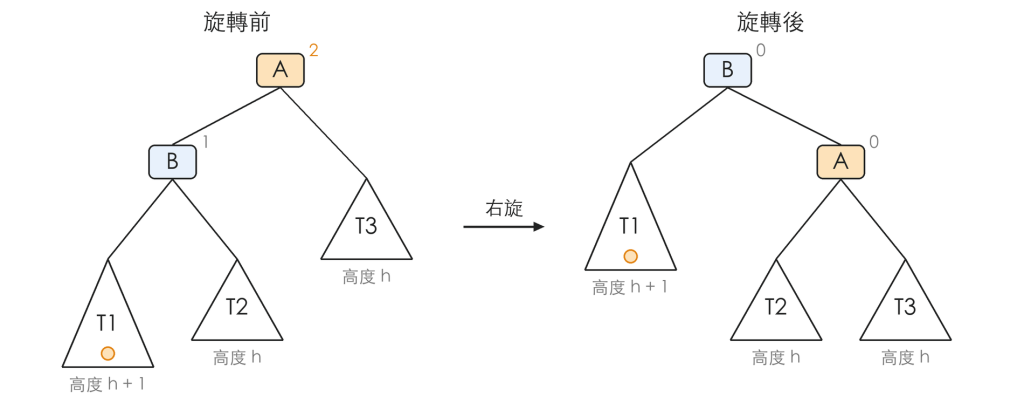
T2 的鍵值都比 B 大、比 A 小,放到 A 的左邊不會破壞左小右大,中序走訪仍然是 T1、B、T2、A、T3。旋轉後 A 和 B 的平衡因子都是 0,整棵子樹的高度也回到插入新節點之前,所以上面的祖先不需要再調整。
新節點插在 A 的右子節點的右子樹,稱為 RR 型,做法是右旋的左右對調:A 的右子節點升上來,它原本的左子樹改接到 A 的右邊。
新節點插在 A 的左子節點的右子樹(LR 型)時,只轉一次會從往右彎變成往左彎,仍然不平衡,要轉兩次:
效果是讓 A 的孫節點直接升到 A 原本的位置。四種情況的判斷方法是:從失衡的節點 A 出發,看往新節點走的前兩步。
| 類型 | 前兩步 | 調整方法 |
|---|---|---|
| LL | 左、左 | 對 A 右旋 |
| RR | 右、右 | 對 A 左旋 |
| LR | 左、右 | 先對 A 的左子節點左旋,再對 A 右旋 |
| RL | 右、左 | 先對 A 的右子節點右旋,再對 A 左旋 |
依序插入 50、40、30、60、70、55、35,四種情況剛好都會遇到。
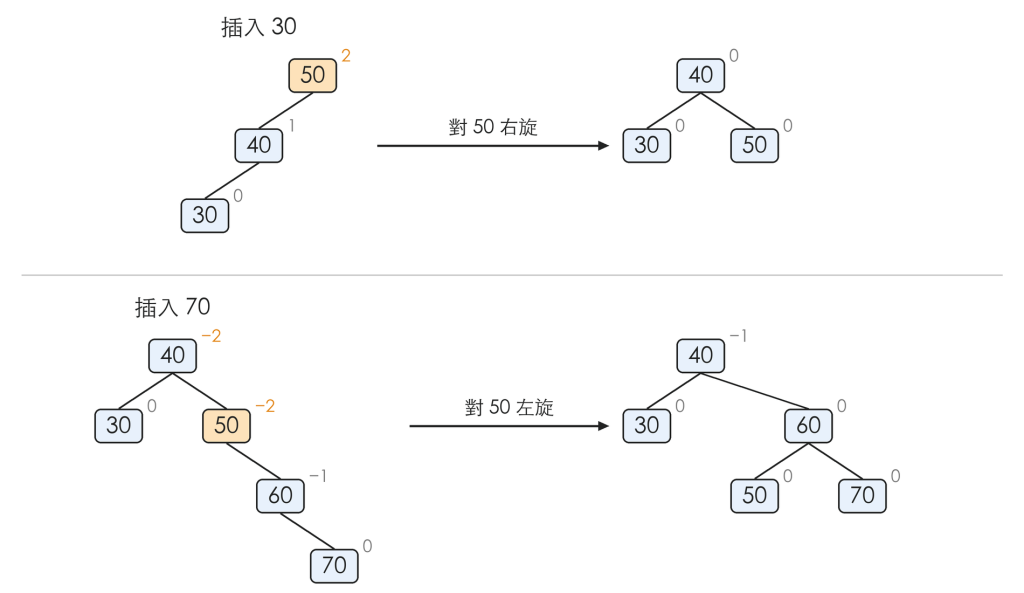
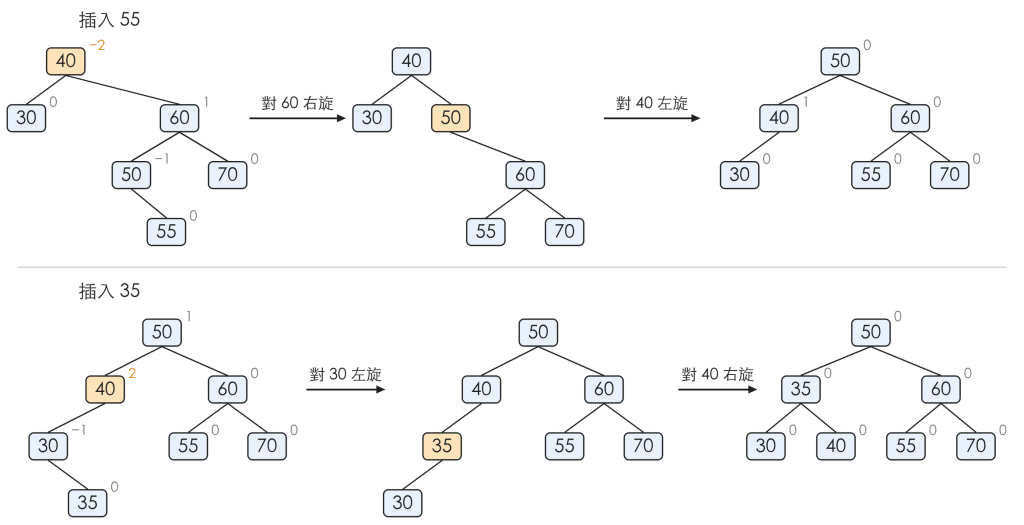
每次插入最多只調整一處(LL、RR 轉一次,LR、RL 轉兩次),因為轉完後失衡那棵子樹的高度就回到插入之前,上面的祖先不會再因為這次插入而失衡。
最容易讓二元搜尋樹變成一條鏈的,是由小到大依序插入:
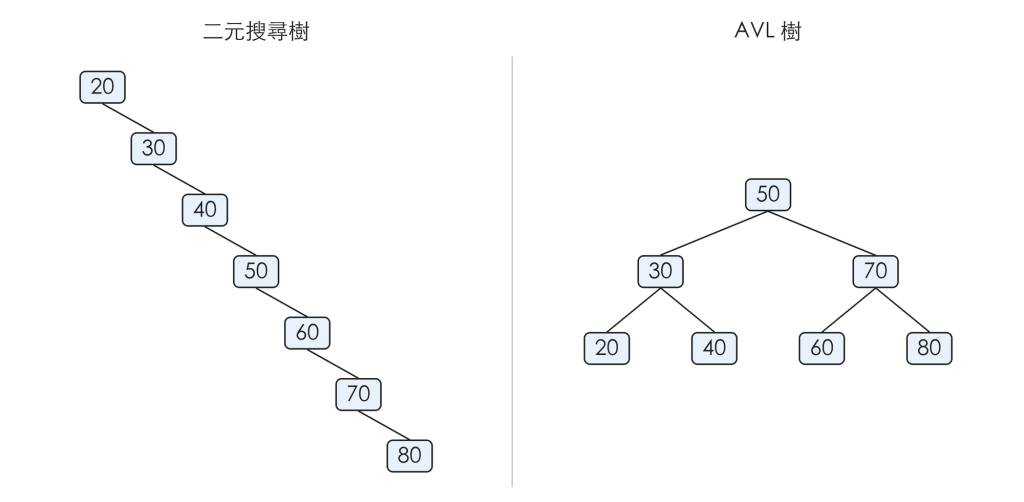
每個節點多存一個 height 欄位,平衡因子用左右子樹的高度相減算出來。插入用遞迴寫:先照二元搜尋樹的方式往下插入,遞迴返回時由下往上更新高度、檢查平衡因子,需要時就旋轉。
#include <stdio.h>
#include <stdlib.h>

typedef struct Node {
    int key;
    int height; /* 以這個節點為根的子樹高度,葉節點為 1 */
    struct Node *left;
    struct Node *right;
} Node;

int height(const Node *node) {
    return node == NULL ? 0 : node->height; /* 空樹高度為 0 */
}

int max(int a, int b) {
    return a > b ? a : b;
}

void updateHeight(Node *node) {
    node->height = 1 + max(height(node->left), height(node->right));
}

int balanceFactor(const Node *node) {
    return height(node->left) - height(node->right);
}

/* 右旋:左子節點 child 升上來,child 原本的右子樹改接到 node 的左邊 */
Node *rotateRight(Node *node) {
    Node *child = node->left;
    node->left = child->right;
    child->right = node;
    updateHeight(node);
    updateHeight(child);
    return child;
}

/* 左旋:右子節點 child 升上來,child 原本的左子樹改接到 node 的右邊 */
Node *rotateLeft(Node *node) {
    Node *child = node->right;
    node->right = child->left;
    child->left = node;
    updateHeight(node);
    updateHeight(child);
    return child;
}

Node *createNode(int key) {
    Node *node = malloc(sizeof(Node));
    if (node == NULL) {
        printf("記憶體不足\n");
        exit(1);
    }
    node->key = key;
    node->height = 1;
    node->left = NULL;
    node->right = NULL;
    return node;
}

/* 插入 key,回傳調整後這棵子樹的根 */
Node *insert(Node *node, int key) {
    if (node == NULL) {
        return createNode(key);
    }
    if (key < node->key) {
        node->left = insert(node->left, key);
    } else if (key > node->key) {
        node->right = insert(node->right, key);
    } else {
        return node; /* 鍵值重複,不插入 */
    }

    updateHeight(node);
    int bf = balanceFactor(node);

    if (bf > 1 && key < node->left->key) {
        printf("  插入 %d:%d 失衡,LL 型,右旋\n", key, node->key);
        return rotateRight(node);
    }
    if (bf < -1 && key > node->right->key) {
        printf("  插入 %d:%d 失衡,RR 型,左旋\n", key, node->key);
        return rotateLeft(node);
    }
    if (bf > 1 && key > node->left->key) {
        printf("  插入 %d:%d 失衡,LR 型,先左旋再右旋\n", key, node->key);
        node->left = rotateLeft(node->left);
        return rotateRight(node);
    }
    if (bf < -1 && key < node->right->key) {
        printf("  插入 %d:%d 失衡,RL 型,先右旋再左旋\n", key, node->key);
        node->right = rotateRight(node->right);
        return rotateLeft(node);
    }
    return node;
}

void preorder(const Node *node) {
    if (node != NULL) {
        printf("%d ", node->key);
        preorder(node->left);
        preorder(node->right);
    }
}

void inorder(const Node *node) {
    if (node != NULL) {
        inorder(node->left);
        printf("%d ", node->key);
        inorder(node->right);
    }
}

void freeTree(Node *node) {
    if (node != NULL) {
        freeTree(node->left);
        freeTree(node->right);
        free(node);
    }
}

void buildAndShow(const int keys[], int count) {
    Node *root = NULL;

    for (int i = 0; i < count; i++) {
        root = insert(root, keys[i]);
    }
    printf("  前序:");
    preorder(root);
    printf("\n  中序:");
    inorder(root);
    printf("\n  樹高:%d\n", height(root));
    freeTree(root);
}

int main(void) {
    const int mixed[] = {50, 40, 30, 60, 70, 55, 35};
    const int sorted[] = {20, 30, 40, 50, 60, 70, 80};

    printf("依序插入 50 40 30 60 70 55 35\n");
    buildAndShow(mixed, 7);

    printf("依序插入 20 30 40 50 60 70 80\n");
    buildAndShow(sorted, 7);
    return 0;
}
執行結果:
依序插入 50 40 30 60 70 55 35
  插入 30:50 失衡,LL 型,右旋
  插入 70:50 失衡,RR 型,左旋
  插入 55:40 失衡,RL 型,先右旋再左旋
  插入 35:40 失衡,LR 型,先左旋再右旋
  前序:50 35 30 40 60 55 70
  中序:30 35 40 50 55 60 70
  樹高:3
依序插入 20 30 40 50 60 70 80
  插入 40:20 失衡,RR 型,左旋
  插入 60:40 失衡,RR 型,左旋
  插入 70:30 失衡,RR 型,左旋
  插入 80:60 失衡,RR 型,左旋
  前序:50 30 20 40 70 60 80
  中序:20 30 40 50 60 70 80
  樹高:3
node->left = ... 或 return 接住,父節點的指標就會改指向升上來的節點。node 的高度,再更新升上來的 child:node 已經變成 child 的子節點,child 的高度要用到 node 的新高度。輸出的中序都是由小到大,代表旋轉沒有破壞左小右大。
反過來問:高度 h 的 AVL 樹,最少要有幾個節點? 節點最少時,樹根一邊高度 h − 1、另一邊 h − 2,兩邊也都用最少的節點。設 N(h) 是最少節點數:
h ≥ 2 時,N(h) = N(h − 1) + N(h − 2) + 1;N(0) = 0、N(1) = 1。
| 高度 h | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 |
|---|---|---|---|---|---|---|---|---|
| 最少節點數 | 1 | 2 | 4 | 7 | 12 | 20 | 33 | 54 |
這和費氏數列一樣以指數速度成長:想讓高度多一層,就得增加越來越多節點。反過來說,n 個節點撐起的高度只會以對數速度增加,所以 AVL 樹的高度是 O(log n)。
| 操作 | 二元搜尋樹(最壞) | AVL 樹(最壞) |
|---|---|---|
| 搜尋 | O(n) | O(log n) |
| 插入 | O(n) | O(log n) |
| 刪除 | O(n) | O(log n) |
代價是程式比較複雜,更新時要多花時間維護高度與旋轉。另一種常見的平衡二元搜尋樹是紅黑樹(red-black tree),對平衡的要求比較寬鬆,樹可能稍高一點,但刪除時最多旋轉三次,不會像 AVL 樹那樣可能一路往上轉。
| 主題 | 核心觀念 |
|---|---|
| 基礎 | 演算法的特性、抽象資料型態(ADT)、用 Big-O 分析時間與空間 |
| 陣列 | 連續記憶體,用索引 O(1) 存取;中間插入、刪除要搬移資料 |
| 鏈結串列 | 用指標把節點串起來;找到操作位置與必要的前一個節點後,插入、刪除只需改指標,但不能用索引直接跳到中間 |
| 堆疊與佇列 | 後進先出(LIFO)與先進先出(FIFO),可以用陣列或鏈結實作 |
| 樹 | 二元樹的走訪、引線二元樹、累堆、二元搜尋樹、AVL 樹 |
| 圖 | 相鄰矩陣與相鄰串列、DFS 與 BFS、最小成本生成樹、最短路徑 |
| 排序 | 從 O(n²) 的基本排序,到平均 O(n log n) 的快速排序、最壞也是 O(n log n) 的合併與累堆排序,再到基底排序 |
如果要用一句話串起這三十天,大概是:同一份資料,用不同的結構存放,擅長的操作就不同。以找一筆資料為例,未排序的陣列要 O(n),排好序的陣列可以二分搜尋 O(log n),二元搜尋樹最壞會退化成 O(n),AVL 樹則保證 O(log n)。選擇資料結構,就是在問:這份資料最常做什麼操作?哪些操作慢一點沒關係?記憶體夠不夠?
AVL 樹在「左小右大」之外,再要求每個節點的左右子樹高度最多差 1。插入造成失衡時,用單旋轉或雙旋轉調整一處就能恢復平衡。樹高因此保持 O(log n),搜尋、插入、刪除的最壞時間也都是 O(log n),代價是要額外維護高度與旋轉。
今日重點:
三十天的資料結構之旅到這裡就結束了。從一個陣列、一個指標開始,到會自己轉回平衡的樹,每一種結構都是為了讓某些操作變快而設計的,也都有它付出的代價。不過資料結構的世界還很寬廣,真的不是三十天就能學完:這個系列把我學習資料結構時讀到的內容分主題整理出來,還有很多來不及介紹,例如平均 O(1) 搜尋的雜湊表(hash table)、資料庫常用的 B 樹,以及紅黑樹。有了這三十天的基礎,就能用同樣的方式分析它們的優缺點。謝謝一路讀到這裡的你,希望下次寫程式、面對一堆資料時,你會先停下來想一想:這些資料,該用什麼結構來放?



 iThome鐵人賽
 看影片追技術