
目前介紹過的排序方法,有最壞要 O(n²) 的選擇、插入、氣泡排序,平均 O(n log n) 的快速排序,以及最壞 O(n log n) 的合併與累堆排序。收尾前再認識兩種想法很不一樣的方法:讓插入排序大步跳的謝耳排序(Shell sort),以及不靠比較大小決定順序的基底排序(radix sort),最後把全部方法放在一起比較。
以下 n 代表資料筆數,範例沿用前面排序方法使用的 8 筆資料:
26 59 1 61 5 15 11 37
插入排序每次只能把資料往旁邊移一格;如果最小的資料在最後面,就得一格一格搬過所有資料。謝耳排序以提出者 Donald Shell 命名,做法是先讓相隔很遠的資料比較、交換:
間隔為 1 時就是一次普通的插入排序,所以最後一定會排好。前面幾輪先讓資料更接近排好,通常能減少最後一輪的搬移;但這不是保證,遇到不利的資料,最後一輪仍可能搬很多次。這裡的間隔從 n / 2 開始每次除以 2,8 筆資料依序是 4、2、1:
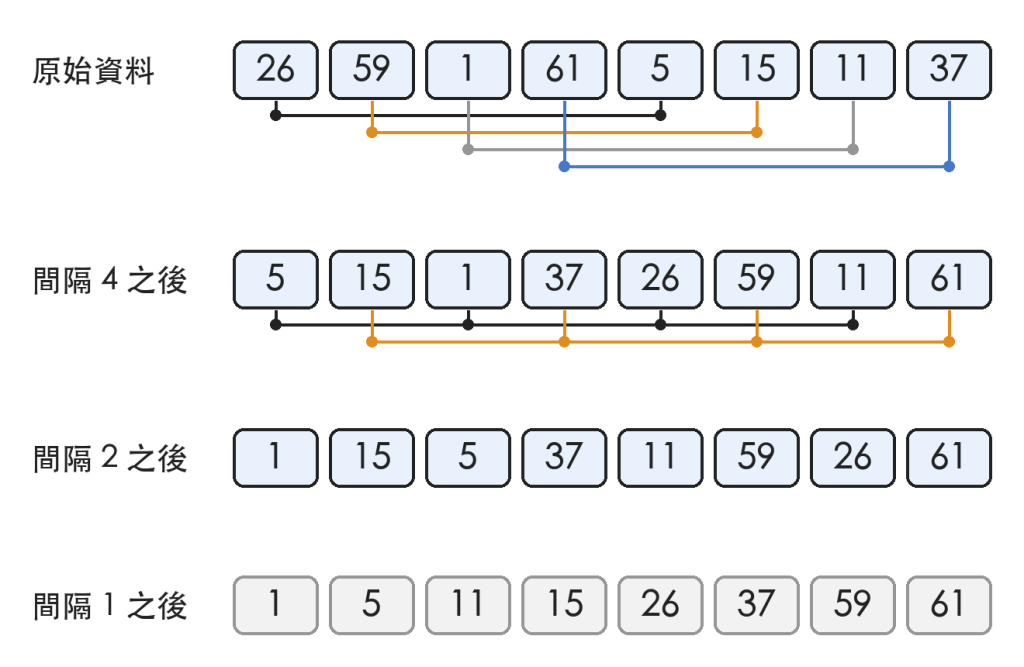
圖中第一列是原始資料,之後每一列是做完一輪後的結果;資料下方的連線把下一輪同一組的資料連起來:
謝耳排序的時間和間隔序列有很大的關係:每次除以 2 的版本最壞仍是 O(n²),換用更好的間隔序列可以更快,實際上通常比插入排序快很多。它只在原陣列裡搬移,額外空間 O(1);但資料會跨組大步移動,所以不穩定。例如「8、紅 3、黑 3、9」,間隔 2 時 8 和黑 3 同一組,黑 3 跳到最前面,變成「黑 3、紅 3、8、9」,兩張 3 的順序就顛倒了。
整理一疊寫了數字的卡片,可以準備 0~9 號 10 個桶子:先依個位數把卡片丟進對應的桶子,再從 0 號到 9 號依序收回;接著依十位數再丟一次、收一次。卡片上若都是最多兩位數的非負整數,這樣就排好了;位數更多時,就繼續處理百位、千位。這就是基底排序。基底(radix)是數字系統的底數,十進位的基底就是 10。從最低位開始處理的版本稱為 LSD(least significant digit)基底排序。
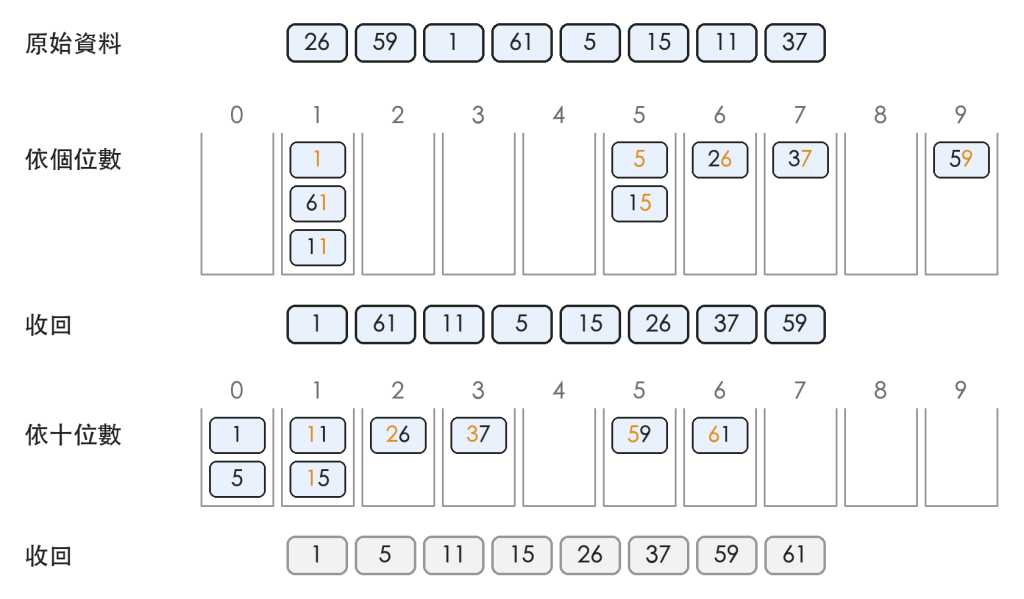
圖中每一輪先依橘色的那一位把資料分配到桶子,再從 0 號桶子到 9 號桶子依序收回。依十位數那一輪,1 和 5 沒有十位數,當成 0 放進 0 號桶子。
有兩個關鍵:
設 d 是最大值的位數(分配幾輪),r 是基底(桶子數),每一輪花 O(n + r),總時間 O(d(n + r)),額外空間 O(n + r),而且是穩定的。d 和 r 都不大時(例如大量的郵遞區號),時間可視為 O(n)。限制是鍵值必須能拆成一位一位,例如非負整數或固定長度的字串;負數、小數要另外處理。
謝耳排序就是插入排序外面多一層間隔的迴圈,搬移時一次跳 gap 格。基底排序不真的為每個桶子準備佇列,而是用計數:先數每個桶子有幾筆,累加後得到各桶子的結束位置,再從原陣列最後一筆往前放進對應的桶子,這樣同一個桶子裡就會維持原本的順序。
#include <stdio.h>

#define SIZE 8
#define RADIX 10

void printArray(const int data[], int length) {
    for (int i = 0; i < length; i++) {
        printf("%d ", data[i]);
    }
    printf("\n");
}

/* 謝耳排序:間隔 gap 從 n / 2 開始每次減半,對相隔 gap 的資料做插入排序 */
void shellSort(int data[], int length) {
    for (int gap = length / 2; gap >= 1; gap /= 2) {
        for (int i = gap; i < length; i++) {
            int key = data[i];
            int j = i - gap;
            while (j >= 0 && data[j] > key) {
                data[j + gap] = data[j]; /* 一次往後搬 gap 格 */
                j -= gap;
            }
            data[j + gap] = key;
        }
        printf("間隔 %d 之後:", gap);
        printArray(data, length);
    }
}

/* 基底排序(LSD):從個位數開始,依每一位數字分配到 0~9 號桶子,再依序收回 */
void radixSort(int data[], int length) {
    if (length < 0 || length > SIZE) {
        printf("資料筆數必須介於 0 和 %d 之間\n", SIZE);
        return;
    }
    if (length == 0) {
        return; /* 沒有資料,不讀取 data[0] */
    }
    for (int i = 0; i < length; i++) {
        if (data[i] < 0) {
            printf("這個版本只處理非負整數\n");
            return;
        }
    }

    int max = data[0];
    for (int i = 1; i < length; i++) {
        if (data[i] > max) {
            max = data[i];
        }
    }

    int output[SIZE];
    for (int place = 1; ; ) {
        int count[RADIX] = {0};

        for (int i = 0; i < length; i++) {
            count[(data[i] / place) % RADIX]++; /* 每個桶子各有幾筆 */
        }
        for (int d = 1; d < RADIX; d++) {
            count[d] += count[d - 1]; /* 累加後,是 0~d 號桶子的累計筆數 */
        }
        for (int i = length - 1; i >= 0; i--) {
            int digit = (data[i] / place) % RADIX;
            output[--count[digit]] = data[i]; /* 由後往前放,同一個桶子保持原本順序 */
        }
        for (int i = 0; i < length; i++) {
            data[i] = output[i];
        }
        if (place == 1) {
            printf("依個位數分配後收回:");
        } else if (place == 10) {
            printf("依十位數分配後收回:");
        } else {
            printf("依位值 %d 分配後收回:", place);
        }
        printArray(data, length);

        if (place > max / RADIX) {
            break; /* 已處理最高位,先結束,避免 place 乘以 10 時溢位 */
        }
        place *= RADIX;
    }
}

int main(void) {
    int shellData[SIZE] = {26, 59, 1, 61, 5, 15, 11, 37};
    int radixData[SIZE] = {26, 59, 1, 61, 5, 15, 11, 37};

    printf("謝耳排序\n");
    shellSort(shellData, SIZE);

    printf("基底排序\n");
    radixSort(radixData, SIZE);
    return 0;
}
執行結果:
謝耳排序
間隔 4 之後:5 15 1 37 26 59 11 61
間隔 2 之後:1 15 5 37 11 59 26 61
間隔 1 之後:1 5 11 15 26 37 59 61
基底排序
依個位數分配後收回:1 61 11 5 15 26 37 59
依十位數分配後收回:1 5 11 15 26 37 59 61
(data[i] / place) % RADIX 取出某一位數字:place 是 1 時取個位數,是 10 時取十位數。處理完最高位就結束,不再把 place 乘以 10,避免很大的整數溢位。為了讓範例簡單,這個版本只處理 0~SIZE 筆非負整數,不符合時會印出提示並直接返回。
除了基底排序,前面所有方法都靠「比較兩筆資料的大小」決定順序,稱為比較排序(comparison sort)。比較排序在最壞情況下至少要比較約 n log₂ n 次。
原因可以用猜數字來想:n 筆互不相同的資料有 n! 種排列,排序就是要猜出眼前是哪一種。每次比較只有「是」或「否」兩種結果,k 次比較最多只能區分 2^k 種情況,所以必須 2^k ≥ n!,也就是 k ≥ log₂(n!),而 log₂(n!) 大約是 n log₂ n。
所以合併排序和累堆排序的 O(n log n),在比較排序中已經是最好的了。基底排序不靠比較鍵值大小決定順序,而是依每一位數字分配位置,才能不受這個下限限制。
n 代表資料筆數;基底排序中,d 是位數、r 是基底。
| 方法 | 最好的情況 | 平均 | 最壞的情況 | 額外空間 | 穩定 |
|---|---|---|---|---|---|
| 選擇排序 | O(n²) | O(n²) | O(n²) | O(1) | 否 |
| 插入排序 | O(n) | O(n²) | O(n²) | O(1) | 是 |
| 氣泡排序 | O(n) | O(n²) | O(n²) | O(1) | 是 |
| 謝耳排序 | O(n log n) | 沒有簡單的公式 | O(n²) | O(1) | 否 |
| 快速排序 | O(n log n) | O(n log n) | O(n²) | 平均 O(log n),最壞 O(n) | 否 |
| 合併排序 | O(n log n) | O(n log n) | O(n log n) | O(n) | 是 |
| 累堆排序 | O(n) | O(n log n) | O(n log n) | O(1) | 否 |
| 基底排序 | O(d(n + r)) | O(d(n + r)) | O(d(n + r)) | O(n + r) | 是 |
表中氣泡排序的最好情況,指的是有「沒有交換就提早結束」檢查的版本;謝耳排序指的是每次間隔除以 2 的版本。累堆排序最好情況的 O(n),是在允許重複值(例如全部相同)時;鍵值互不相同時為 O(n log n)。快速排序的平均表現則假設鍵值互異、排列隨機。
實際的函式庫常把幾種方法組合起來。例如許多 C++ 標準函式庫的 std::sort 平常用快速排序,遞迴太深時改用累堆排序,段落很短時再用插入排序收尾。
謝耳排序讓資料先跨大步移動,再用插入排序收尾;基底排序依位數分配資料,每一輪都要維持原本的順序。比較排序的最壞情況有 n log n 等級的下限,基底排序利用鍵值的位數,才有機會更快。選方法時,要一起考慮資料量、排列狀況、穩定性和記憶體。
今日重點:
排序的旅程到這裡告一段落。最後一篇回到搜尋:把排好序的資料依序插入一般二元搜尋樹,樹會長成一條鏈,單次搜尋退化成 O(n)。固定拿最左邊當基準的快速排序,也會因為分割不平均而退化成 O(n²)。有沒有一種二元搜尋樹,每次插入後都會檢查自己有沒有長歪,歪了就自己「轉」回來?下一篇就來認識 AVL 樹。


 iThome鐵人賽
 看影片追技術