
Anthropic 在 2026 年 9 月 28 日推出 Claude Sonnet 5.5,是 Claude 5.5 家族的第二款模型。官方說法很明確:比上一代的 Sonnet 5 快三成以上,多數工作的成本最多降低三成,單價不變。
看到這種數字,實務上要問的通常不是「它有多強」,而是「我手上這些活換過去,會不會真的省」。底下不談願景,只列出三個可以自己動手檢核的觀察點,以及一個幾乎一定會踩到的成本陷阱。
封面為 AI 生成示意圖。
定位上,官方把 Sonnet 5.5 描述成 Opus 5.5 的「更快、成本更低的補充」:需要謹慎判斷的複雜工作交給旗艦,目標明確的日常工作交給它。官方點名的強項是修 bug、產出文件、製作簡報與表格。
規格方面,模型 ID 是 claude-sonnet-5-5,上下文視窗 1M token,輸入接受文字與圖片,輸出為文字,同時支援 Anthropic Messages 與 OpenAI 相容兩種協定。價格與上一代相同:每百萬 token 輸入 2 美元、輸出 10 美元;快取讀取從 0.20 降到 0.10 美元,官方說明是砍半。
跑分方面,官方公布的終端機類編碼評測 Terminal-Bench 4.0 拿到 70.6%,比 Opus 5.5 的 66.4% 還高;知識工作類的 GDPval-AA 是 1844 對 1846,幾乎並駕齊驅。但長任務編碼 FrontierCode 1.1 是 46.2% 對 54.4%,差了 8 個百分點。
讀這類數字要留意兩件事。一是跨代幅度太大的項目,通常代表評測條件也變了:Sonnet 5 在 Terminal-Bench 是 10.3%,這一代跳到 70.6%,直接讀成「能力漲了七倍」並不合理。二是官方自己在同一頁寫了限定——在這個能力水準上,跑分的邊際差距已不是現實差異的可靠指標。分數用來定方向,定不了你的活。
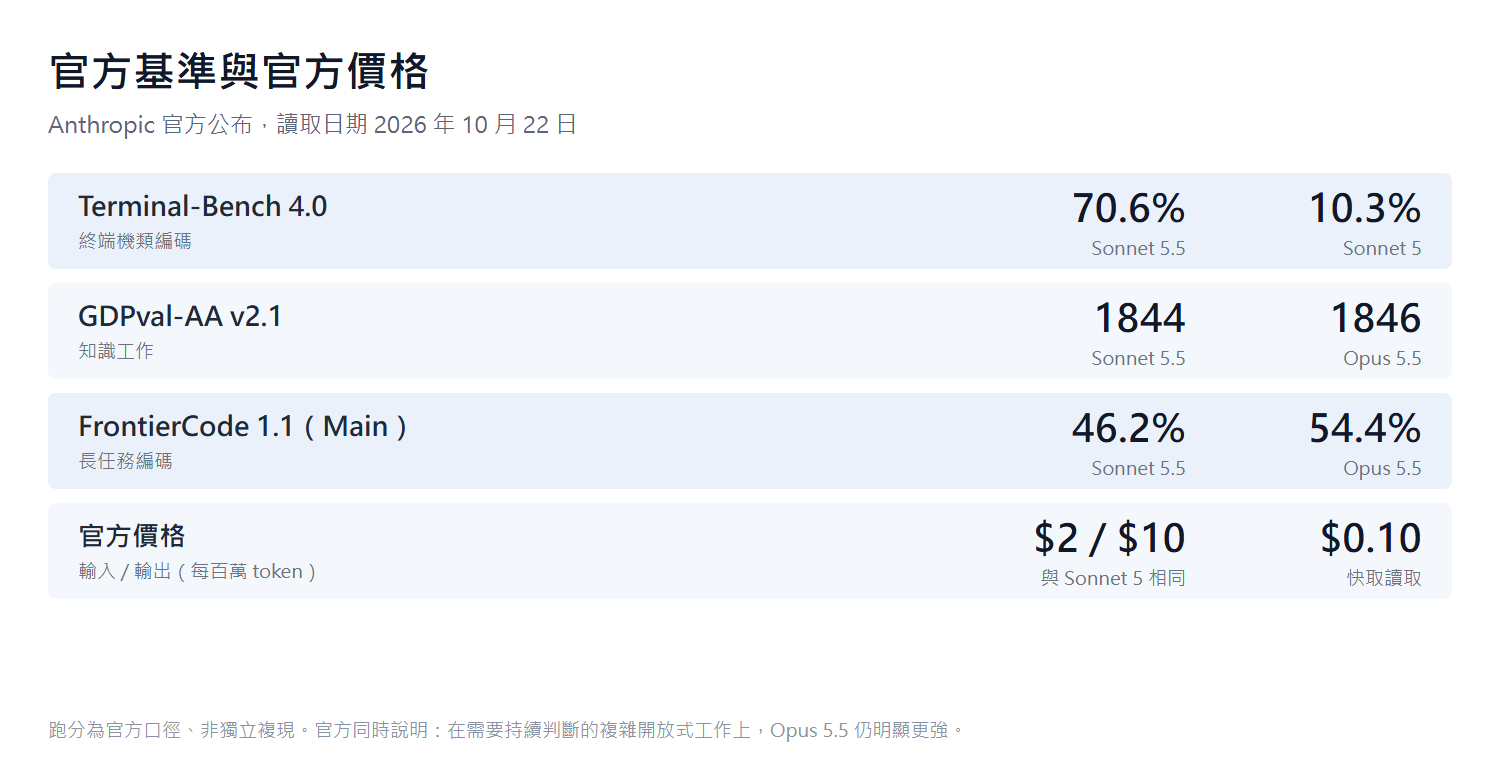
上表把官方公布的評測分數與價格放在一起,資料於 2026 年 10 月 22 日核對。
另外有三項沒有查到確切數字,這裡不猜:最大輸出 token 上限、知識截止日期,以及能不能關閉思考。要放進正式專案之前,直接看控制台的模型詳情頁最準。
這是三個檢核點裡最關鍵的一個,因為成本幾乎完全由輸出長度決定——輸出每百萬 token 是 10 美元,輸入是 2 美元,差了五倍。
同一次呼叫,輸出長度可以差到十倍以上。以 2026 年 10 月 22 日透過相容介面實際呼叫的結果為例:把五筆維運紀錄整理成 Markdown 表格,輸出 628 個 token;把六筆錯誤日誌抽成固定欄位的 JSON,輸出 410 個 token;但如果要求「給出完整改寫後的程式碼,不要省略任何部分」,輸出會衝到 5753 個 token。前兩者單次成本約在千分之幾美元,後者一次就接近 0.06 美元。
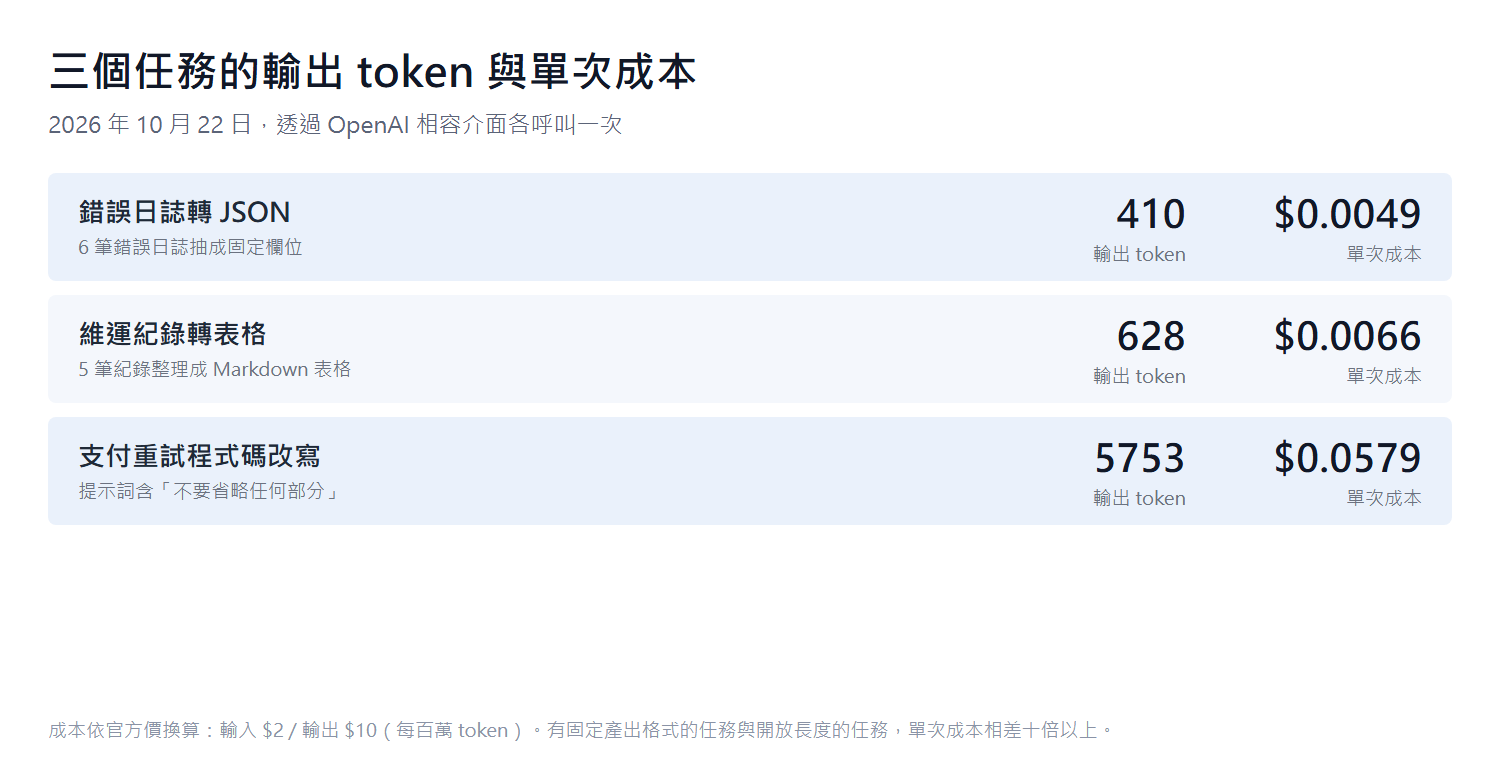
三種任務各自呼叫一次的實測用量與換算成本。
差別不在模型,而在任務有沒有天然的終點。表格、JSON、抽取、分類這類工作,模型知道什麼時候算寫完;「交出完整實作」這種要求沒有終點,它會一路寫到自認完整為止。
所以檢核的方式很簡單:把你的提示詞拿出來看,裡面有沒有「不要省略」「盡可能完整」「詳盡說明」這類字眼。 有的話,對成本敏感的批次任務就該改成明確的格式與篇幅上限。
第二個檢核點看的是快取,這一項在單價表上不顯眼,卻常常是帳單的主要來源。
代理(agent)與編碼類工作,每一輪都會重送系統提示詞、工具定義和檔案脈絡,這些重複前綴正是快取命中的部分。快取讀取從 0.20 降到 0.10 美元,等於這一塊直接砍半;對高頻呼叫的專案,實際省下的金額可能比輸入輸出的單價看起來更多。
反過來說,如果你的呼叫都是「每次全新的短文、沒有重複前綴」,那這一項對你幾乎沒有影響,也不該拿它當換模型的理由。
推理投入是可以調的。官方資料顯示,Sonnet 5.5 在 Low 或 Medium 檔就能超過 Sonnet 5 的最好成績,而 Medium 是 Claude 應用程式裡的預設檔。
這代表兩件事:其一,升級時不要沿用舊的檔位設定,先從低檔測起,測不過再往上加;其二,檔位本身就是成本旋鈕,同一個任務在高檔下會「想」得更久、吐更多 token,單價優勢會被 token 量吃掉。
實際設定時,記得 max_tokens 要給足。設得太小,答案會在程式碼中間被硬生生切斷,但介面照樣回傳 200、不會報錯:
resp = client.chat.completions.create(
    model="claude-sonnet-5-5",
    max_tokens=8000,          # 設太小會被截斷;表格類任務 1500 就夠
    messages=[{"role": "user", "content": "..."}],
)

print(resp.usage.completion_tokens, resp.choices[0].finish_reason)
一定要回讀 finish_reason。 等於 length 就代表內容被截斷,必須重跑,不能直接拿去用。這個欄位不看,很容易誤判成「模型寫得不完整」。
前面三個檢核點都指向同一件事,這裡把它講成一個具體的陷阱。
同一個提示詞、同樣不設 effort,把「改寫支付重試程式碼」交給兩代模型:Sonnet 5 用 4012 個輸出 token 收尾,Sonnet 5.5 寫到 5753 個才收尾,多用了 43%;換算成本,從 0.0405 美元變成 0.0579 美元。產出的字元數也從 3267 漲到 6924,翻了一倍以上。
官方說「多數工作成本最多降三成」,這筆帳看起來完全相反。三個可能的原因,依可能性排序:
一是指令本身的問題最大。 提示詞裡那句「不要省略任何部分」,對能力越強的模型越像「多寫一點」的授權——它給了更完整的實作、更多註解、更長的取捨說明。這句話是人加的,不是模型的問題。
二是兩代預設檔位可能不同。 官方公開資料只說明 Medium 是應用程式裡的預設檔,API 端的預設值沒有查到確切說明;如果新一代預設「想得更久」,輸出自然更長。
三是任務沒有天然終點。 這正好和檢核點一互相印證。
結論不是「新一代更貴」,而是官方那個三成是典型工作量的平均,不是每個任務的保底承諾。固定產出格式的活可以直接按三成做預算;開放長度的活必須自己量一遍。
| 任務類型 | 建議 | 不合適時的替代 |
|---|---|---|
| 日常寫功能、修 bug、寫測試 | 適合,終端機類編碼評測甚至高於旗艦 | 卡在長任務就換 Opus 5.5 |
| 轉表格、抽欄位、分類、文件與簡報 | 很適合,輸出 token 比上一代省三到四成 | — |
| 讀截圖、看報表與圖表 | 適合,圖表辨識無工具得分從 15.6% 升到 61.6% | 密集圖表先裁切關鍵區域 |
| 需要完整實作的開放式編碼 | 能用,但輸出長度要自己控 | 先刪掉提示詞裡的「不要省略」再測 |
| 複雜開放式問題、長週期判斷、跨庫大遷移 | 不適合,這類活官方自己劃給旗艦 | 改用 Opus 5.5 |
Sonnet 5.5 的定位很實用:把上一代旗艦的能力下放到日常檔,價格留在中檔。終端機類編碼反超旗艦,知識工作貼齊旗艦,單價與上一代相同、快取讀取砍半。
它的成本規律也很清楚:有固定產出格式的任務,單次成本在千分之幾美元;開放長度的任務,省不省取決於你怎麼寫提示詞。 換過去之前,拿自己手上三個典型任務各跑一次,把輸出 token 記下來,比讀任何評測都有用。
價格、可用地區與模型規格都會變動,實際操作前請以官方公告與帳戶顯示為準。
內容為 AI 輔助撰寫,以官方公開資料與實際介面呼叫結果為依據,並於 2026-10-22 核對。

一、API 端 effort 預設就是 high(官方 What’s new 文件有寫),文中推測「API 預設值沒查到」並不正確。思考 token 計入輸出計費,這也是你測到輸出膨脹最直接的可能原因,而不只是提示詞的問題。
二、文中說「查不到能不能關閉思考」。官方文件寫得很清楚:Sonnet 5.5 送 thinking: disabled 會回 400,最低只能用 between_tools,而且它不能搭配 xhigh/max。這屬於升級的五項破壞性變更之一,對已經在跑 Sonnet 5 的系統來說,這才是升級前最需要檢查的,文中完全沒提。
純觀念宣導文就先不必了,且是被檢舉到怕了?這篇完全不敢提你最愛的crazyrouter欸?你還沒解釋為什麼你家的crazyrouter在使用claude模型會比直接用claude code便宜欸?
 17802032796

 iThome鐵人賽
 看影片追技術