
「幫我看一下這份合約有沒有問題。」
很多人是在打完這句話之後,才突然想到:我剛剛是不是把公司的機密文件,交給了別人的伺服器?
這個擔心是對的,但方向經常搞錯。
多數人以為風險在「模型會不會把我的檔案背下來」。實際上,模型是這條路上最不會留下東西的一環。
要講清楚這件事,得先看你的檔案走過哪些地方。
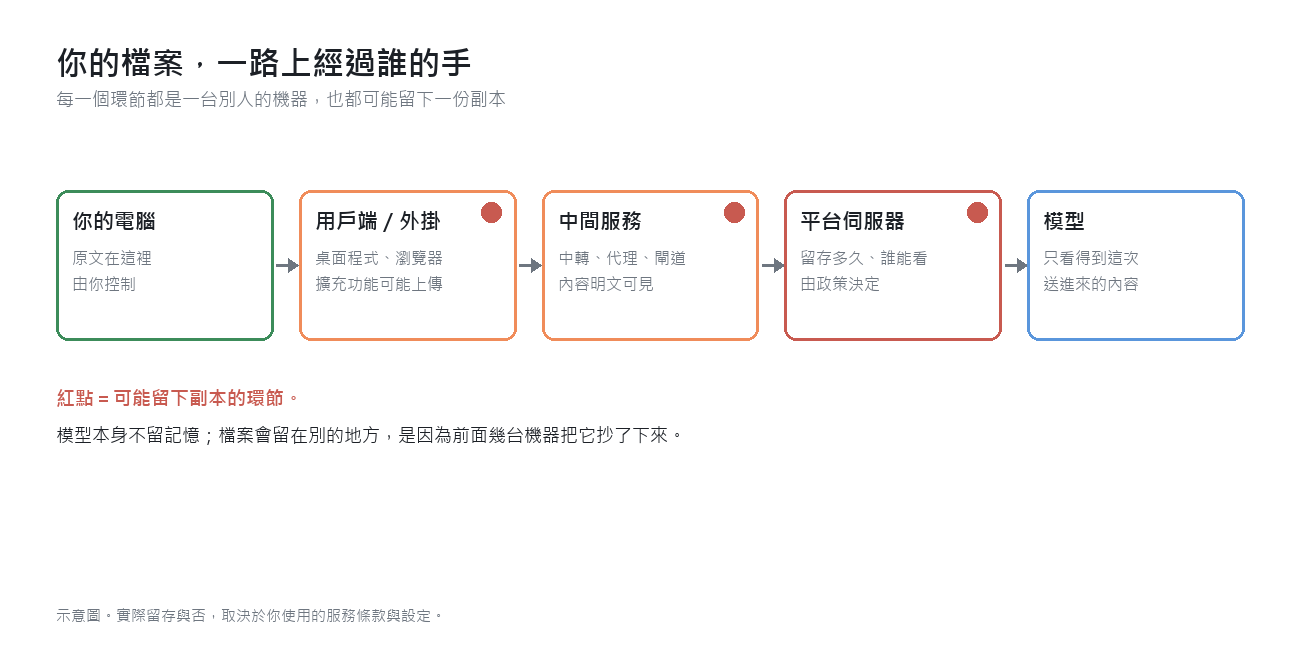
從你按下送出,到看見回答,中間大致有這幾站:
你的電腦。 原文在這裡,這是你唯一完全控制的地方。
用戶端或外掛。 桌面程式、瀏覽器擴充功能。這一站很容易被忽略——它可能把檔案先上傳到開發商自己的伺服器,再轉給模型。
中間服務。 如果你用的是中轉、代理或閘道,那麼在檔案抵達模型之前,這一站看得到完整明文。
平台伺服器。 也就是提供模型的那一方。留存多久、誰能看、會不會拿去訓練,都由這裡的政策決定。
模型。 它只看得見這一次送進來的內容。
關鍵在於:從第二站開始,每一站都是一台別人的機器。 檔案要能被傳遞、被處理,就必然在那台機器上產生一份暫存的副本。這是工程上的必然,不是誰心懷不軌。
所以問題從來不是「模型會不會記住」,而是:這份副本留在哪幾台機器上、留多久、誰有權限打開。
這裡要分開兩個常被混為一談的階段。
訓練,是把大量資料餵給模型、調整它內部參數的過程。資料要「進到模型裡」,只可能發生在這一階段。
推論,就是你平常使用它的時候。模型讀進你這次送的內容、產生回答,然後結束。你的檔案不會因此改變模型內部的任何一個參數。
換個說法:模型不是資料庫,它沒有「你的合約」這一筆紀錄可以查。它比較像一位過目即忘的顧問——看完文件給你建議,然後就忘了。
但這位顧問任職的公司,櫃檯會把進出的文件影印存檔。風險不在顧問的記憶,在櫃檯的檔案櫃。
技術上,留存通常來自這幾個地方:
日誌。 為了排查錯誤、監控服務品質,平台通常會記錄請求和回應。這是留存最常見的來源。
人工審閱。 部分服務條款允許在特定情況下由人員查看內容,用於處理濫用、改善模型或客服調查。
快取與備份。 為了加速與容災,系統會在多個位置保留暫存與備份,這些副本的實際清除時間往往比「刪除」這個動作更晚。
中間服務的紀錄。 這一站的留存政策由服務提供者決定,不一定跟你使用的模型平台相同。
換句話說,「我按下刪除了」不等於「檔案不存在了」。 這是判斷風險時必須先接受的前提。
你的內容會不會「進到模型裡」,取決於平台有沒有把它用於訓練。而這一點,通常會依服務類型分開規定:
所以「大模型會不會洩漏」這個問題,沒辦法用一句話回答。 同一個模型,透過網頁版使用、透過企業API使用、放在自己機房使用,是三種完全不同的風險。
判斷的時候,你只要問三件事:
這三題如果條款裡找不到答案,那本身就是一個答案。
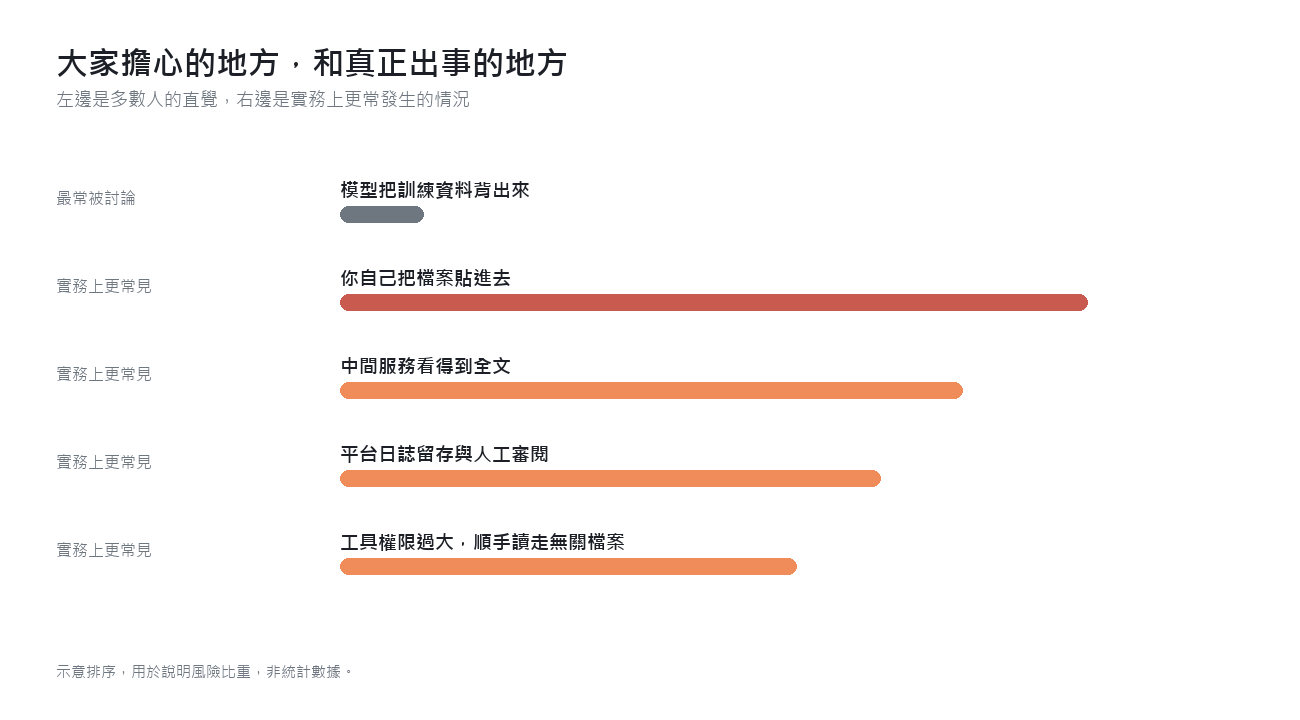
把常見的擔心排一排,會發現順序和直覺不太一樣。
最常被討論的,是「模型把訓練資料背出來」。這確實存在,但它主要牽涉的是公開網路上的資料,而且需要特定條件才可能重現。你自己昨天上傳的報價單,並不在這個範圍裡。
實務上更常見的,是另外四件事:
你自己把檔案貼進去。 最常見的一種。不是被攻擊,是自己送出去的。
中間服務看得到全文。 用了不明來源的中轉或外掛,等於多了一手。
平台日誌留存與人工審閱。 未必有人真的去看,但權限存在,風險就存在。
工具權限過大。 讓AI工具讀取整個資料夾,它可能把無關的檔案一起送出去。
這四件事有個共通點:它們都不是模型造成的,是使用方式造成的。 也就是說,它們全部可以靠流程解決。
先講一句結論:這件事八成靠流程,兩成靠工具。
把「能不能用AI」換成「這份文件該走哪條路」,判斷就會簡單很多。
| 文件類型 | 建議通道 |
|---|---|
| 公開資訊、行銷素材 | 任何通道都可以 |
| 內部一般資料 | 有合約的企業版或API |
| 合約、財報、客戶名單、原始碼 | 先去識別化,再進企業通道 |
| 個資、未公開重大資訊 | 不進第三方;改用自架模型 |
第一,不要用個人帳號處理公事。 這是實務上最大的一個洞。員工用自己的免費帳號處理公司文件,等於把資料送進一個公司看不到、也管不到的通道。這種情況通常不是故意違規,而是沒有人告訴他不行。
第二,去識別化之後再送。 把姓名、身分證號、客戶代號、精確金額換成代號。多數分析任務其實不需要真實的識別資訊,要的是「哪一類客戶、哪一種金額區間」。
第三,選對通道。 網頁版、API、自架,三者風險不同。別用網頁版的經驗去推論API的風險,也別反過來。像Crazyrouter這類聚合入口,好處是一個端點就能切換模型,但它同樣看得到完整內容,選的時候一樣要確認留存條款。
第四,把設定裡能關的先關掉。 多數服務在設定中提供「不要用我的內容改善服務」這類選項,以及對話紀錄的保留開關。花五分鐘找一下,比事後補救便宜。
第五,只給工具最小權限。 不要讓它讀整個資料夾或整個信箱,只給它處理這份任務真正需要的那幾個檔案。
第六,自己留一份紀錄。 哪些文件、什麼時候、送進了哪個服務。真的出事時,這份紀錄決定了你能多快判斷影響範圍。
三題裡只要有一題答不出來,就先不要送。
個人再小心,也補不起制度上的空白。如果要在公司裡放行AI工具,有三件事比「買哪個方案」更重要。
第一,給一份白名單。 明確寫出哪些工具可以用、用哪個帳號、哪些資料可以送。禁止清單沒有用,白名單才有用——因為員工真正需要知道的是「那我可以怎麼做」,而不是「不能做什麼」。
第二,把權限和紀錄管起來。 誰能存取哪些資料、AI工具能讀到多大的範圍、對話要不要留存,這三件事必須有人負責。企業版通常提供集中管理與稽核功能,這正是它比個人版貴的理由。
帳號與端點也要一起寫進規範:哪些模型走哪個端點(例如Crazyrouter)、由誰申請、離職時怎麼停用。這一段沒寫清楚,白名單就只是紙上作業。
第三,先想好出事怎麼辦。 誰負責判斷、多久內要通報、要不要通知客戶、能不能要求平台刪除。這些問題在平靜的時候決定,比在事發當天決定容易一百倍。
模型不會記得你的機密文件。會記得的是別人的伺服器。
所以真正需要回答的,不是「大模型安不安全」這種問題。
而是三個更具體的:這份文件有多機密、我打算走哪條通道、那條通道上的副本由誰保管、留多久。
想清楚這三件事,你就會發現有些檔案根本不需要送出去,而有些檔案只要把關鍵欄位換掉,就能安全地取得一樣有價值的回答。
能用的關鍵,不在於找到一個「絕對安全」的模型,而在於知道每一份文件該走哪一條路。

 17802032796

 iThome鐵人賽
 看影片追技術