
上個月我接了一個批量寫文案的工作。手上有三個模型:兩個Claude、一個GPT。
每條文案都要求不超過80字。我隨手挑一個來跑,十條裡超了三條。
從那天起,每次換模型,我都得重新賭一次。
賭的不是它聰不聰明。賭的是它在我的工作裡,會不會翻車。
我的工作分三類:批量寫短文案、從工單裡抽欄位、偶爾算點數學題。
這三類工作對模型的要求完全不一樣。寫文案怕超字數,抽欄位怕格式歪掉,算題怕思路走岔。
同一件事,在三種工作裡就是三種失敗方式。所以「換個模型」從來不是換個名字那麼簡單,是換一套行為習慣。
但問題也從這裡開始:換得越多,需要重新確認的東西就越多。
每次升級,官方說法都差不多:更強、更便宜、上下文更長。
這些話對所有人都成立,所以對特定的人沒什麼用。你真正想知道的是:我這種工作,它接得住嗎。
Sonnet 5.5出來的時候,模型頁寫得很克制:兩個模型獨立存在,遷移前請自行驗證。
翻譯過來就是——沒人替你測。
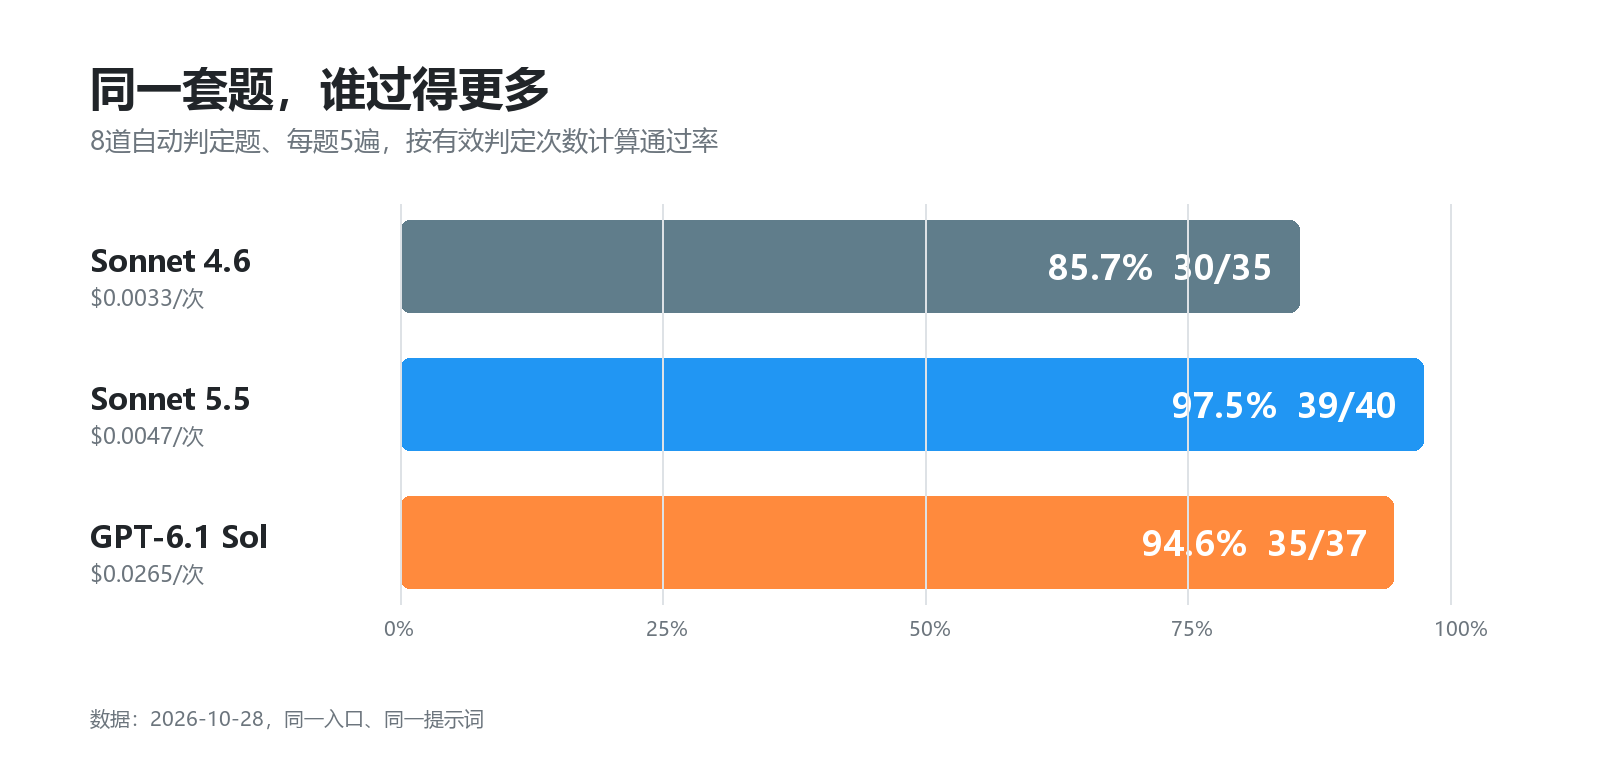
圖註:8道自動判定題、每題5遍,按有效判定次數計算通過率;2026-10-28實測。
多數人的做法是拿幾條真實請求跑一下。這沒錯,但幾條試不出穩定性。
如果只是偶爾用一次,試幾條確實夠了。一旦要放進批量流程,問題就變了——一條錯一次,可能是運氣;同一道題五遍全錯,那就是行為。
我第一次只跑了兩遍。4.6在字數題上錯了一遍,我當時以為它只是偶爾手滑。
樣本太少,「偶發」和「習慣」根本分不開。
十二道題,每題五遍,三個模型,總共一百八十次呼叫。
八道能自動判定,另外四道程式與改寫題只能人工看,沒併進下面的通過率。
| 模型 | 自動題通過 | 中位耗時 | 單次成本 |
|---|---|---|---|
| Sonnet 4.6 | 30/35 | 3.29秒 | $0.0033 |
| Sonnet 5.5 | 39/40 | 2.81秒 | $0.0047 |
| GPT-6.1 Sol | 35/37 | 6.19秒 | $0.0265 |
五遍不是為了把數字做大,是為了把錯誤分類:有的是每遍都錯,有的只錯一次。
這兩類錯,處理方式完全不同。
先看那道最不起眼的題:用不超過60個字解釋MoE,不准出現「專家」。
MoE你可以理解成「一群小模型分工幹活,每次只叫醒其中幾個」。題目要的不是定義多準,是能不能收得住。
三個模型給出的長度是65、58、48。
Sonnet 4.6:
一種模型架構,將網路劃分為多個子模組,每次輸入時由門控機制動態選擇少數子模組參與計算,從而在保持低計算量的同時擴大模型總參數規模。
Sonnet 5.5:
一種神經網路架構:由多個子網路和一個路由器組成,每次輸入只激活其中少數子網路處理,在擴大模型容量的同時降低計算成本。
GPT-6.1 Sol:
MoE是一種模型架構,透過路由機制為每個輸入選擇少量子網路參與計算,以較低計算成本擴大模型容量。
讀到第三段你就能看出來,4.6比上限多出五個字,超出的部分多半花在「門控機制」「動態選擇」這些限定語上。
這兩個詞不是廢話,它們讓定義更準。可題目寫的是硬約束,不是建議。
我又發了四遍。加上第一次,五遍的字數是65、62、68、66、70。
五遍一次沒進60。換句話說,它看起來就沒把字數當成條件,而是按「把話說完整」在寫。
這個習慣放在寫作裡是優點。放進批量流程就是故障——每一條都要人工回爐,回爐的成本比呼叫費貴得多。
上一節是每遍都錯,這種好判斷。還有一種是只錯一遍,那就難說了。
機率題:從1到5取三個不同數字,和為偶數的機率,答案是3/5。
5.5五遍裡四遍對。錯的那遍,推理是這樣的(節錄):
三個數全為偶數:只有2、4兩個偶數,取不出三個,0種。一個奇數加兩個偶數:C(3,1)×C(2,2)=3種。所以機率為3/10。
它把「兩奇一偶」記成了「一奇兩偶」,組合數正好錯一半。
這裡要分清兩件事:偶發錯誤可以靠重試攤掉,穩定錯誤只能換模型或者加一層校驗。前者是成本,後者是架構。
到目前為止,5.5只在這一題上錯過一次,其餘三十九次全對。
看到這裡,答案好像已經清楚了:換5.5。
但還有第三個選項,標價和5.5一模一樣。Sol每百萬輸入$2、輸出$10,光看價目表,你會以為它們是同一價位的東西。
跑完才發現不是。同樣十二道題,Sol一次呼叫$0.0265,5.5只要$0.0047,差5.6倍。
錢花在哪?同樣一道題,它收的錢是5.5的五倍多。
貴本身不是問題,直到你看到它在橢圓那題上五遍錯了兩遍,只回了一個答案:
(\frac{4}{5})
正確答案是16/5。三角那題它五遍全對,橢圓這題連著錯兩遍。
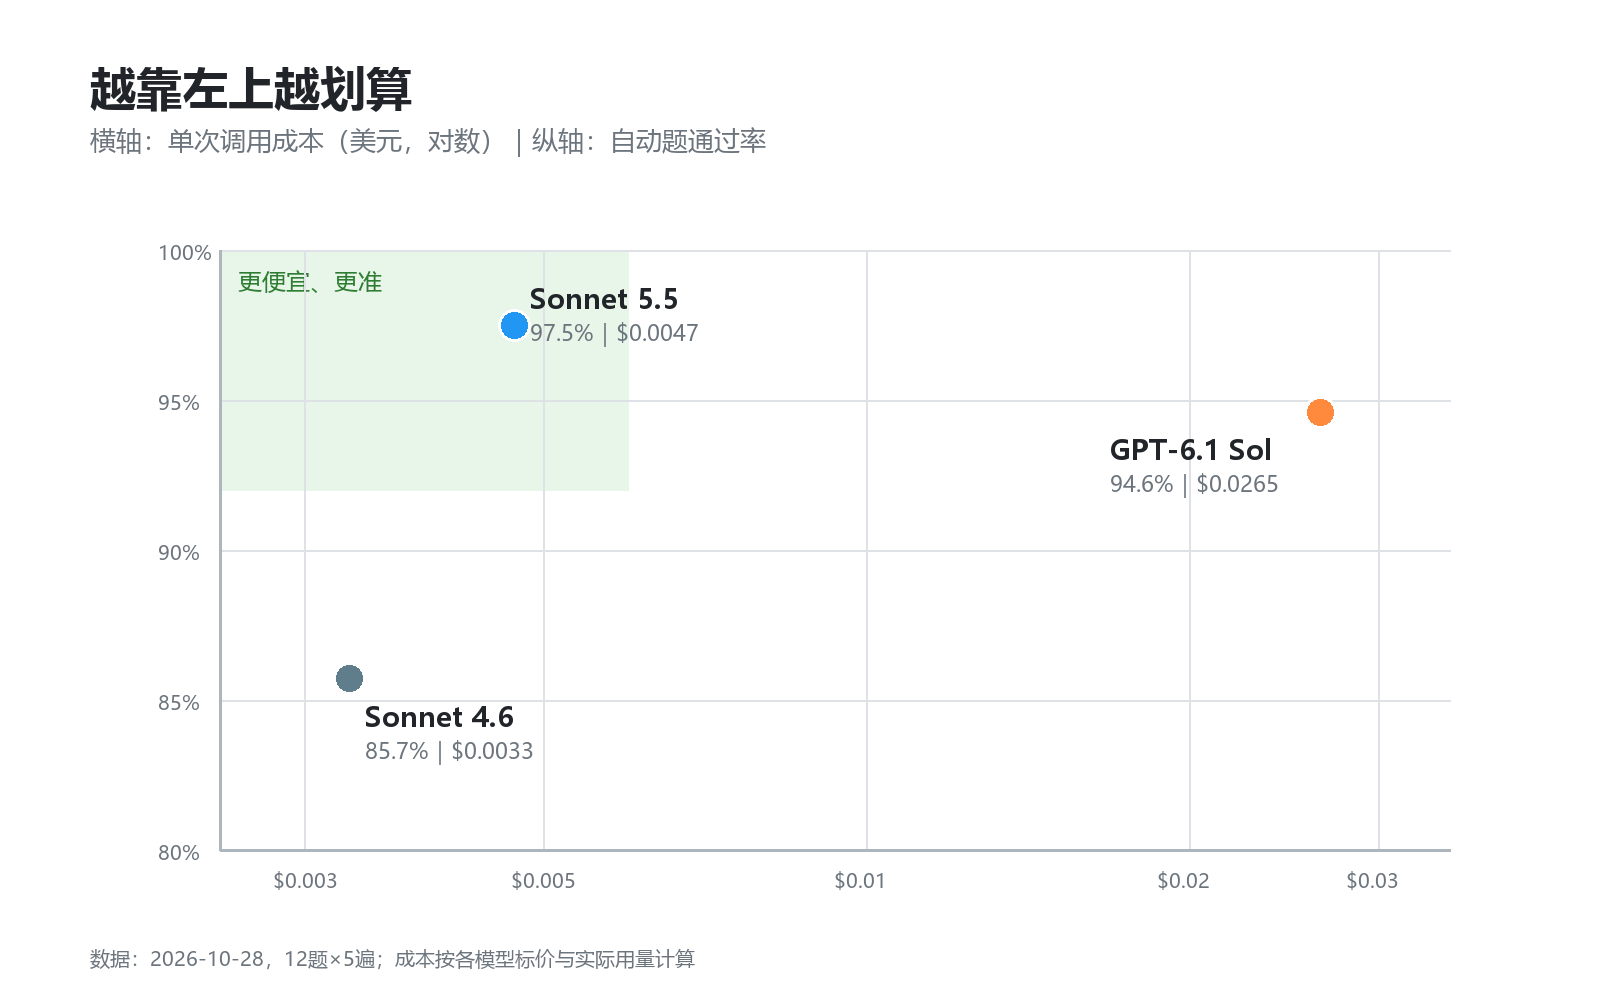
圖註:橫軸為單次呼叫成本(對數),縱軸為自動題通過率;綠區是「更便宜、更準」的方向。
價目表只是起點。帳單要看它跑一趟花多少,而花得多,也可能是花歪了。
全部模型的單價可查 價格總覽頁。
十二道題都是人造的小題。真實的工作長這樣:二十條客服工單,抽出單號、客戶、產品、金額、日期。
總共一百個格子,三家全對。
準確率拉不開差距的時候,差別就只剩時間:5.5用7.5秒,Sol用29.3秒,4.6用37.9秒。
單次差半分鐘不算什麼。但一天跑一萬條,就是八十多個小時的差距。
到這裡,三件事已經清楚了:4.6輸在長度約束,5.5只錯一次推理,Sol最貴還錯在簡單題上。
那怎麼選?分場景看。
如果你的工作裡,字數和格式是硬指標——批量文案、結構化輸出、介面回傳——換5.5。三個模型裡,只有它沒在長度約束上失過手,中位耗時也最短。
如果你的工作是「寫一篇東西,人來改」,留在4.6也合理。它寫得完整,多出來的資訊量在人工潤色時反而是優點。
如果你想找更便宜的同價位替代,Sol不合適。標價和5.5一樣,實付貴5.6倍,橢圓那題五遍錯兩遍。
| 你的場景 | 結論 | 選誰 |
|---|---|---|
| 批量結構化輸出,要卡字數、卡格式 | 換 | Sonnet 5.5 |
| 一次性問答,人工還要過一遍 | 先不換 | 留在Sonnet 4.6 |
| 找同價位但更省的替代 | 不考慮 | GPT-6.1 Sol |
| 超長文件要一次讀進去 | 換 | Sonnet 5.5(1M上下文) |
表格最後一行要補一句:這條是按規格寫的,我沒測。
十二道題每題五遍,另加一個二十條工單的抽取任務,只測單輪文字。
長上下文、多輪對話、工具呼叫、圖片理解,這次都沒測。所以上面所有結論,只適用於「單輪、短輸入、有明確對錯」的工作。
一百八十次呼叫裡有十三次網路中斷,未計入通過率。四道程式與改寫題屬人工判斷,沒納入自動統計。價格按模型頁當日抄錄,實際帳單以平台計費為準。
如果你的工作不在這個範圍內,比如要一次讀進幾十萬字,或者要接工具鏈跑自動化,那次測試只提供了一個起點,不能替你下結論。

 17802032796

 iThome鐵人賽
 看影片追技術