
凌晨三點,你被一連串的告警聲吵醒。
手機螢幕上顯示著二十多條來自不同監控工具的通知:「資料庫連接異常」、「API 響應時間過長」、「磁碟使用率超標」、「用戶訂單處理失敗」。你匆忙打開筆記本,在各個監控平台間跳轉,試圖理解到底發生了什麼。十分鐘後,你發現這些看似不相關的告警實際上都源自於一個根本問題:某個微服務的記憶體洩漏導致了連鎖反應。
這個場景在許多企業中每天都在上演。傳統的監控系統往往是各種工具的拼湊,缺乏統一視角,無法快速定位問題根因。 而現代企業級監控系統的核心價值,正是要從這種被動的「救火」模式,轉變為主動的智能運維。
今天我們將深入探討如何設計一套完整的企業級監控系統,從指標收集到智能告警,從異常檢測到根因分析,建構一個能夠支撐企業數位化轉型的可觀測性平台。
想像你正在為一家快速成長的金融科技公司設計監控系統。這家公司運營著包含移動支付、投資理財在內的多個業務線,系統架構包含超過 200 個微服務,每日處理千萬級交易,服務遍布全球多個地區。業務團隊需要 99.99% 的服務可用性,任何系統異常都可能造成巨大的經濟損失和品牌傷害。
在這樣的企業環境中,監控系統不僅要監測技術指標,更要深度結合業務指標,提供從基礎設施到用戶體驗的全棧可觀測性。系統需要支援多雲環境、容器化部署、以及快速迭代的開發流程。
技術挑戰一:海量時序數據的存儲與查詢
企業級監控系統面臨的首要挑戰是如何高效處理海量的時序數據。以金融科技公司為例,200 個微服務每秒可能產生數百萬個數據點,一年下來數據量可達 PB 級別。傳統的關聯式資料庫無法應對如此規模的時序數據,而專用的時序資料庫在高基數場景下也面臨性能瓶頸。這影響了查詢效能和存儲成本,是監控系統設計的首要考量。
技術挑戰二:智能異常檢測與告警降噪
在複雜的分散式系統中,單一故障往往會觸發大量相關告警,形成「告警風暴」。根據業界研究,傳統靜態閾值告警可能產生高達 95% 的誤報率,導致嚴重的告警疲勞。如何從數以千計的指標中識別真正的異常,如何將相關告警聚合為有意義的事件,如何避免誤報導致的告警疲勞,這些都是監控系統設計的核心挑戰。
技術挑戰三:多雲環境下的統一可觀測性
現代企業通常採用多雲策略,服務可能分佈在 AWS、Azure、GCP 等不同雲平台,還包含本地部署的遺留系統。如何在異構環境中實現統一的監控標準,如何確保數據的一致性和完整性,如何處理不同雲平台 API 的差異,這些都需要在架構設計階段詳細考慮。缺乏統一標準會導致數據孤島,阻礙全局性的問題分析。
| 維度 | 傳統集中式監控 | 微服務分散式監控 | 混合雲原生監控 |
|---|---|---|---|
| 核心特點 | 單體監控平台 | 服務自主監控 | 統一可觀測性平台 |
| 優勢 | 管理簡單、成本較低 | 服務獨立、技術靈活 | 標準化、智能化 |
| 劣勢 | 擴展性有限、單點故障風險 | 數據孤島、標準不一 | 實施複雜、技術門檻高 |
| 適用場景 | 中小型單體應用 | 創業期微服務 | 大型企業分散式系統 |
| 複雜度 | 低 | 中 | 高 |
| 成本 | 中等 | 中高 | 高 |
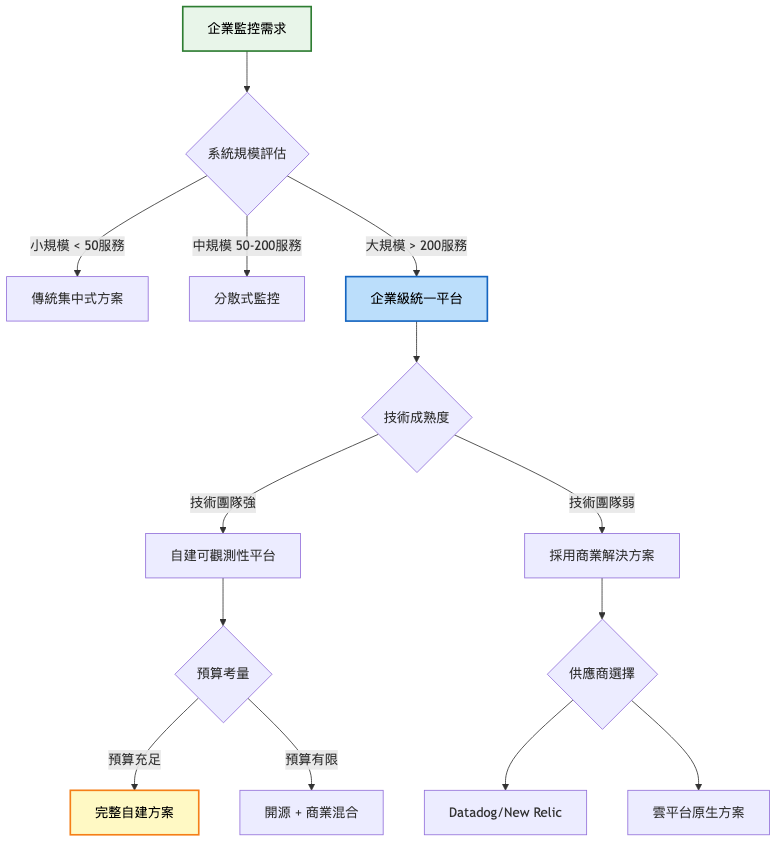
基於我們的金融科技企業場景,推薦選擇企業級統一平台方案。考量到金融行業對數據安全和可控性的要求,建議採用自建可觀測性平台,結合開源技術和部分商業組件的混合架構。
架構重點:
系統架構圖:
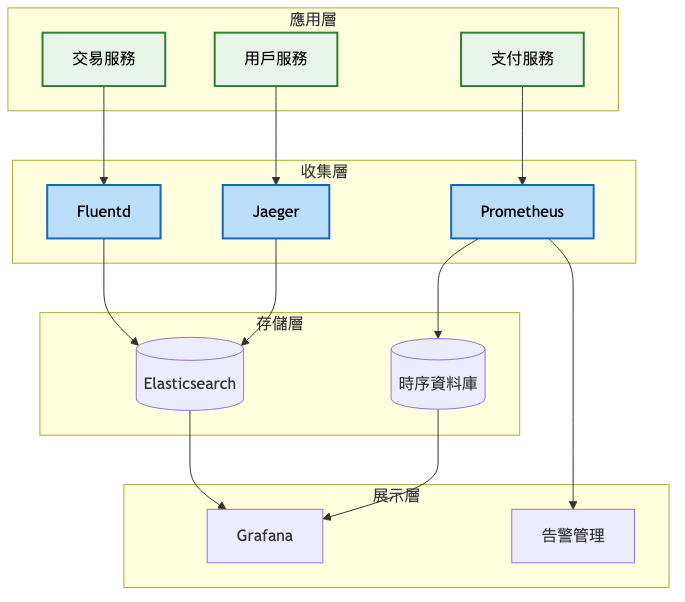
關鍵技術選型:
預期效能指標:
架構重點:
系統架構圖:
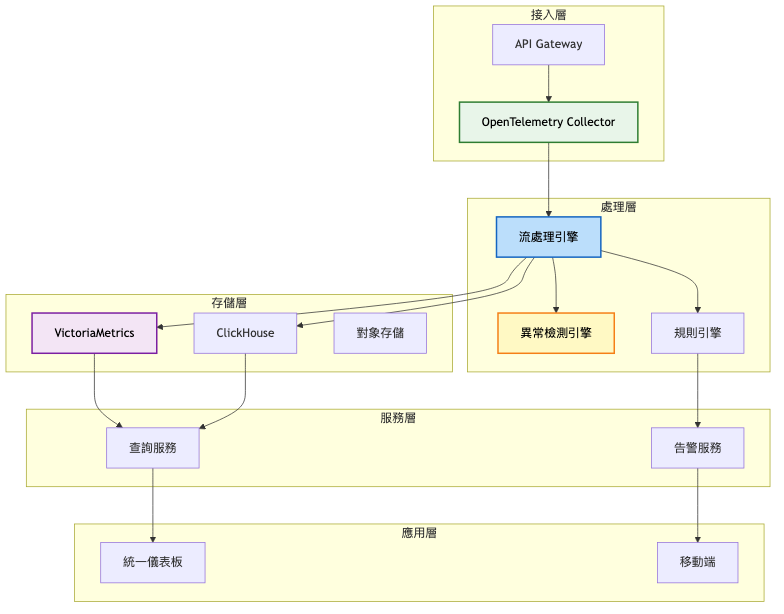
關鍵架構變更:
統一數據收集標準
智能分析能力
高性能存儲方案
預期效能提升對比表:
| 指標 | 第一階段 | 第二階段 | 改善幅度 |
|---|---|---|---|
| 數據處理能力 | 10萬 TPS | 100萬 TPS | 10倍 |
| 查詢響應時間 | 500ms | 100ms | 5倍 |
| 存儲成本 | 基準 | -40% | 節省40% |
| 告警準確率 | 60% | 95% | 提升58% |
| 誤報率 | 30% | 2% | 降低93% |
架構重點:
總覽架構圖:
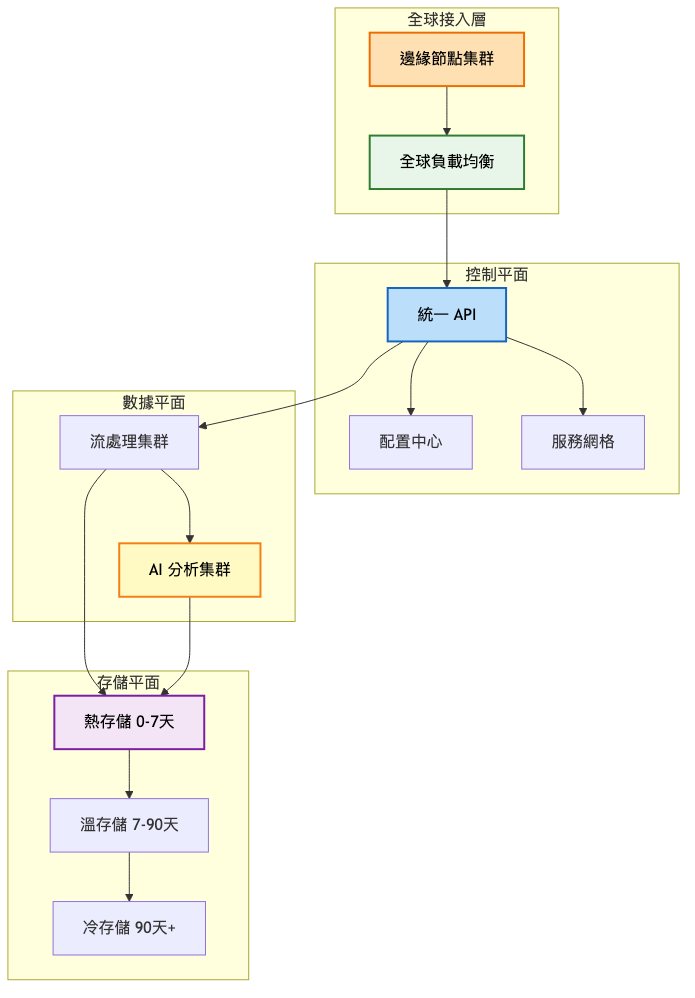
關鍵能力突破:
AI 驅動智能運維
全球化部署架構
開放平台生態
| 架構特性 | 第一階段 | 第二階段 | 第三階段 |
|---|---|---|---|
| 架構模式 | 傳統監控工具組合 | 統一可觀測性平台 | AI 驅動智能運維 |
| 數據處理 | 基於規則的靜態分析 | 機器學習異常檢測 | 預測性智能分析 |
| 存儲策略 | 單一時序資料庫 | 分層存儲架構 | 全球分散式存儲 |
| 部署方式 | 單機房部署 | 多地域部署 | 全球 + 邊緣部署 |
| 處理能力 | < 10萬 TPS | 10-100萬 TPS | 100萬+ TPS |
| 觸發條件 | 採取行動 | 預期效果 |
|---|---|---|
| 數據處理能力達到 80% | 升級到 VictoriaMetrics 集群 | 處理能力提升 10 倍 |
| 告警誤報率 > 20% | 引入機器學習異常檢測 | 誤報率降至 2% 以下 |
| 跨地域延遲 > 500ms | 部署區域化監控集群 | 延遲降至 100ms 以內 |
| 運維團隊增長 > 50人 | 建立統一可觀測性平台 | 提升協作效率 3 倍 |
| 技術選項 | 優勢 | 劣勢 | 適用場景 |
|---|---|---|---|
| Prometheus | 生態完善、部署簡單、社區活躍 | 單機存儲限制、高基數性能差 | 中小規模 Kubernetes 環境 |
| VictoriaMetrics | 高壓縮率、Prometheus 兼容、成本低 | 相對較新、企業支援有限 | 大規模時序數據場景 |
| TimescaleDB | SQL 查詢、關聯分析強、數據一致性好 | PostgreSQL 依賴、運維複雜 | 需要複雜分析的場景 |
| InfluxDB | 專業時序設計、查詢靈活、功能完整 | 高基數性能問題、商業授權 | 傳統時序監控場景 |
推薦選擇:VictoriaMetrics
根據 2024-2025 年的最新效能測試,VictoriaMetrics 在高基數時序數據處理方面表現卓越,相比 Prometheus 具有 10 倍以上的壓縮率和更好的查詢性能。TimescaleDB 雖然在複雜 SQL 查詢方面有優勢,但在高基數場景下比 InfluxDB 快 3.5 倍,而 InfluxDB 在低基數場景表現良好但高基數時性能急劇下降。VictoriaMetrics 與 Prometheus 的完全兼容性也降低了遷移成本。
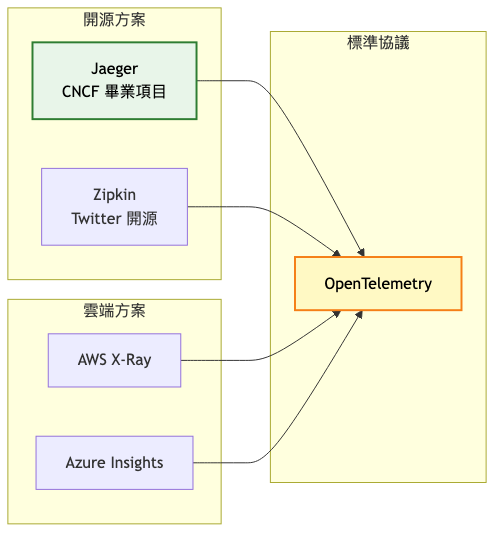
推薦選擇:Jaeger + OpenTelemetry
Jaeger 作為 CNCF 畢業項目,具備完整的雲原生架構和優秀的可擴展性。相比 Zipkin 的單體架構,Jaeger 採用微服務設計更適合大規模部署。配合 OpenTelemetry 標準,能夠實現多語言、多框架的統一追蹤接入,避免供應商鎖定。
| 平台 | 數據源支持 | 可視化能力 | 企業特性 | 成本模型 |
|---|---|---|---|---|
| Grafana | 70+ 種數據源 | 高度定制化、插件豐富 | 開源+企業版 | 開源免費 |
| Kibana | Elasticsearch 專用 | 強大日誌分析能力 | 商業授權 | 按節點計費 |
| Datadog | 700+ 集成 | 內置智能功能 | 一體化 SaaS | 按主機計費 |
推薦選擇:Grafana
Grafana 憑借其開源生態和豐富的插件支援,在企業級場景中占據主導地位。支援 70 多種數據源,可以統一可視化來自不同系統的監控數據。開源版本功能完整,企業版提供額外的權限管理和技術支援。
現代企業級監控系統的技術演進遵循「標準化 → 智能化 → 自動化」的路徑:
階段一:標準化基礎建設
階段二:智能化分析提升
階段三:自動化運維實現
OpenTelemetry 作為統一標準正成為業界共識,其提供的廠商中立性和完整的可觀測性覆蓋,大幅降低了技術選型的風險和遷移成本。建議企業在監控系統建設初期就採用 OpenTelemetry 標準,為未來的技術升級預留空間。
過早優化的複雜架構
忽視監控系統自身的可靠性
數據孤島和標準不統一
告警疲勞和精準度不足
案例一:Google SRE 監控體系
參考文獻:Google SRE Book - Monitoring Distributed Systems
Google SRE 提出了現代監控系統的四個黃金信號:延遲(Latency)、流量(Traffic)、錯誤率(Errors)、飽和度(Saturation)。這些指標直接關聯用戶體驗,是監控系統設計的基礎框架。
早期(2003-2010)
成熟期(2010-2020)
近期狀態(2020-至今)
案例二:Netflix 的 Chaos Engineering 實踐
初期(2008-2012)
成長期(2012-2018)
近期狀態(2018-至今)
在企業級監控系統中,觀察者模式被廣泛用於實現事件驅動的架構。當系統狀態發生變化時,監控平台需要及時通知相關的處理組件,如告警管理器、自動化修復模組、業務儀表板等。
使用場景:
實施方式:
注意事項:
不同類型的監控數據需要採用不同的異常檢測算法,策略模式允許系統在運行時動態選擇最適合的檢測策略。
使用場景:
實施方式:
企業級監控系統的部署不能影響現有業務,需要採用漸進式的部署策略:
定期分析監控系統自身的性能指標,識別瓶頸並進行針對性優化:
監控系統的災難恢復計劃應該包括:
建立完整的自動化運維體系:
建立監控系統效果評估機制:
建立運維知識庫:
現代企業級監控系統已經從傳統的被動故障檢測演進為主動的智能運維平台。成功的監控系統建設需要在技術先進性、業務價值、實施成本之間找到最佳平衡點。
五大核心要素:
從企業級監控系統的設計實踐中,我們提煉出以下核心設計原則:
針對今日探討的企業級監控系統設計,建議可從以下關鍵字或概念深化研究與實踐,以擴展技術視野與解決方案能力:
OpenTelemetry 生態系統:透過進一步學習此統一可觀測性標準的實施細節與最佳實踐,能加強對現代監控架構的理解與應用。
AIOps 智能運維:這部分涉及的機器學習演算法、異常檢測模型、預測性分析等技術,適合深入掌握以提升監控系統的智能化水平。
eBPF 技術:探索這一新興的 Linux 核心可觀測性技術,幫助實現更深層的系統監控和性能分析。
Site Reliability Engineering:關注 Google SRE 方法論的最新發展,保持可靠性工程與時俱進,尋找創新的可靠性保障方案。
可根據自身興趣,針對上述關鍵字搜尋最新技術文章、專業書籍或參加線上課程,逐步累積專業知識和實踐經驗。
明天我們將探討「容器編排平台」的設計。我們將深入了解如何構建企業級的 Kubernetes 平台,處理資源調度、服務發現、故障自動恢復等挑戰。從今天的監控系統到明天的編排平台,我們將看到現代雲原生基礎設施各個組件之間的協調配合,以及如何通過系統性的設計思維構建穩定可靠的技術架構。


 iThome鐵人賽
 看影片追技術