
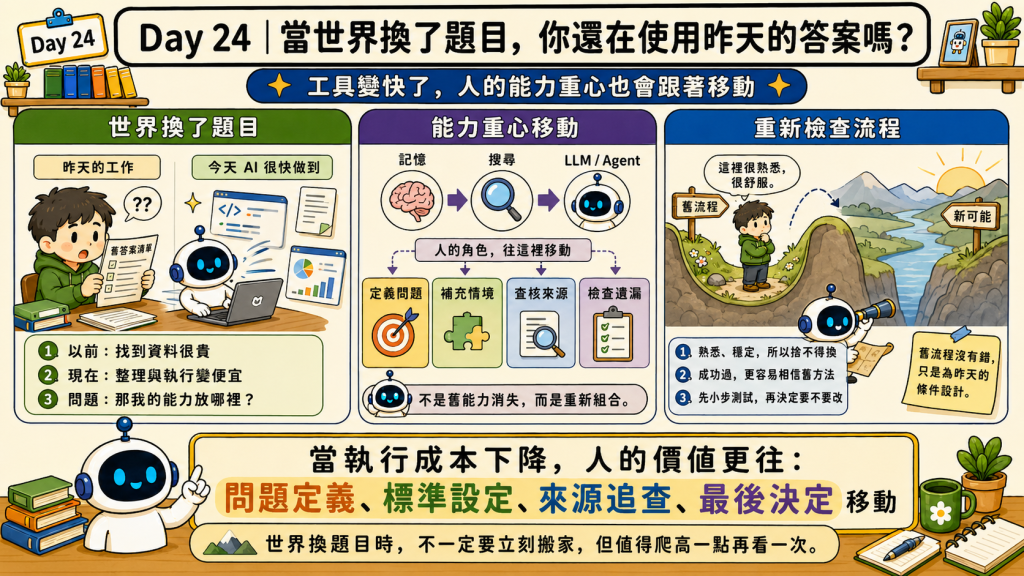
有一天,你發現自己花了多年練熟的工作,AI 幾分鐘就完成了。
第一個問題可能是:「它做得對嗎?」
第二個問題更難回答:「如果它真的做得不錯,那我以前練的那些東西怎麼辦?」
2026 年,曾任 Facebook 早期工程師與 Dropbox 技術長的 Aditya Agarwal,寫了一篇名為 When Your Life's Work Becomes Free and Abundant 的文章。中文可以理解成:「當你畢生磨練的工作,突然變得便宜又充足。」
他寫程式超過二十年。程式設計不只是工作清單上的一項技能,而是支撐整段職涯的重要專業。可是在一個週末密集使用 Claude 寫程式後,他感覺自己非常擅長的能力,正在被重新定價。
這不是一個「資深工程師都能順利適應 AI」的研究結論,只是一位工程師的個人經驗。它有意思的地方,在於他沒有忙著證明手寫程式才算真正的程式設計,而是繼續使用新工具,開始嘗試過去因為成本太高而不會做的事情。
他也沒有因此失去二十年的專業。那些經驗仍然讓他知道程式應該怎麼運作、哪裡可能出錯,以及什麼結果值得相信。改變的是:在新的環境裡,親手寫出每一行程式,未必還是最需要守住的部分。
所以這個故事最值得注意的,不是「AI 將取代工程師」。而是當一項工作的執行成本突然下降,我們原本安排時間、分配注意力和檢查成果的方式,也可能需要跟著調整。
昨天得到高分的答案不一定錯。只是世界已經換了題目,我們得先看清楚題目到底改了哪裡。
這種變化不是第一次發生。
搜尋引擎普及以前,找到資料本身就很昂貴。我們得記住更多內容,知道答案可能藏在哪本書、哪個資料庫,或哪一位前輩的腦袋裡。有時候你不是不會解題,只是還沒走到放著那本書的圖書館。
2011 年 發表了一項Google 效應(Google effect)的研究。實驗發現,當人們預期之後還能從電腦取得資訊時,可能比較不會記住資訊本身,卻更容易記得可以到哪裡找到它。研究者因此將網路比喻成一種外部的共享記憶。
這不等於「Google 讓人變笨」,也不表示記憶從此不重要。後續研究對部分效果能否穩定重現仍有不同結果。這項研究比較適合帶給我們一個問題:當取得資訊的成本下降,人會不會開始重新分配自己的注意力?
Google 出現後,我們依然需要基本知識,否則連搜尋結果錯在哪裡都看不出來。但能力的重心開始移動。除了記住答案,我們還得學會怎麼描述問題、挑選關鍵字、判斷來源、比較互相衝突的說法,再把散落的資料組成自己的理解。
LLM 又把成本往下降了一層。它不只幫忙找線索,還可以整理、翻譯、比較、畫圖、寫程式,甚至直接生出一份讀起來很完整的答案。以前我們擔心找不到資料,現在更常遇到的問題可能是:答案已經放在眼前,但我知不知道它少了什麼?
人的能力不是從「記憶」換成「搜尋」,再換成一句模糊的「判斷力」,好像舊能力可以整批解除安裝。比較接近真實的情況是,原有能力仍然存在,只是重新組合。當查找、整理和初步執行越來越便宜,定義問題、補充情境、設定標準、追查來源、檢查遺漏,以及承擔最後決定,便顯得更重要。
這種能力的重新分配還沒有結束。進入 LLM 時代後,工具更新得更快,能參與的工作也從回答問題、產生內容,逐漸往工作流程的其他環節延伸。人的能力要放在哪裡,也可能更頻繁地被重新檢查。
例如,Google Labs 在 2026 年 8 月提出 Situationally Aware Agents 的概念,討論 Agent 能不能不只等待指令,還能觀察工作情境,判斷何時通知、何時提問、何時先準備草稿,甚至何時應該保持安靜。
這仍然是研究中的方向。相關的立場論文討論的是未來 Agent 的設計與評估問題,不代表今天的 Agent 已經能可靠地理解所有情境,更不表示我們可以放心把整套工作交給它。
不過,這個方向提供了一個值得留意的訊號:未來被降低成本的,可能不只是寫出答案,還包括背景監控、初步判斷與部分工作安排。當工具能參與的範圍繼續改變,我們不必每天追著新產品跑,卻需要更常回頭確認:哪些能力仍是理解問題的基礎?哪些工作已經可以重新分配?哪些判斷與責任,不能因為 AI 做得很快就一起交出去?
能力的重心並不是一個只存在履歷表上的抽象變化。它最後會落進每天的工作裡:哪些事情要親手完成、哪些可以交給工具、時間應該花在哪裡,以及最後要檢查什麼。當人和工具的分工改變,工作流程自然也需要被重新檢視。
但流程不像軟體通知,按下更新就會自動換成新版。我們真正面對的,是一套目前仍然能用、自己也已經做得很熟的方法。既然舊方法沒有壞,改變還要重新學習、重新檢查,甚至可能製造新的錯誤,我們為什麼要動它?
所以接下來要處理的,不是 AI 又多會一項功能,而是一個更貼近自己的問題:一套曾經合理、現在也還能運作的流程,什麼時候值得重新檢查?
昨天 Day 23,我們練習修改別人的規則,讓大神的方法更適合自己的情境。那已經不容易了,但今天還要再往前一步:這次要檢查的不是別人的方法,而是我們自己的流程。
別人的規則不好用,我們比較容易挑出問題,畢竟它本來就不是為我設計的。自己的流程卻不一樣。它可能已經陪我們解決過很多問題,裡面的每一個步驟,看起來都有留下來的理由。
它可能已經使用很多年,我們知道哪裡容易出錯,也知道出了問題該去哪裡找。檔案位置、同事分工、檢查方式,甚至每週會議的時間,都可能圍繞它建立。
因此,繼續使用既有流程不一定是抗拒改變,也不表示一個人不願學習。熟悉的方法降低了學習成本,累積的檢查經驗也提供安全感。新工具看起來很快,卻還不知道能不能穩定重複;重新設計流程本身,同樣需要付出時間與承擔風險。
如果這套方法過去還曾經帶來好結果,我們就更有理由相信它。
管理研究中有一個很貼近這種情況的說法:成功悖論。Audia、Locke 與 Smith 結合產業資料與實驗發現,在環境劇烈改變後,過去越成功,越可能持續沿用原本策略,而這種持續有時會伴隨後續表現下降。原始論文也指出,過去的表現可能提高人們對原策略的滿意與信心,並減少向批評者尋找資訊。
這項研究不是在測試 AI 工具,也不能證明每個人都會因成功而固守舊流程。它提供的比較像一個警告:當環境已經改變,過去的好結果可能讓舊策略得到更多信任。
即使沒有耀眼的成功,光是熟悉、穩定和可控制,也足以讓一套流程繼續存在。這些理由都很真實。問題不在於舊方法活得太久,而在於我們是否還記得,它當初是在什麼條件下形成的。
如果借用最佳化問題的說法,我們可能正站在一個 Local Minimum,也就是「局部最佳解」。先說清楚,這是幫助理解的工程類比,不是前面管理研究使用的正式名稱。
想像我們沿著地形往低處走,最後來到一個舒服的小山谷。這裡確實比附近的位置都好;但更遠的地方也許還有另一個更深的山谷。要找到它,得先願意離開眼前這個已經很不錯的位置。
既有流程就像這個小山谷。它不是錯誤,也不是失敗,只是我們太熟悉這裡的道路、便利商店和垃圾車時間。聽見外面出現新路時,第一個反應很可能是:「不用啦,我這裡住得很好。」
更何況搬家真的很麻煩。即使新地方的照片拍得很漂亮,不代表水電已經接好,也不代表巷口的鹹酥雞符合你的口味。AI 時代不要求我們每天搬家,但偶爾值得爬到高一點的地方,看一眼這是不是唯一的選擇。
那麼,一套既有流程停在 Local Minimum 時,實際上會長什麼樣子?
我曾是一位地球科學研究者。過去分析測站資料時,我會先到不同網站下載檔案,確認欄位與單位,再把資料整理成表格。接著逐站畫圖、檢查異常,最後把結果放進簡報或報告。
這套方法不是笨方法。它可能正是經過幾次資料錯位、單位混亂和圖畫錯站之後,慢慢練出來的可靠流程。因為每一步都親手做過,我知道資料從哪裡來,也比較容易察覺哪條線不太對勁。
如果把前面的能力變化放進這個例子,會看得更清楚。搜尋引擎還不普及時,知道資料由哪個機構保存、去哪裡申請,以及檔案名稱代表什麼,本身就是重要經驗。搜尋變方便後,我們可以更快找到入口和說明文件,但仍得分辨觀測資料、模式資料與再分析資料,也得確認網站是不是原始來源。
到了 LLM 時代,AI 甚至可以幫忙找文件、撰寫下載程式、整理欄位,再畫出第一張圖。可是,測站時間使用哪個時區、缺值如何編碼、單位有沒有被換掉,圖上的異常究竟是自然現象還是儀器問題,並不會因為 AI 畫得很漂亮就自動得到答案。
面對這些新工具,最直覺的改法可能是保留原本流程,只叫 AI 幫忙把每一步加快。
以前自己找下載網址,現在叫 AI 幫忙找;以前手動整理欄位,現在叫 AI 寫程式整理;以前逐張畫圖,現在叫 AI 一口氣生出二十張。整套流程跑得更快,看起來也非常進步。
但仔細一看,我可能只是把原本的路走快了,沒有確認是不是還有另一條更適合現在的路。
只替舊流程加速:
逐站下載 → AI 整理 → AI 畫完所有圖 → 人再慢慢檢查

重新設計一次:
固定資料入口 → 自動保留並檢查必要欄位
→ 先標出需要注意的測站 → 人類核對原始資料與科學意義
重新設計的版本不一定比較好,AI 標出的測站也只是一批待檢查的候選者,不是科學結論。這個對照只是讓我們看見:提高每一步的速度,和重新決定哪些步驟應該存在,是兩件不同的事。
如果資料服務本來就能提供固定欄位,真正值得問的可能不是「怎麼搬快一點」,而是「這一步為什麼還存在?」如果 AI 可以先協助找出值得注意的資料,我們也要問:它依據什麼條件篩選?有沒有漏掉科學上重要、數值上卻不顯眼的變化?
重新設計流程不是把所有事情丟給 AI,而是重新安排工作。重複取得與整理資料的部分可能交給工具,人則把更多注意力放在資料來源、檢查條件、異常判斷與科學解釋。
看到另一條路之後,仍然不必立刻搬家。下一步應該是先確認它能不能走。
重新檢查不代表把舊方法整套刪除。比較實際的做法,是挑一個自己反覆做過的小工作,讓新舊方法在同一個問題上各走一次。
以測站資料為例,我可以先寫下舊流程:資料從哪裡下載、哪些欄位需要整理、如何檢查異常、最後產出什麼。接著再問,這些步驟當初解決了什麼限制?那些限制今天是否仍然存在?
然後只改一小段。也許先測試透過 API 取得一週資料,而不是重做整套研究;也許讓 AI 產生清理程式,但保留原始資料、整理後資料與檢查結果;也許讓繪圖 Skill 製作正式版本,同時確認它和基準圖使用的是同一份數字。
最後比較兩條路:完成同一份資料各需要多久?得到的數字是否一致?發生錯誤時,能不能找到問題出在哪一步?我是否知道 AI 修改了哪些資料?換一批資料後,流程還能不能再次執行?
測試結果可能是保留、修改、替換,也可能是證據不足。新方法比較快,不代表比較可靠;舊方法比較熟,也不代表每一步都值得留下。即使最後發現舊方法仍然最好,這也是有價值的結果。
保留,代表既有流程在品質、成本或可控性上仍然合適。修改,代表核心判斷值得留下,但部分重複操作已經可以交給工具。替換,則代表流程依賴的條件已經改變。證據不足時,也可以讓兩種方法再並行幾次,不必急著宣布革命成功。
重點不是一定要讓 AI 獲勝,而是不要讓「一直以來都這樣做」替今天的選擇自動作答。
過去的做法是證據,不是定律。
它證明一套流程曾在某些條件下可以運作。接下來要做的,是確認那些條件今天是否還在。
AI 時代真正需要的適應能力,不是每天更換工具,也不是看到新方法就立刻拋棄原本流程。
它比較像一種持續檢查的習慣:看見環境發生變化時,能重新拆開既有做法,分辨哪些步驟仍然有價值、哪些只是過去限制留下的痕跡,再用小規模測試決定要不要調整。
昨天的答案不需要因為今天出現 AI 就全部作廢。真正值得保留的,可能不是一套永遠不變的流程,而是我們能根據新證據修正流程的能力。
可是,當我們拿著熟悉做法去問 AI,還會遇到一個更麻煩的問題。AI 可能不但沒有挑戰我們,還順著原本的方向,補上更多理由、例子和漂亮文字。
如果我們已經待在一個 Local Minimum,它甚至可能幫忙把環境弄的更chill,再寫一篇「這個山谷為什麼最適合你」的完整報告。
明天 Day 25,我們就要談:AI 最危險的地方,為什麼可能是它讓你更相信自己。
選一件自己已經做得很熟的工作,問問自己:這套流程當初解決了什麼限制?那些限制今天還存在嗎?如果現在從零設計,我還會保留完全相同的步驟嗎?
今天最想留下的一句話是:
適應改變不是一直換工具,而是知道什麼時候該重新檢查自己的做法。


 iThome鐵人賽
 看影片追技術