

昨天我們已經完成第一個跨來源流程:先查 Google Sheets,再根據結果查詢文件。這套流程可以正常運作,但它有一個很明顯的限制——所有步驟都是我們事先寫好的。只要使用者換一種問法、任務多了一個資料來源,或中間結果需要改變後續動作,就可能需要再增加新的條件與流程。
這時候就會碰到一個很重要的分界:Tool Use 不等於 Agent。 一個系統即使擁有很多工具,只要每一次執行順序都由程式事先決定,它仍然可能只是固定的 Workflow。真正開始具有 Agent 特性的地方,是系統能根據使用者的任務,以及前一步執行得到的結果,重新決定下一步要做什麼。
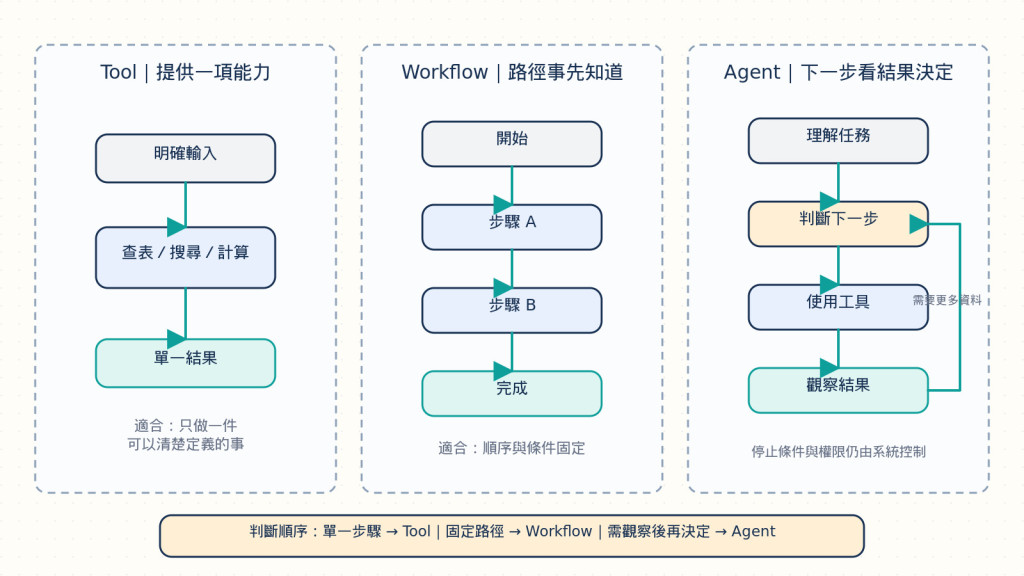
Tool 可以理解成一項可以被呼叫的能力,例如查詢 Google Sheets、搜尋文件、取得專案狀態,或呼叫某個外部 API。它本身通常不會理解整個任務,也不會判斷自己什麼時候應該被使用。
例如 query_google_sheets、search_documents 和 get_project_status,這些 Tool 各自負責完成一件明確的工作。query_google_sheets 不需要知道為什麼使用者現在想查數字,search_documents 也不需要知道查完文件之後還要不要繼續做其他事情。
Agent 則多了一層「決策」。它收到使用者問題後,會先理解目前需要哪些資訊,再選擇適合的 Tool。Tool 執行完成後,Agent 還會觀察結果,判斷目前的資訊是否足夠,或是不是需要進一步查詢其他來源。整體可以簡化成:
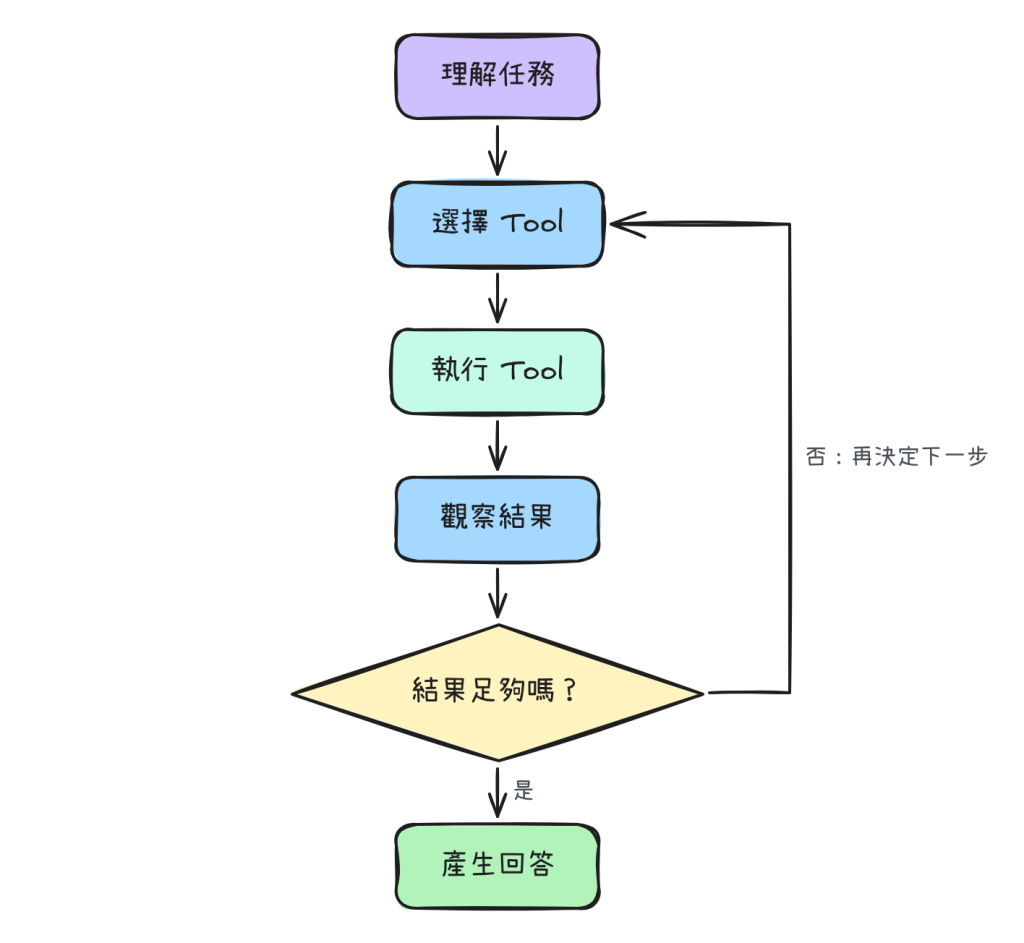
如果資料不足,Agent 可能更換 Tool、調整查詢參數,或要求使用者補充資訊。這個「執行之後再次判斷」的循環,才是從固定自動化流程走向 Agent 的核心。
前一天我們介紹的跨來源流程,其實仍然是一個 Workflow:Step 1 查 Google Sheets,Step 2 取得 Top Category,Step 3 用 Top Category 查 PDF,Step 4 查 Project Status,Step 5 整合答案。無論使用者問多少次,只要進入這條流程,執行順序大致都是相同的。
但假設使用者改問:
「今年哪一類需求最多?如果文件有正式定義就告訴我,如果沒有,再看看 Confluence;如果這一類目前有改善專案,也一起告訴我。」
這時候執行路徑就開始變得不固定。可能的流程是:
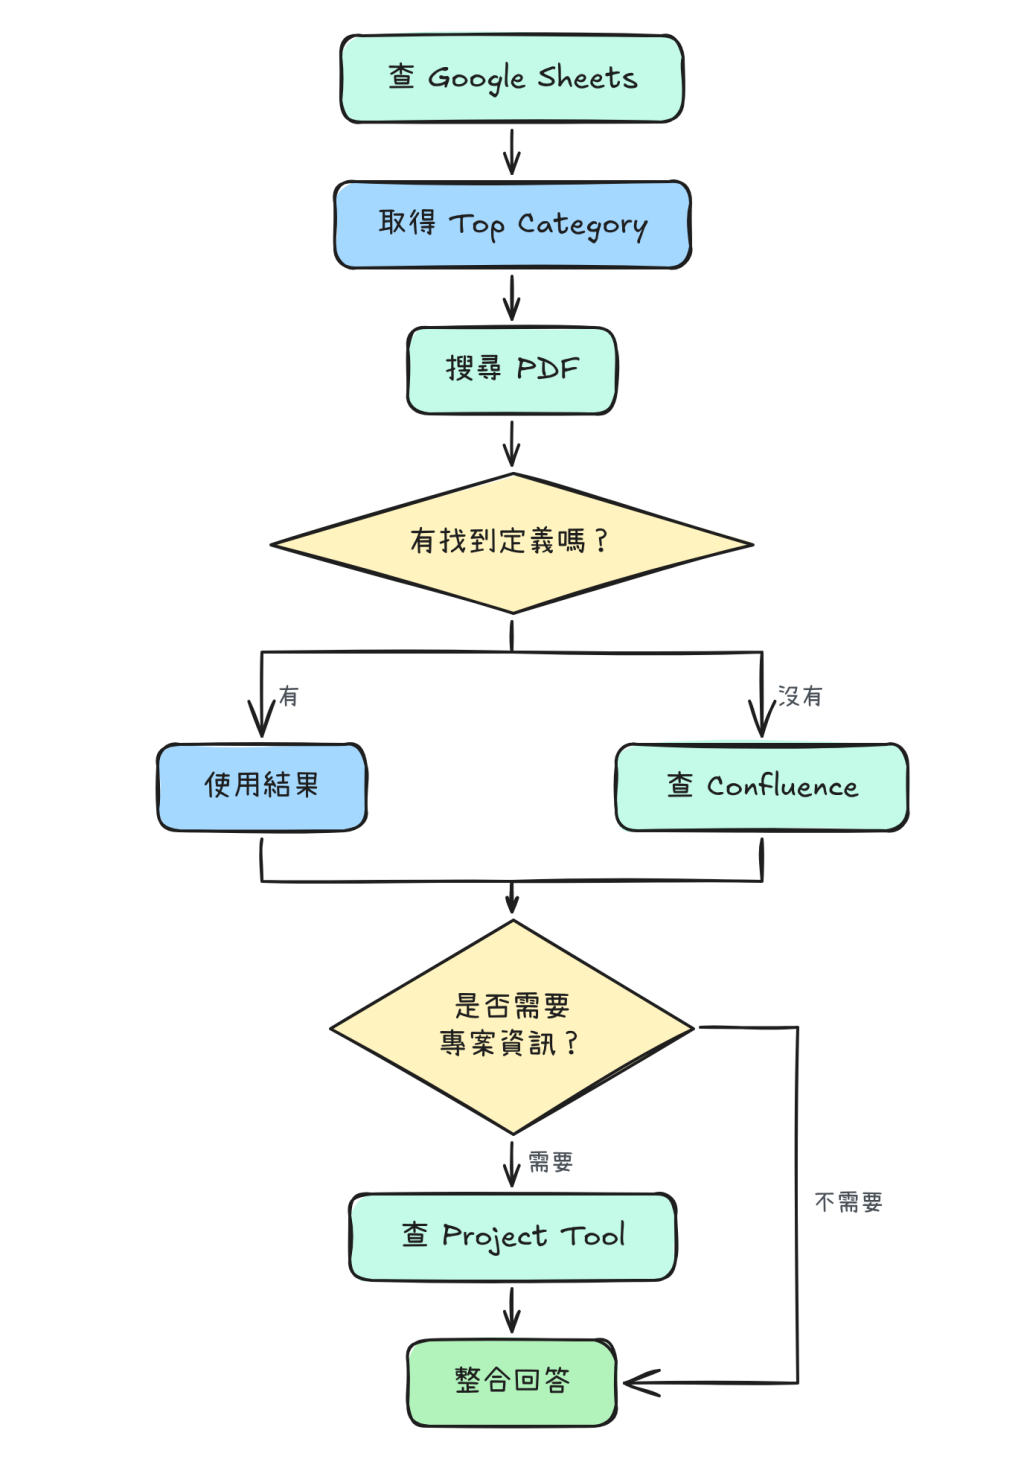
這時「下一步要做什麼」開始依賴前一步的結果,系統不再只是照固定順序執行,而是需要進行動態判斷。這就是 Agent 比固定 Workflow 多出來的能力。
談到 Agent 時,很容易出現一個誤區:既然 Agent 比較有自主性,就代表所有流程都應該改成 Agent。實際上並不是這樣。如果任務的步驟非常固定、規則清楚,而且輸入與輸出都可以事先定義,Workflow 通常會比 Agent 更可靠、更便宜,也更容易測試。
例如「每天早上 9 點讀取昨天銷售資料,產生固定格式的報表。」這個流程幾乎完全可以事先寫清楚:
每天 09:00 → 讀取昨日資料 → 計算 KPI → 套用報表格式 → 輸出報告
這種情況如果硬加入 Agent,反而會多出不必要的模型判斷、Token 成本與執行不確定性。
但換成另一個問題:「找出最近表現最差的市場,確認這個指標的正式定義,看看是否已有改善專案;如果沒有,就告訴我目前缺少什麼。」這類問題的執行路徑就不容易完全預先寫死。系統需要先看數據結果,再決定下一步查哪個來源,因此 Agent 的價值才開始出現。可以簡單比較:
| 情境 | Workflow | Agent |
|---|---|---|
| 步驟固定 | 適合 | 通常沒必要 |
| 條件明確 | 適合 | 可不用 |
| 每次流程大致相同 | 適合 | 可能過度設計 |
| 問題類型很多 | 規則可能快速膨脹 | 適合 |
| 下一步依賴中間結果 | 可以做,但會增加分支 | 適合 |
| 需要語意判斷 | 較困難 | 適合 |
| 行為容易預測 | 高 | 較低 |
| 成本與延遲 | 較低 | 通常較高 |
因此 Agent 並不是 Workflow 的升級版,而是適合處理另一種問題類型的設計方式。
在 Data Machi 最早的版本中,我們可以用很簡單的規則判斷問題:如果是文件問題就交給 PDF RAG,如果是數字問題就交給 Google Sheets Tool。當只有兩三個工具時,這種方式其實完全合理。
但隨著 Knowledge Map 開始出現更多來源,例如 Google Sheets、PDF RAG、Confluence、Trello、Database 和 External API,使用者也可能提出「找出最近下降最多的市場,確認這個 KPI 的定義,再看看是否有相關改善計畫。」或「這個專案延遲了嗎?如果延遲,先確認正式 Deadline,再檢查最近的進度紀錄。」這樣的問題。如果每一種組合都使用 if / else 事先寫死,程式很快會變成:
if 問題 A:
    tool_1
elif 問題 B:
    tool_2
elif 問題 C and 條件 D:
    tool_1
    tool_3
elif 問題 E and 條件 F:
    tool_2
    tool_4
...
這種方式不是不能做,但當使用者問題的組合越來越多,規則會快速增加,也很難涵蓋自然語言中的所有表達方式。因此 Data Machi 開始需要一個協調者(Coordinator)。
Coordinator 的工作不是自己去讀 Google Sheets 或 PDF,而是依序回答幾個問題:使用者想完成什麼?需要哪些資訊?目前有哪些 Tool 可以使用?先使用哪一個?結果是否足夠?下一步應該做什麼?這一層開始具有 Agent 的角色。
如果系統只是把原本寫死的 if data_question: query_google_sheets(),改成讓 LLM 自己決定「Use query_google_sheets」,這確實已經加入一些動態 Tool Selection,但還不一定代表完整的 Agent 行為。Agent 更重要的能力,是可以根據 Tool Result 繼續判斷。
假設使用者問「CDP 專案現在進度如何?」,Agent 第一次執行 get_project_status("CDP"),得到的 Result 是 No project found。如果只是單次 Tool Calling,流程可能到這裡就結束,直接回答「找不到」。但 Agent 可以觀察這個結果,重新思考:「CDP 可能是縮寫,我需要先知道正式名稱。」接著再執行:
search_documents("CDP")
        ↓
Result:
CDP = Customer Data Platform

        ↓
get_project_status(
  "Customer Data Platform"
)
這就是 Agent 很關鍵的特性:
前一次 Tool Result 會改變下一次的行動。
因此可以把 Agent 簡化成一個不斷循環的過程:
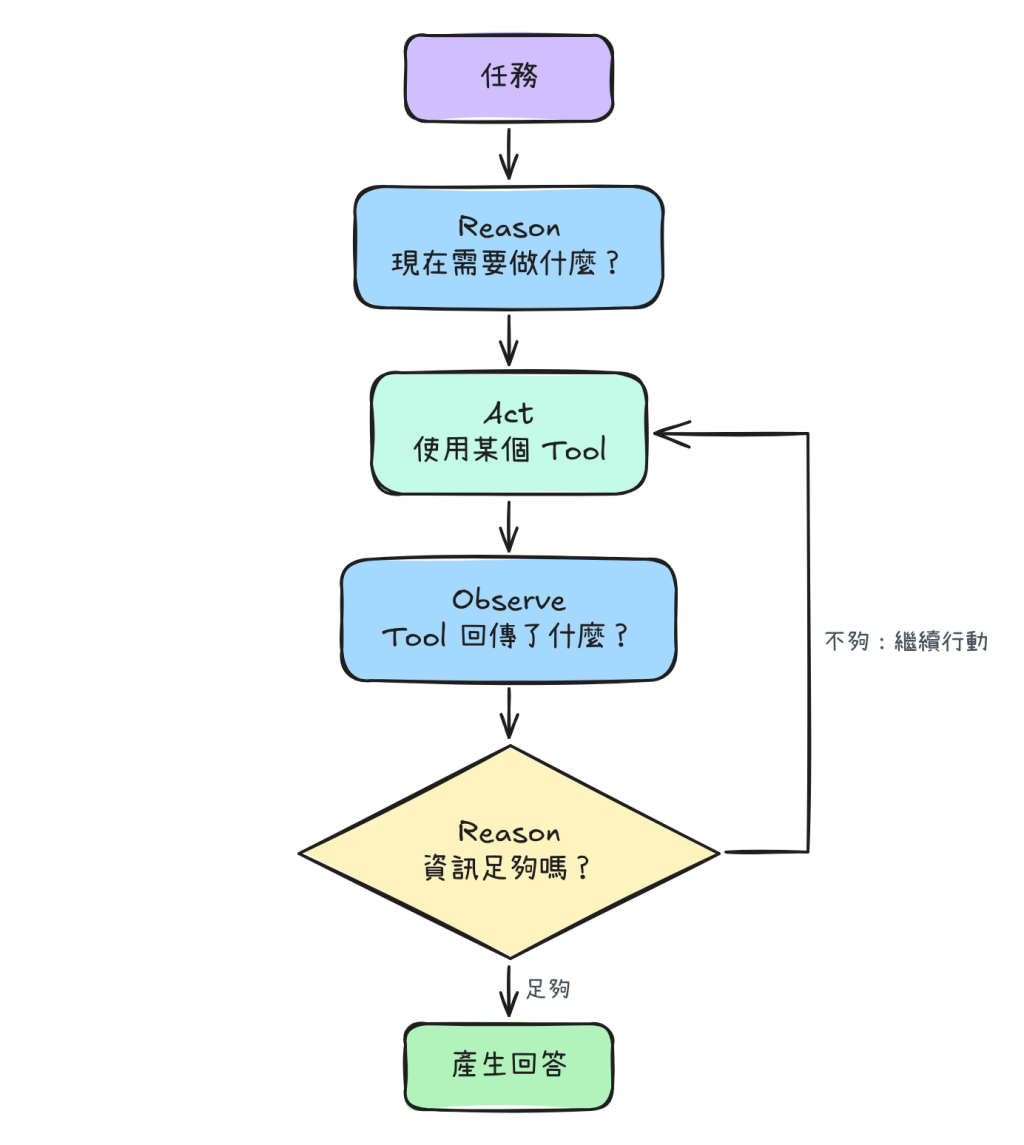
這也是下一篇會進一步介紹的 ReAct(Reason + Act) 思路。現階段先不用把 Agent 想成一個非常複雜的 AI。它最重要的差異只是:不再一次決定完整流程,而是在每一次取得新資訊後,重新判斷下一步。
做到這裡,我們已經出現 Tool、Workflow 和 Agent 三個很容易混在一起的概念。可以用三個問題快速判斷一個功能應該放在哪一層。
1. 只需要完成一件明確的事情嗎? 例如查一張 Google Sheet、搜尋一份 PDF、取得 Trello Card 或查詢目前庫存,這些通常適合做成 Tool。Tool 的責任應該盡量清楚:拿到 Input,完成一件明確工作,再回傳 Output。
2. 步驟能不能事先列清楚? 例如「查資料 → 計算 KPI → 驗證結果 → 產生固定報表」,如果每次大致都走相同路徑,通常使用 Workflow 會比較可靠。
3. 下一步是不是必須看中間結果才知道? 例如先查數據、找出異常市場、根據市場查定義,如果找不到就改查另一來源,再決定是否檢查改善專案。這時候才真正出現 Agent 的需求。
因此可以整理成:
| 類型 | 核心問題 | 例子 |
|---|---|---|
| Tool | 幫我做一件事 | 查銷售、搜尋文件 |
| Workflow | 按照哪些步驟完成? | 查資料 → 驗證 → 報告 |
| Agent | 下一步應該做什麼? | 根據結果動態選擇 Tool |
這個順序可以避免一個很常見的問題:把所有東西都設計成 Agent。
Agent 帶來彈性,但彈性並不是免費的。每多一次模型判斷,通常就代表更多 Token、更多等待時間,以及更多可能走錯路的機會。固定 Workflow 原本可能兩個 API Call 就能完成,如果 Agent 不斷嘗試不同 Tool,可能變成四次、五次甚至更多呼叫。
例如固定 Workflow 只要 Tool A、Tool B 兩步就能回答,共 2 次 Tool Call。Agent 則可能變成:
Tool A
 ↓
結果不足
 ↓
Tool C
 ↓
沒有找到
 ↓
Tool B
 ↓
再查 Tool A
 ↓
回答

共 4 次 Tool Call
如果這些額外步驟真的有必要,當然值得。但如果原本就能用固定規則完成,就沒有必要只為了「看起來比較 Agentic」而增加複雜度。Agent 應該被使用在真正需要動態決策的地方,而不是當成所有 AI Application 的預設架構。
Agent 可以自己選擇下一步,不代表它可以無限制地自由行動。企業環境中的 Agent,更合理的設計是可以自主決策,但只能在有限範圍內。至少應該限制幾件事情。
可使用的 Tool 有限。 Agent 只能使用系統明確提供的 Tool(Allowed Tools),例如 query_google_sheets、search_documents 和 get_project_status,而不是自己連接未知的系統。
資料範圍有限。 即使有 search_documents,也不代表 Agent 可以搜尋公司所有文件。Tool 本身仍然需要遵守資料與權限邊界。
嘗試次數有限。 如果一直找不到答案,不應該陷入「Search → No Result → Search Again → No Result」的無限循環。可以設定例如 Maximum Tool Calls = 5,超過之後就停止並說明目前資料不足。
某些情況必須詢問使用者。 例如找到 Customer Data Platform Dashboard Revamp 和 Customer Data Platform Migration 兩個名稱都很接近的專案,這時候 Agent 不應該自行挑選,而可以回問:「目前找到兩個可能相關的 CDP 專案,你指的是 Dashboard Revamp 還是 Platform Migration?」
高風險 Action 需要確認。 如果未來 Tool 從「查資料」進一步變成「修改資料」,例如 delete_record、send_email 或 update_project_status,則應該有更明確的確認與權限控制,而不是讓 Agent 單獨決定執行。
因此企業 Agent 的自主性並不是「你想做什麼都可以。」,而比較像:
「在被授權的 Tool、資料範圍、步驟上限與停止條件內,自主選擇下一步。」
這才是比較可控的 Agent 設計。
做到 Day 16,Data Machi 的能力已經可以整理成五層:LLM 理解自然語言,RAG 取得文件知識,Tool Use 取得外部資料,Workflow 串起多個步驟,Agent / Coordinator 則根據任務與結果動態決定下一步。
但接下來的目標不會只是讓 Coordinator 有更多自由。如果 Agent 可以自己選 Tool,就需要知道它為什麼選、執行了什麼、什麼時候應該停止,以及結果是否真的可靠。因此後面的重點會逐漸從「怎麼讓 AI 做更多事情?」轉向:
「怎麼讓 AI 的決策過程可以被觀察、驗證與控制?」
這也是企業 Agent 和單純 Demo 最大的差別之一。
Agent 很容易讓人聯想到一個可以自主完成所有事情的「數位員工」,但真正適合企業環境的 Agent 通常反而有非常清楚的限制。
它擁有的 Tool 是有限的、能讀取的資料有範圍、每一次 Tool Call 都可以留下紀錄,而且執行到一定步數之後必須停止。遇到不確定資訊時,Agent 也應該能選擇承認資料不足或向使用者確認,而不是為了完成任務持續猜測。
因此 Agent 的價值不是「無限制自主」,而是:
在明確的安全邊界內,替原本無法完全預先寫死的決策提供有限自主性。
今天的重點:
Agent 的本質不是「有很多 Tool」,而是能在每一次 Tool 執行之後觀察結果,重新判斷下一步。步驟明確的工作仍然適合 Workflow;只有當下一步真的必須依賴語意或中間結果時,Agent 的自主判斷才有價值。
下一篇,我們會使用 ReAct 的概念,把 Agent 的決策循環拆得更清楚,看看它如何在 Reason、Act 與 Observe 之間持續移動,以及為什麼這個循環同時也需要停止條件。
我們下集見囉!


 iThome鐵人賽
 看影片追技術