

在 AI 中台架構中,單一模型供應商(Provider)存在嚴重的單點故障(SPOF)與廠商鎖定(Vendor Lock-in)風險。例如當 OpenAI 遭遇服務中斷、限流(Rate Limit)或回應延遲驟增時,助理服務可能瞬間停擺。
今天我們將以物件導向與策略模式(Strategy Pattern),在 Python 中建立統一的介面抽象層,封裝 OpenAI、Anthropic Claude 與 Google Gemini 的 API 調用,並實作跨 Provider 的自動容錯降級(Fallback)機制。
各家 LLM 供應商的 API 參數與回傳結構皆不相同:
messages=[{"role": "user", "content": "..."}],Token 欄位於 usage.prompt_tokens。system 參數外傳,messages 角色格式略有差異。contents=[{"role": "user", "parts": [...]}],欄位與狀態碼結構皆獨立。我們的目標是透過中台抽象層,對上游(Gateway)提供統一介面,對下游封裝異質性:
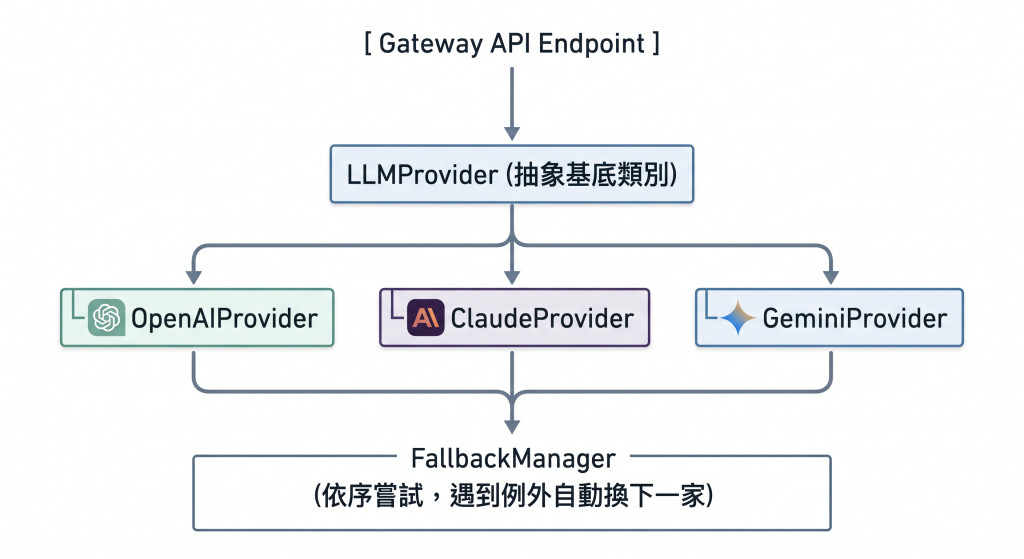
使用 Pydantic 定義與 Provider 無關的統一請求與回應格式,存檔為 models.py:
from pydantic import BaseModel, Field
from typing import List, Optional

class ChatMessage(BaseModel):
    role: str  # "system", "user", "assistant"
    content: str

class ChatCompletionRequest(BaseModel):
    model: Optional[str] = None
    messages: List[ChatMessage]
    temperature: float = 0.2
    max_tokens: int = 2048

class TokenUsage(BaseModel):
    prompt_tokens: int
    completion_tokens: int
    total_tokens: int

class ChatCompletionResponse(BaseModel):
    provider: str
    model: str
    content: str
    usage: TokenUsage
建立 providers.py,定義統一抽象介面並實作具體轉接器(Adapters):
from abc import ABC, abstractmethod
import os
from openai import OpenAI
import anthropic
import google.generativeai as genai
from models import ChatCompletionRequest, ChatCompletionResponse, TokenUsage

class BaseLLMProvider(ABC):
    @abstractmethod
    def generate(self, request: ChatCompletionRequest) -> ChatCompletionResponse:
        pass

# 1. OpenAI 實作
class OpenAIProvider(BaseLLMProvider):
    def __init__(self, api_key: str = None, model: str = "gpt-4o-mini"):
        self.client = OpenAI(api_key=api_key or os.getenv("OPENAI_API_KEY"))
        self.default_model = model

    def generate(self, request: ChatCompletionRequest) -> ChatCompletionResponse:
        model = request.model or self.default_model
        messages_payload = [{"role": m.role, "content": m.content} for m in request.messages]

        resp = self.client.chat.completions.create(
            model=model,
            messages=messages_payload,
            temperature=request.temperature,
            max_tokens=request.max_tokens
        )
        return ChatCompletionResponse(
            provider="openai",
            model=model,
            content=resp.choices[0].message.content,
            usage=TokenUsage(
                prompt_tokens=resp.usage.prompt_tokens,
                completion_tokens=resp.usage.completion_tokens,
                total_tokens=resp.usage.total_tokens
            )
        )

# 2. Claude (Anthropic) 實作
class ClaudeProvider(BaseLLMProvider):
    def __init__(self, api_key: str = None, model: str = "claude-3-5-sonnet-20241022"):
        self.client = anthropic.Anthropic(api_key=api_key or os.getenv("ANTHROPIC_API_KEY"))
        self.default_model = model

    def generate(self, request: ChatCompletionRequest) -> ChatCompletionResponse:
        model = request.model or self.default_model
        system_prompt = ""
        user_messages = []

        for m in request.messages:
            if m.role == "system":
                system_prompt += m.content + "\n"
            else:
                user_messages.append({"role": m.role, "content": m.content})

        resp = self.client.messages.create(
            model=model,
            system=system_prompt.strip() if system_prompt else anthropic.NOT_GIVEN,
            messages=user_messages,
            temperature=request.temperature,
            max_tokens=request.max_tokens
        )
        return ChatCompletionResponse(
            provider="anthropic",
            model=model,
            content=resp.content[0].text,
            usage=TokenUsage(
                prompt_tokens=resp.usage.input_tokens,
                completion_tokens=resp.usage.output_tokens,
                total_tokens=resp.usage.input_tokens + resp.usage.output_tokens
            )
        )

# 3. Gemini (Google) 實作
class GeminiProvider(BaseLLMProvider):
    def __init__(self, api_key: str = None, model: str = "gemini-1.5-flash"):
        genai.configure(api_key=api_key or os.getenv("GEMINI_API_KEY"))
        self.default_model = model

    def generate(self, request: ChatCompletionRequest) -> ChatCompletionResponse:
        model_name = request.model or self.default_model

        system_instruction = "\n".join([m.content for m in request.messages if m.role == "system"])
        model = genai.GenerativeModel(
            model_name=model_name,
            system_instruction=system_instruction if system_instruction else None
        )

        # 轉換歷史對話格式
        contents = []
        for m in request.messages:
            if m.role != "system":
                contents.append({
                    "role": "user" if m.role == "user" else "model",
                    "parts": [m.content]
                })

        resp = model.generate_content(
            contents,
            generation_config={"temperature": request.temperature, "max_output_tokens": request.max_tokens}
        )

        return ChatCompletionResponse(
            provider="gemini",
            model=model_name,
            content=resp.text,
            usage=TokenUsage(
                prompt_tokens=resp.usage_metadata.prompt_token_count,
                completion_tokens=resp.usage_metadata.candidates_token_count,
                total_tokens=resp.usage_metadata.total_token_count
            )
        )
建立 manager.py,管理候選 Provider 鏈。當優先 Provider 出現異常(超時、限流、5xx 錯誤)時,自動依序調用備援方案:
import logging
from typing import List
from models import ChatCompletionRequest, ChatCompletionResponse
from providers import BaseLLMProvider, OpenAIProvider, ClaudeProvider, GeminiProvider

logging.basicConfig(level=logging.INFO)
logger = logging.getLogger("LLMManager")

class FallbackLLMManager:
    def __init__(self, providers: List[BaseLLMProvider]):
        self.providers = providers

    def execute_with_fallback(self, request: ChatCompletionRequest) -> ChatCompletionResponse:
        last_exception = None

        for provider in self.providers:
            try:
                logger.info(f"嘗試調用 Provider: {provider.__class__.__name__}")
                return provider.generate(request)
            except Exception as e:
                logger.warning(f"Provider {provider.__class__.__name__} 調用失敗: {str(e)},切換下一備援節點。")
                last_exception = e
                continue

        # 若所有 Provider 均失效,拋出最終錯誤
        raise RuntimeError(f"所有雲端 Provider 均無法回應,最後錯誤: {last_exception}")
撰寫 main.py 進行調用測試:
from models import ChatCompletionRequest, ChatMessage
from providers import OpenAIProvider, ClaudeProvider, GeminiProvider
from manager import FallbackLLMManager

# 定義容錯順序:優先 OpenAI -> 備援 Claude -> 最終備援 Gemini
manager = FallbackLLMManager([
    OpenAIProvider(),
    ClaudeProvider(),
    GeminiProvider()
])

request = ChatCompletionRequest(
    messages=[
        ChatMessage(role="system", content="你是一位嚴格遵循企業標準的架構顧問。"),
        ChatMessage(role="user", content="微服務架構中,Database per service 模式的主要優缺點為何?")
    ],
    temperature=0.2
)

result = manager.execute_with_fallback(request)

print(f"\n[調用成功]")
print(f"實際生效 Provider: {result.provider} ({result.model})")
print(f"Token 消耗: Prompt={result.usage.prompt_tokens}, Completion={result.usage.completion_tokens}, Total={result.usage.total_tokens}")
print(f"回覆內容:\n{result.content}")
上層邏輯解耦:中台的 API Gateway 只要處理統一的 ChatCompletionRequest 與 ChatCompletionResponse,無論底層增加多少模型,皆無需改動業務邏輯。
Token 標準化:各供應商回傳的 Usage 欄位不同,透過轉接器統整為 TokenUsage,為後續第四週的「Token 計費與配額監控」打下標準資料基礎。
無縫切換:未來可透過後台配置動態調整 FallbackLLMManager 內部的陣列順序,實現低成本動態選路。
模型端點(地端與雲端)皆已封裝完畢。明天 Day 05 我們將正式動手實作中台核心 Gateway 基礎骨架,利用 FastAPI 搭建統一入口端點,並串接 API Key 驗證與標準錯誤處理機制。


 iThome鐵人賽
 看影片追技術