
在這個系列中,我們主要會使用 PostHog,搭配一個 Next.js 專案進行實作。
PostHog 對我而言有點像是軟體開發的瑞士刀。不見得所有需求都能做到最好,但對小團隊或個人開發者來說,涵蓋的範圍已經相當廣。
我之前也看過他們的創業經歷,滿有趣的,有興趣可以看看:《A story about pivots》。
簡單來說,他們曾經嘗試過許多看起來有機會的產品,但大多沒有成功找到 Product-Market Fit(PMF)。有趣的是,在不斷嘗試新產品的過程中,他們一次又一次需要自己實作產品分析工具。最後才意識到:這個他們一直反覆解決的問題,本身可能就是一個產品。
於是有了 PostHog。
我無意在這裡講古,所以歷史就先到這裡。相信更多人首先在意的還是價格。畢竟如果一套工具一開始就要每個 Seat 收 20 美金,想迅速導入團隊可能就沒那麼容易了。(你感覺到我在臭誰?你是對的。)
PostHog 的核心是開源的,因此你可以選擇部署在自己的環境中,不需要向 PostHog 支付 SaaS 費用。另一方面,他們的 Cloud 方案也提供相當寬裕的免費額度。PostHog 宣稱約 90% 的專案都落在免費額度內,而且他們甚至相當有自信地表示,自架的總成本通常不會比直接使用 Cloud 更便宜。
免費方案不需要先提供付款資訊;即使切換成按量計費來啟用更多功能,也可以替不同產品設定 Spending Limit,甚至直接設成 0,避免意外產生費用。
安裝其實非常簡單:
npx -y @posthog/wizard@latest
接著照著 Wizard 一步一步完成。相關 LLM 費用由 PostHog 支付,因此不需要擔心消耗你的 Coding Agent 額度。如果你是一個 Old School 的工程師,你也可以查看安裝指引文件來自行完成。
安裝結束。
開玩笑的。
Wizard 確實可以處理大量樣板工作,但真正放進專案時,我認為還是有幾個地方值得特別確認。
PostHog 用來區分使用者的核心欄位是 distinct_id。
當使用者登入後,可以透過 posthog.identify() 告訴 PostHog:「目前這個匿名使用者,其實就是系統裡的某一個已知使用者。」
在 Next.js 前端,大致會是這樣:
posthog.identify(
  "distinct_id",
  {
    email: "max@hedgehogmail.com",
    name: "Max Hedgehog",
  }
);
第一個參數就是這名使用者的 distinct_id,後面的物件則可以附帶 Email、名稱等 Person Properties。
這個 ID 很重要,因為之後許多 PostHog 功能都會依靠它把不同事件串回同一名使用者。因此,我通常會建議使用系統本身最穩定、最主要的 User ID。
如果你的專案使用 Clerk、Auth0 或其他第三方登入服務,Wizard 可能會直接拿登入服務提供的 User ID 作為 distinct_id。這不一定有問題,但如果第三方服務只是負責 Authentication,而你自己的資料庫另外存在一套 User ID,就值得先想清楚哪一個才應該成為整個產品分析系統中的主要識別值。
另外,如果登入流程比較複雜,例如不同入口、OAuth Callback、邀請註冊,甚至經過多次 Redirect,也應該實際檢查所有登入路徑是否都有正確觸發 identify()。
否則很容易出現一個狀況:同一名真實使用者,在 PostHog 裡被拆成好幾個不同的人。
這是我實際把 PostHog 導入專案時遇到過的問題。
Wizard 在 Next.js 中可能會同時幫你安裝前端與後端 SDK,但「兩邊都有 PostHog」不代表它們自然就知道彼此屬於同一次操作。
這在 Error Tracking 特別重要。
假設使用者按下一個「購買」按鈕,前端送出 Request,真正的錯誤卻發生在後端。前端最後可能只收到:
Internal Server Error
如果前端事件、Session Replay 與後端錯誤彼此沒有關聯,你看到的就只是:
「某個 API 在某個時間炸掉了。」
但真正想知道的通常是:
「哪個使用者,在什麼操作流程中,做了什麼事情之後,讓這個 API 炸掉?」
因此需要確認前端是否會把 PostHog 的 Session / User Context 一起傳遞到 Backend。
例如:
posthog.init("...", {
  api_host: "https://us.i.posthog.com",

  // 將 PostHog 的 session / user context 傳給 Backend
  tracing_headers: ["api.current.app"],
});
設定後,PostHog 前端 SDK 可以在符合條件的 Request 中加入相關 Tracing Headers,後端 SDK 再從 Request Context 中取得這些資訊。
這樣當後端捕捉到錯誤時,就有機會把它和前端的使用者、Session 與操作歷程串在一起。
最後你看到的就不再只是單獨的一筆 Exception,而是一段完整的脈絡:
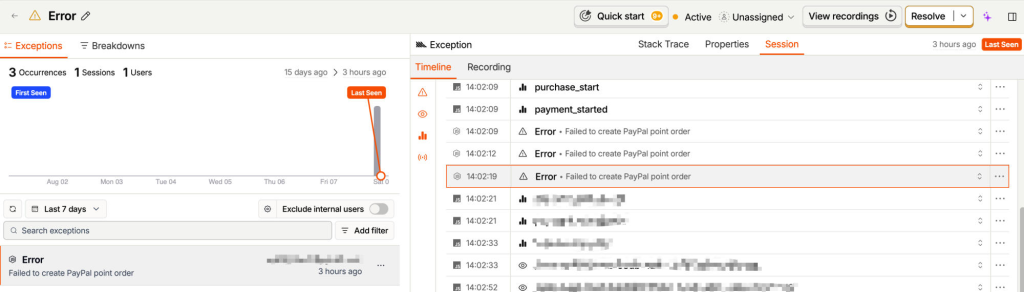
使用者先觸發了 purchase_start,接著發生 payment_started,然後後端連續幾次建立 PayPal 訂單失敗。
這種資訊在 Debug 真實使用者問題時,比單純看到 Stack Trace 有用得多。
PostHog 畢竟是一套追蹤工具,因此不少 Ad Blocker 或隱私保護工具會直接阻擋對 PostHog Domain 的請求。
常見的解法是使用 Reverse Proxy,讓瀏覽器看起來是在向自己的 Domain 發送請求,例如:
https://example.com/ingest/...
再由你的服務轉送到 PostHog。
Wizard 在 Next.js 中通常可以透過 Rewrite 幫你做到這件事。
不過這裡有一個容易忽略的問題:這些 Tracking Request 也會真的進入你的 Next.js Server。
產品分析產生的事件量通常不低。如果你的服務跑在 Cloud Run、ECS 或其他 Auto Scaling 環境,原本完全不需要 Application Server 處理的 Tracking Request,也可能因此增加 Instance 負載,甚至造成額外擴容。
因此 production 環境可以考慮讓這些 Request 更早被處理掉。
其中一種作法是使用 PostHog 的 Managed Reverse Proxy:建立一個自己的 Subdomain,再透過 DNS 指向 PostHog 管理的 Proxy。注意 PostHog 會提示使用比較普遍的字,例如簡單的 b.current.app 而非 posthog.current.app 來降低被阻擋的機會。
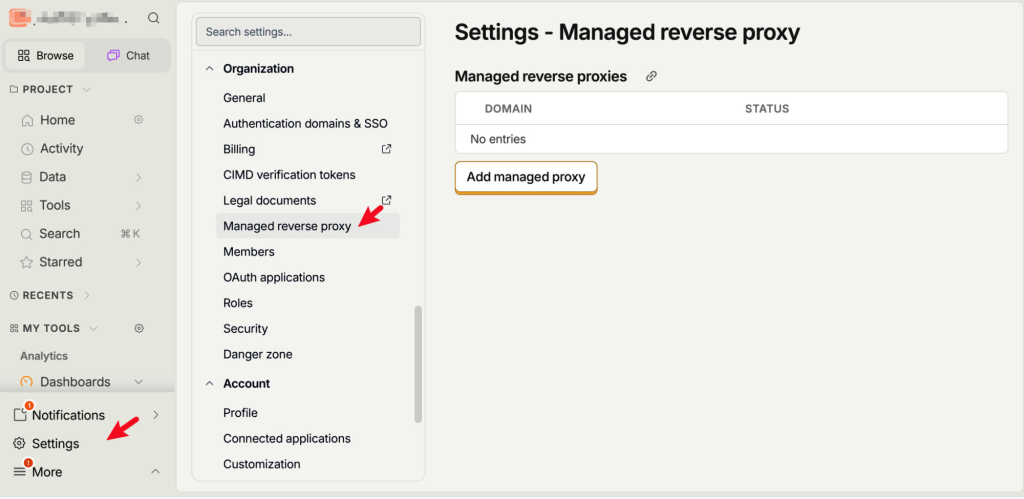
接著更新初始化時的 API Host:
posthog.init("...", {
  api_host: "https://managed-proxy.current.app",
});
另一種方式則是在 Load Balancer 或 CDN 層直接完成 Rewrite,完全不要讓 Request 進入 Next.js。
如果只是用 Next.js Rewrite,大致可以這樣設定:
async rewrites() {
  return [
    {
      source: "/ingest/static/:path*",
      destination: "https://us-assets.i.posthog.com/static/:path*",
    },
    {
      source: "/ingest/array/:path*",
      destination: "https://us-assets.i.posthog.com/array/:path*",
    },
    {
      source: "/ingest/:path*",
      destination: "https://us.i.posthog.com/:path*",
    },
  ];
}
如果使用 GCP Load Balancing,也可以把相同邏輯搬到 Load Balancer。
這樣 Tracking Request 就能直接在 Load Balancer 層被送往 PostHog,不需要占用 Next.js 的運算資源。
完成這些設定後,PostHog 就正式進入你的系統了。
啟動網站並操作幾下之後,打開 PostHog 的 Activity,應該很快就會看到各種事件開始出現。
不過,「收到事件」本身還不是我們真正想解決的問題。
下一篇會先從工程師最熟悉的場景開始:Error Tracking。
很多工程師應該都遇過這種事情:
使用者說:「這裡壞掉了。」
工程師打開自己的環境,操作一次。
「沒有啊,可以用。」
然後故事就開始往「It works on my machine.」的方向發展。
使用者用了產品,不代表他的問題一定能被解決;但如果他用到一半直接遇到錯誤,那幾乎可以確定,他的問題不會被解決。
下一篇,我們就來看看 PostHog 能不能幫我們回答那個最令人頭痛的問題:
「使用者到底做了什麼,才把它弄壞的?」
如果你願意花 30 秒留下回饋,我會用這些意見來調整後續文章:分享你的意見



 iThome鐵人賽
 看影片追技術