
把 AI Observability 接上 Production 後,我們已經可以從 Product Outcome 找到沒有完成任務的使用者,再透過 Session 與 Trace 回頭確認發生了什麼。
真正上線後,很快會遇到另一個問題:Trace 數量會一直增加。每天幾百、幾千甚至更多筆 Interaction,不可能每一筆都人工打開。
Cost、Latency、Token Usage、Error 這類數字可以先幫我們發現系統層面的變化。如果想知道使用者主要拿 AI 做什麼,或某種 Failure 到底只是個案還是反覆發生,就需要再把大量 Trace 整理成可以閱讀的模式。
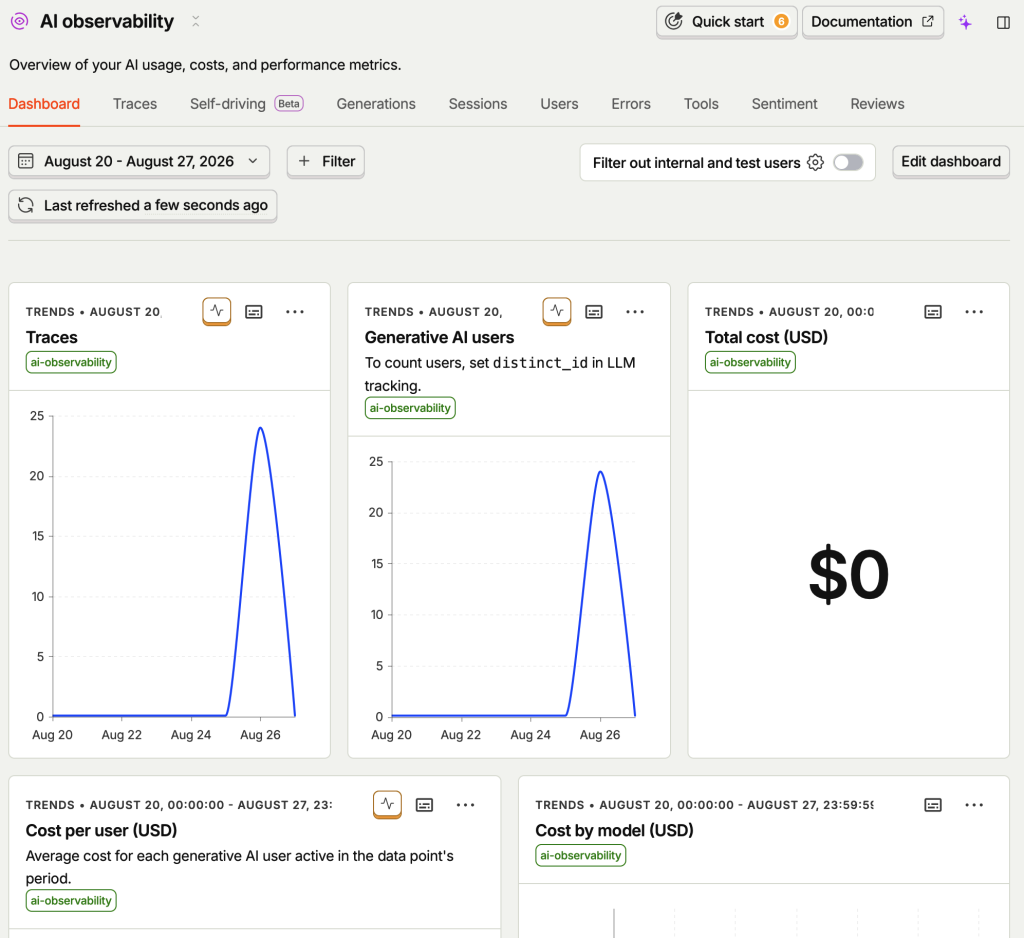
在分析大量資料之前,直接閱讀一部分真實 Trace 還是有價值。PostHog 在回顧自己的 Agent 開發經驗時提到,他們會固定進行「Traces hour」,直接看 Production 裡的真實互動。
開發時可以先想好幾種 Scenario,使用者實際操作時仍然可能完全不同。原本設計來查訂單與退款的客服 Agent,也可能被拿來修改地址、詢問產品規格,或處理其他沒有預期到的問題。
直接看 Trace 可以發現這些情況,也可以看到具體的 Failure。問題是讀到幾筆案例後,還是不知道它們在整體裡佔多少。看到三筆退款問題,可能只是少數使用者,也可能其實是大量重複出現的需求;看到一筆錯誤回答,也很難只靠人工抽樣判斷它是不是一個常見問題。
PostHog 的 Clustering 可以把內容相近的 Trace 分到同一組,先把大量 Interaction 整理成幾種重複出現的模式。
這裡有一個實作上容易遇到的狀況。目前 PostHog 的 Clustering workflow預設分析最近 7 天的資料,而且每個 Clustering level 至少要有 1,000 筆 Trace 或 Generation 才會開始執行。所以剛接上 AI Observability 的小型專案,即使已經有幾十或幾百筆資料,Clusters 頁面仍然可能是空的。這種情況不一定是資料沒有送進去,而是還沒到 Clustering 的資料量門檻。
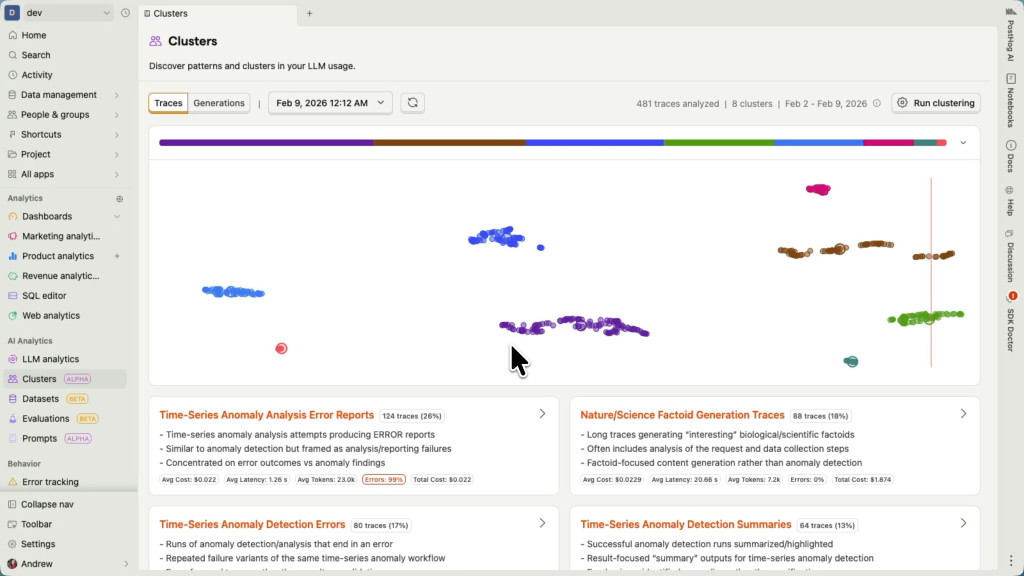
以客服 Agent 為例,最後可能看到像 Order lookup、Refund policy questions、Address changes、Product questions 這類 Cluster。這時不需要從所有 Trace 裡隨機抽樣,而是可以先看哪些 Cluster 數量明顯較多,再打開其中的代表案例。
如果 Address changes 佔了一個明顯的 Cluster,而這原本根本不是設計時預期的功能,就可以知道使用者正在用另一種方式理解這個 Agent。另一種情況則是某個 Cluster 裡反覆出現相似 Failure,這時也比較容易確認問題不是單一案例。
Clustering 在這裡處理的不是「這一筆為什麼錯」,而是「Production 裡有哪些事情正在重複發生」。
Clustering 本身不會判斷結果是成功還是失敗。Refund policy questions 很大,只能代表很多人都在問退款政策;同一個 Cluster 裡仍然可能同時包含成功和失敗的互動。
Cluster 可以先把 Production 裡的使用方式整理出來。真的要判斷是不是產品問題,還是要回到 Product Outcome、Feedback、Sentiment,以及 Cluster 裡的代表 Trace。
一個很大的 Cluster 可能代表重要 Use Case,也可能只是正常使用;反過來,一個數量沒那麼大的 Cluster,如果裡面反覆出現轉人工、錯誤回答或其他 Failure,反而可能更值得優先處理。
找到主要 Use Case 或反覆出現的 Pattern 後,還要一起看它付出的 Cost 與 Latency。
同樣是 12 秒的等待時間,放在聊天功能裡可能很明顯,放在每天只執行一次、最後產生重要商業報告的 Agent 裡則可能完全可以接受。Cost 也是一樣,模型升級後品質變好,不代表成本增加多少都值得。
所以這些指標要放回實際的 Job 和 Product Outcome 裡看。Production 裡真正要比較的不是哪一個 Model 的 Benchmark 比較高,而是這項功能是否用合理的成本與等待時間完成使用者的任務。
當某個 Failure 已經確認會在 Production 裡反覆出現,問題就不只是修掉其中一筆 Trace。這些代表案例可以保留下來,整理成 Dataset,之後每次修改 Prompt、Model、Context 或 Tool 時重新驗證。
這樣 Production 裡找到的 Pattern 才不會只停在一次 Debug,而能繼續變成後面的 Eval Case。
如果你願意花 30 秒留下回饋,我會用這些意見來調整後續文章:分享你的意見


 iThome鐵人賽
 看影片追技術