

稽核小組在排下個月的病歷稽核。討論的不是「要看什麼」,而是「要看幾份」。
有人說二十份太少,代表性不夠。有人說二十份已經是能排得出來的極限。護理部的同仁翻了一下班表,那週有兩位要支援評鑑。
(評鑑是外部委員定期到院查核的制度,結果關係到醫院的資格與層級——大致就是你們的 SOC 2 audit:週期性、外面的人來查、過不過有實質後果,所以準備期會整批吃掉人力。)
最後決定:維持二十份。
這場對話我參加過很多次。它討論的從來不是品質,是人力。而且每一次,我們在紀錄上寫下「抽查二十份」的那一刻,都同時做了另一個沒有寫進紀錄的決定:
這個月其餘的病歷,我們放棄了。
不是「暫時不看」。是放棄——放棄對它們說任何一句話的權利。
Day 1 講過稽核的第一個悖論:一旦宣告要看,現場就會變好。今天講第二個——它比較少被提起,但它決定了全量之後那套系統該長什麼樣子。
抽樣是有理論撐腰的。抽得夠隨機、數量夠,就能推論母體。這件事在統計上完全成立,我不打算挑戰它。
問題在於,它推論出來的東西是什麼。
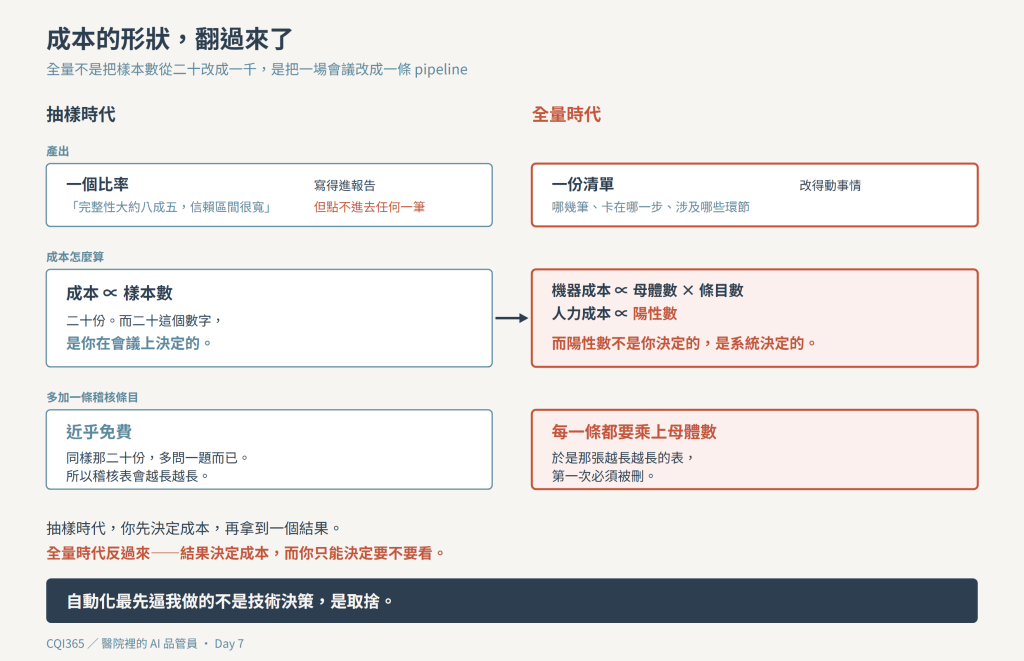
抽二十份,三份不合格。你得到的結論是:這個單位的病歷完整性大約在八成五左右,信賴區間很寬。這句話可以寫進報告、畫成趨勢圖、拿去品質委員會。
但單位主管拿到這份報告,能做什麼?
他不能改那三份——那三份的病人早就出院了。他也不能改另外那些沒被抽到、可能同樣有問題的病歷,因為他不知道是哪幾份。他唯一做得到的事情是:加強宣導。
(「加強宣導」「加強教育訓練」這類對策為什麼永遠最爛,Day 13 有一整篇。)
他手上那份報告是一個 dashboard:線在那裡,數字在那裡,可是點不進去任何一筆。
這就是抽樣真正放棄掉的東西:
抽樣給你的是一個比率,不是一份清單。比率能寫進報告,清單才改得動事情。
而品質改善的行動幾乎全部發生在清單那一端。你要修一個流程,得先指得出哪幾筆出了問題、卡在哪一步、涉及哪些環節。比率指不出來。
所以在這一步,AI 的價值不是「看得比人準」。人看得夠準了,稽核小組裡都是資深同仁。價值是看得完——把比率換成清單。
聽起來只是把二十改成一千。並不是。
整套稽核流程的每一個環節,都是為了「少量」而設計的:
這五件事,沒有一件在全量之後還成立。「當場討論」在一千份的規模下不存在。「做不完可以延一週」也不存在,因為機器不會累——卡住的會是別的東西。
全量不是把樣本數從二十改成一千,是把一場會議改成一條 pipeline。
而 pipeline 有 pipeline 的問題。大部分那些問題我不打算在這裡重講一遍:一千次呼叫要排佇列、要重試、要退避;跑到第七百多份掛掉,要能只補沒跑完的那一段,而不是整批從頭再付一次——每份獨立、結果即時落地、以輸入識別碼加判準版本當 key,跑過的就跳過。冪等。這些是你們的日常,不是我的發現。
品管這邊唯一新鮮的一句是:我們的流程圖上從來沒有「這一步之後會有一段時間沒有人知道發生什麼事」這種狀態,所以資訊單位的同仁問我「跑到一半掛了誰去看」的時候,我答不出來。而且成本的形狀整個翻過來了——抽樣時代多加一條稽核條目近乎免費,所以稽核表格會越長越長;全量時代每加一條都要乘上母體數。自動化最先逼我做的不是技術決策,是取捨。
真正卡住我的是另外兩件事。一件是醫院的東西讓 IT 的老解法失靈;一件是 IT 那邊根本不會當成問題的東西,在品管這裡是。
冪等的前提是同一個 key 對應同一份輸入。在醫院,這個前提不成立。
病歷是活的文件。 它會被補登、被修正、被加上後續病程。會診意見、檢驗報告、出院病歷摘要,各自有各自進到系統裡的時間。你上週讀的那一份,跟這週讀的不是同一份——但病歷號一個字都沒變。
所以重跑得到不同的答案,可能根本不是模型不穩定,是輸入變了。而這兩種情況在結果檔上長得一模一樣:同一個 key、同一版判準、兩個不同的判定。你沒辦法從結果本身分辨它是哪一種。
要區分它們,只有一個辦法:存快照。
稽核的對象不是「這份病歷」,是「這份病歷在某個時間點的樣子」。判定綁在快照上,不綁在病歷號上。
電子病歷會持續更新,稽核小組今天調閱的內容,未必和批次執行當時相同。承辦同仁要能對照的是受控的資料快照與擷取時間,而不是事後重新查詢的最新畫面。資料庫裡那一列會變,先前留下的判定卻不會自動跟著重算。
而它不只是技術細節。一筆判定綁在哪一個時間點的病歷上,決定的是三個月後有人指著它問「憑什麼」的時候,我們兩邊看的是不是同一份東西。
這一條反過來:「部分成功」在你們的系統裡是可以接受的狀態,補跑就好,沒有人會為此改一份報告。在品管不是。
我要拿這批結果去品質委員會的時候,「這個月的病歷稽核涵蓋了七成三」是一句需要解釋的話。而要解釋的其實是那兩成七。
剩下的兩成七去哪了?是隨機掉的,還是有偏的?
這兩個答案的差別很大。隨機掉的,比率還能用,只是信賴區間寬一點。有偏的,整份報告作廢。
而它很容易是有偏的,因為批次失敗本來就不是隨機事件:掉的通常是特別長的那幾份——逾時、超過長度上限、格式異常。而特別長的病歷,通常是住院天數久、會診多、狀況複雜的個案。也就是說,沒跑到的那一批,剛好是最可能有問題的那一批。
於是我會拿到一份很漂亮的數字,而它漂亮的原因是難的那些沒跑到。這種偏誤不會出現在任何一個錯誤訊息裡,它出現在報告的結論那一行。
所以全量之後多了一個以前不需要的東西:覆蓋率本身要被監測、要被報告,而且要看它掉在哪裡。
一個只報總數不報覆蓋率的稽核結果,在全量時代是不完整的。你們的說法大概是:沒有標示 sample rate 的指標不能拿來做決策。
這一條明天上班就可以用,而且跟 AI 沒有關係:把你手上任何一份批次跑出來的報表翻到最後,找那個寫著「這次跑到幾成」的欄位。找不到的話,先別討論結論——你還不知道掉的那幾成是隨機掉的,還是全掉在同一種輸入上。
模型的 context 現在很長,一次塞好幾份病歷進去、一次把所有條目問完,都是做得到的。所以第一個要回答的設計問題是:怎麼切。有兩個維度要切——病歷之間要不要分開,判準之間要不要分開。
判準那一維 Day 4 已經定案了:一次一個判準,不要複合問句,否則它答錯的時候你定位不到是哪一項。所以剩下要決定的是病歷那一維,實際考慮過三種:
| 做法 | 好處 | 為什麼不選 |
|---|---|---|
| 一次塞多份,讓它一起判 | 呼叫次數少、便宜 | 位置偏誤、單份無法重跑、判定歸不到單份頭上 |
| 先用規則篩掉明顯沒問題的,剩下才送模型 | 省錢、快 | 篩掉的那些不會留下紀錄,等於偷偷回到抽樣 |
| 一份一條一次呼叫 | 單份可重跑、可歸責、可比對 | 貴、慢 |
選了最貴的那個。理由不是效能,是這件事:
單份獨立不是效能考量,是責任考量。
因為稽核結果最後要面對的場景是——單位主管指著其中一筆問「憑什麼」。那個當下我需要的東西,跟你們查一個 incident 需要的是同一組:只重跑這一筆、指出這一筆用的是哪一版判準、還原這一筆當時看到的輸入。少一樣,這一筆就說不清楚。
如果它是和另外二十九份綁在一起跑的,這三件事全部做不到。我只能說「系統是這樣算的」,而這句話在品質委員會裡沒有任何份量。
Day 1 說過,這份工作真正的重量是得說得出理由。全量之後這句話沒有變輕,只是從一個人的修養,變成了一個架構要求。
至於第二個做法,它其實不完全是錯的——它是第五週人機混合抽樣的雛形。差別只在一件事:篩掉的那些有沒有留下紀錄。有紀錄叫分層處理,沒紀錄叫抽樣。
從「我把一份病歷貼給模型問它」,到「這件事每個月自動跑一次,而且結論會送到單位」,中間要補的東西比想像多。最低限度是三樣,缺一樣這條 pipeline 就不能上線。
輸入固定。 就是前面說的快照。沒有快照,「重現」這個詞沒有意義。
判準固定。 每一次判定要記錄它用的是哪一版條目。改一個字都是新版本,因為改一個字結果就會變。這件事第五週有一整篇,這裡只講它為什麼第七天就得先做:因為判準一定會改,而且是在你已經跑過幾輪之後才改。前幾輪沒記版本,那些結果就報廢了。
輸出結構固定。 不能收自由文字。每一筆判定落成固定欄位:判定值、引用的證據、模型自報的把握程度,以及這次呼叫用的是哪個模型的哪個版本。最後那一項當時覺得是多餘的紀錄,後來證明是整個專案最有用的欄位之一。
抽樣有一個被嚴重低估的好處:它的錯誤會被人看見。
因為每一份都有一個人從頭讀到尾。模型如果判錯了,那個人當場就會皺眉頭。品質的第一道防線不是流程,是有人覺得不對勁。
全量沒有這個機制。一千份跑完,沒有任何一個人從頭讀到尾。如果模型在某一類病歷上系統性地判錯,這個錯誤會安靜地混進總數,變成一個看起來很合理的比率。
而且它會很穩定。每個月都錯,每個月都錯得差不多,趨勢圖漂亮得不得了。
全量最危險的不是錯得多,是錯得穩。穩定的錯誤看起來就像趨勢。
所以全量上線的同時,必須有一組東西是專門用來查它自己的:一批答案已知的案例混進去、輸出分佈的監測、以及對判定結果的人工複核抽樣。
對,抽樣。為了擺脫抽樣而建的全量,第一件事是對自己的結果抽樣——這件事後天那篇會整個攤開來講。
明天先把判準本身講清楚,因為上面所有的架構問題,都建立在一個前提上:那些條目真的判得動。而它們一開始並不。


 iThome鐵人賽
 看影片追技術