

結果檔是週日晚上跑完的。週一早上,品管團隊開啟批次報表,稽核小組準備接手複核;我參與討論時,先注意到總數。
第一眼看到的是總數。被標記為不符合的筆數,用抽樣時代的眼光看是一個離譜的數字——換算成比率,跟我們過去每個月報給品質委員會的數字差了一個量級。
以下所有數字皆為示意值,用來說明結構,不是實測結果。實證結果將另行發表。
我的第一個反應不是高興,也不是恐慌。是一句話:
我們過去看到的世界,可能是假的。
第二個反應來得比較慢,大概十分鐘之後:
也可能,是這份清單是假的。
第三個反應花了更久,而它才是對的:這兩個數字本來就不能放在一起比。
過去那個數字是舊版稽核表、由人在會議室裡判出來的;這一份是用 Day 8 那套改寫過的條目跑的——條目拆細了、排除範圍寫進去了、「無法判定」從人腦會自動跳過的東西變成一個會被計數的值。兩把不同的尺量同一份病歷,本來就會得到不同的結果。
schema 換過之後,舊資料跟新資料畫在同一條折線上,那條線就已經不是同一個指標了。Day 8 那條「條目改版,指標就斷線重畫」的規矩,我當時還沒想到要用在自己身上——在確認兩邊是同一把尺之前,任何比較都不成立。
而真正嚇到我的那件事,要到那個禮拜快結束、品管團隊(品管室,加上稽核小組裡依權限調閱電子病歷的同仁)複核完一批之後才浮出來。跟數字沒有關係。
品管有一個基本到平常不會被講出來的紀律:
發現的問題,在採取行動之前要先確認它成立。
不是因為謹慎,是因為代價。一個不成立的問題送到單位去,會發生三件事:單位花時間解釋、品管室的信用被扣一次、下一次真的問題送過去時對方的第一個動作變成先懷疑。第三件最貴——它不是這一筆的成本,是之後每一筆的成本。
抽樣時代這件事是自動發生的,自動到我從來沒把它當成一個步驟——看的人就是判的人,判的人就是要去跟單位解釋的人。複核不是流程裡的一站,它內建在「有一個資深同仁從頭到尾讀了這份病歷」裡面。
全量之後,這一站消失了。
不是被拿掉,是沒有人注意到它曾經存在。品管的流程圖就是我們的規格書,而複核這一站從來不在規格書上——它一直在跑,只是附著在人身上,沒有任何一份文件承認它存在。
這是自動化既有流程時最容易漏掉的東西:你把流程圖上的步驟一步步搬過去,搬完發現系統壞了——壞在那些沒畫在流程圖上、但一直有人在做的事情上。
那個禮拜我們做的事,說出來有點好笑:
為了擺脫抽樣而做全量,做完之後的第一件事,是對結果抽樣。
品管團隊從被標記的清單裡抽一批出來,人工逐筆看,回答一個問題:這一筆的判定,成立嗎?
但這次抽樣跟 Day 7 談的那種,性質完全不同。差別在一個東西:有沒有答案。
對病歷母體抽樣沒有 ground truth:抽到的每一份都得你自己判,而你的判斷本身就是待驗證的東西。對機器的判定抽樣,ground truth 隨時問得到——找一位資深同仁複核一下就知道。前者是估計,後者是驗證:同樣的人力,抽二十份病歷換到一個比率,抽二十筆判定換到的是這套系統值不值得信任的證據。
複核要分兩邊做,而且兩邊嚴重不對稱。
查偽陽性——從「判不符合」的裡面抽。這一邊很划算:筆數相對少,而且每一筆複核完都直接告訴你哪一條條目寫歪了、歪在哪一種情況。
查偽陰性——從「判符合」的裡面抽。這一邊效率極差:基數很大、實際有問題的比例很低,抽幾十筆可能一筆都沒抓到。而這不代表沒有偽陰性,只代表你抽的量遠遠不夠。
這是每個做監控的人都認得的處境:你要怎麼知道你的告警沒有漏報? 從沒觸發的事件裡隨機抽是抽不出來的。得換方法——第四週那篇「自己造一批有問題的東西丟進去」處理的就是這個。
這一版我們先接受偽陰性查不清楚,並誠實寫進報告:本次結果對「漏抓」的估計能力有限。
這是整件事最重要的結構變化。
抽樣時代,稀缺資源是閱讀量——能排出多少人、看多少份;Day 7 那場排稽核份數的會議,整場都在分配這個資源。全量之後閱讀量不再稀缺,機器有的是。
新的稀缺資源是複核量:有多少位資深同仁的工時,可以花在確認機器說的話是不是真的。而複核量會被偽陽性吃掉——每一筆假警報,都吃掉一份本來可以用在真問題上的專家時間。
| 抽樣時代 | 全量時代 | |
|---|---|---|
| 稀缺資源 | 閱讀量 | 複核量 |
| 成本正比於 | 樣本數 | 陽性數 |
| 誰決定這個數 | 我(排幾份就幾份) | 系統(判幾筆就幾筆) |
| 要省錢怎麼辦 | 改樣本數,當場生效 | 改判準、重跑、重新複核 |
最後兩行是重點:
你把成本從一個你能控制的變數,搬到一個你不能控制的變數上。
抽樣時代,團隊調整查核量就會影響工時。全量時代,若想透過修改判準減少複核負荷——改判準會改變結論,改變結論要重跑,重跑要重新複核。改一次判準就是一次 deploy,慢得多,也危險得多。
還有一件我完全沒預料到的事:單位收到的東西不一樣了。抽樣時代是「這個月抽了二十份,其中三份有問題,以下說明」——三筆,看得完,看完可以坐下來討論。全量時代是幾百筆被標記的清單。
我原本以為這是進步,正好是 Day 7 說的「比率換成清單」。實際上,單位主管的第一個動作不是去看清單,是質疑清單。
而這很合理。如果你的 CI 突然報了四百個錯,你的第一個動作也不是去修,是去看是不是規則寫壞了。
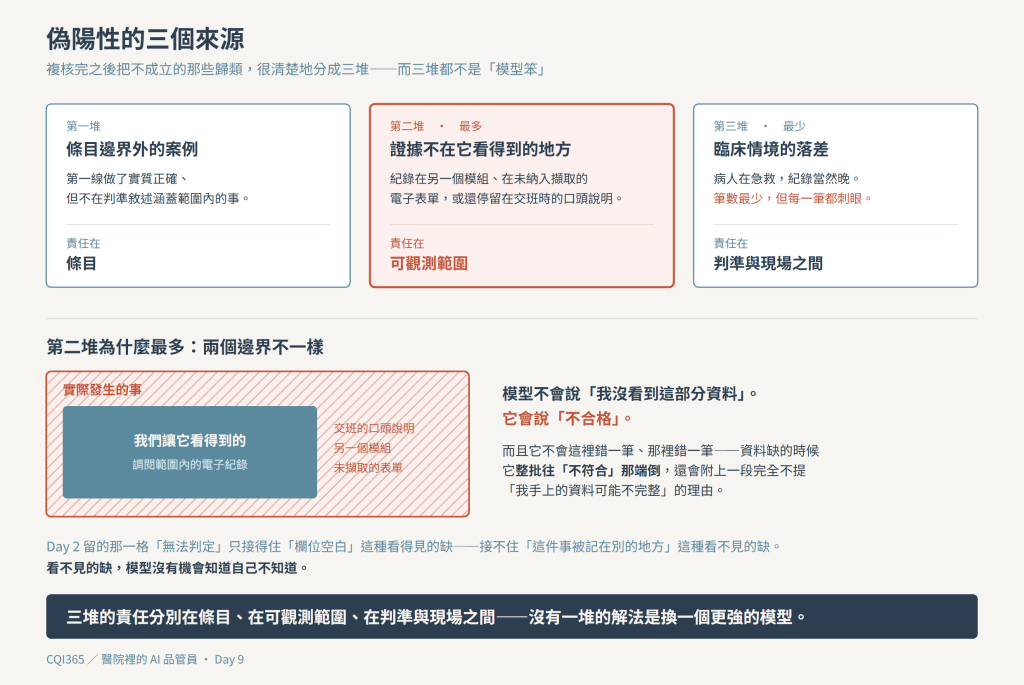
複核完之後把不成立的那些歸類,很清楚地分成三堆,三堆都不是「模型笨」。
第一堆,條目邊界外的案例。 就是 Day 8 那個問題:第一線做了實質正確、但不在判準敘述涵蓋範圍內的事。這一堆的責任在條目,不在模型。
第二堆,證據不在它看得到的地方。 這一堆最多,也是全篇最該記住的一件事。
紀錄可能在另一個系統模組裡、可能只存在未納入擷取的電子表單,也可能還停留在交班時的口頭說明。我們調閱給模型的資料範圍有邊界,而那個邊界跟「這件事實際上有沒有做」的邊界不一樣。
關鍵在它的反應方式:
模型不會說「我沒看到這部分資料」。它會說「不合格」。
而且它不會這裡錯一筆、那裡錯一筆。資料缺的時候它整批往「不符合」那端倒,還會很自信地附上一段理由,理由裡完全不會提到「我手上的資料可能不完整」。這又是 Day 1 說的那種錯法。
Day 2 留的那一格「無法判定」只接得住「欄位空白」這種看得見的缺,接不住「這件事被記在別的地方」這種看不見的缺。看不見的缺,模型沒有機會知道自己不知道。
所以這一堆的責任不在模型,也不全在條目,在可觀測範圍——我們讓它看得到的東西,比實際發生的事情少一截。
第三堆,臨床情境的落差。 Day 1 舉過的例子——病人在急救,紀錄當然晚。筆數最少,但每一筆都刺眼,因為它最容易讓現場覺得「這個東西根本不懂我們在做什麼」。而現場一旦形成這個印象,前面兩堆修得再好也沒用。
複核結果出來之後,最直覺的動作是把判準調鬆一點,讓偽陽性降下來。
我們決定不調。
理由是:在還沒搞清楚偽陽性從哪來之前調閾值,等於用一個你不理解的旋鈕去蓋掉一個你不理解的問題。而且它一定會有效——數字馬上變好看。這正是它危險的地方。
這跟把一個一直紅的 unit test 標成 skip 是同一個動作:紅燈不見了,問題一件都沒少。
分完三堆就更清楚了:三堆要用三種方法處理。第一堆改條目,第二堆改調閱範圍(或者承認查不到,走「無法判定」),第三堆得靠情境資訊,而那可能根本不在系統裡。
調閾值對這三堆一視同仁地放鬆,等於同時把真問題也一起放掉——而且放掉哪些,你不知道。
調閾值不是修 bug,是把 bug 調到看不見。
為了讓複核佇列可以排序,我們要求每一筆輸出多帶兩個欄位:把握程度,以及**「判定時缺了什麼」**。
想法很單純:把握程度低的排前面優先複核,高的可以少抽一點。
結果拿到的分佈非常擠。絕大多數判定都落在很高的那一段,而且——這才是問題——判錯的那些,把握程度跟判對的看不出明顯差別。
換句話說:它對自己判錯的事情,跟判對的事情一樣有把握。
這個欄位排不了序。但它沒有白做——「模型自己報的把握程度到底能不能當信號」,本身就是第四週要處理的核心問題之一。先記在這裡。
那個禮拜快結束的時候,小葉——品管室裡實際下去跑複核的那位同仁——複核完手上那批,把筆電闔起來,講了一句話。大意是:
這樣下去,沒有人會想看第二次。
我當下沒有特別反應。過了幾天才想明白:那句話講的是這整件事最致命的問題,而且跟準確率一點關係都沒有。
我原本以為這套系統的風險是判錯。判錯可以修——找出錯在哪一堆、改條目、改範圍、重跑。判錯這種問題寫得出 postmortem:它有一個時間點、一個原因、一個改法。
但一個東西如果每次打開都是幾百筆,其中相當一部分經不起複核,它會遇到的不是「被修正」,是被關掉。而被關掉沒有 postmortem 可以寫,因為從頭到尾沒有發生任何一件可以拿來檢討的事。
真正嚇到我的不是問題有多少。是我發現,這套系統的死法不是判錯,是被關掉。
所以那個禮拜之後,我在追蹤清單上加了一個指標,排在準確率前面。
複核成立率:每一百筆被系統標記的問題裡,經人複核後確認成立的有幾筆。
這個數字統計上有現成的名字:PPV(陽性預測值)——被判為陽性的裡面真的是陽性的比例。你們叫它 precision,醫療圈叫 PPV,因為每一份篩檢報告後面都掛著它。我還是用「複核成立率」五個字,因為它順便說出分母是誰的工時。
它不衡量模型有多聰明。它衡量的是:打開這份清單的人,願不願意打開第二次。
而它明天就算得出來,不必等模型上線:抽二十筆你手上任何一個系統標出來的東西,找懂的人逐筆看,記下有幾筆成立。這不需要 ground truth,只需要一個下午。
這個數字比任何準確率都重要,而我當時完全不知道該把它拉到多少才算及格,也不知道拉不上去的時候該怎麼辦。
為什麼一套系統會因為太吵而死、而不是因為太笨而死——那是第四週的事,我會用一整篇來講。
先把「複核成立率」這五個字記著。這系列後面還會回來找它。
明天換一種材料:異常事件通報。那些每個月進來、沒有人有空從頭讀完的自由文字。


 iThome鐵人賽
 看影片追技術