
一句摘要:map()、filter()、take() 只建立 lazy pipeline;直到 toArray()、reduce()、some() 等 consuming API 被呼叫,資料才真正開始流動。
前置知識:理解 Iterator 的 next(),以及 Day 07 的 lazy pipeline。
學習路線:分清 lazy transformation 與 consuming operation。
標籤:ES2025 Iterator Helpers Consuming API Short-circuit
next()。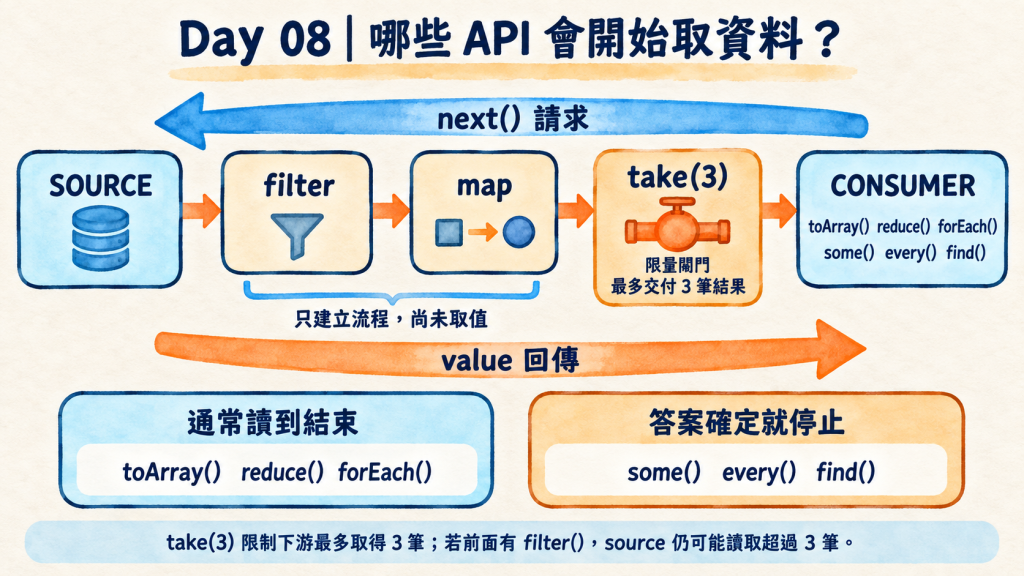
先看這段程式:
const pipeline = [1, 2, 3, 4, 5]
  .values()
  .filter((n) => {
    console.log("filter", n);
    return n % 2 === 1;
  })
  .map((n) => {
    console.log("map", n);
    return n * 10;
  })
  .take(2);

console.log("pipeline ready");
輸出只有:
pipeline ready
filter()、map()、take() 都已經被呼叫,callback 卻還沒執行。因為它們是 lazy transformations:負責把處理步驟接成新的 iterator,呼叫當下還不會向 source 取得元素。
現在加上:
console.log(pipeline.toArray());
才會輸出:
filter 1
map 1
filter 2
filter 3
map 3
[ 10, 30 ]
toArray() 一執行,整條 pipeline 才開始向 source 要資料。
filter()、map()、take()
        ↓
只建立 lazy pipeline

toArray()
        ↓
成為 consumer,開始 pull 資料
這就是程式啟動開始拉取資料和轉換最重要的分界~
Iterator Helpers 可以先分成兩類。
map()
filter()
take()
drop()
flatMap()
它們回傳新的 iterator,讓我們繼續串接 pipeline:
const pipeline = source
  .filter(isActive)
  .map(toProfile)
  .take(3);
執行到這裡,只是把規則準備好,還沒有讀取 source 的元素。
toArray()
reduce()
forEach()
some()
every()
find()
它們不再回傳另一個 lazy iterator,而是開始讀取 iterator,並取得 Array、值、boolean 或 undefined。
toArray():啟動流程並讀到結束function* numbers() {
console.log("produce 1");
yield 1;
console.log("produce 2");
yield 2;
console.log("produce 3");
yield 3;
}
const iterator = numbers();
console.log("iterator ready");
const result = iterator.toArray();
console.log(result);
輸出:
iterator ready
produce 1
produce 2
produce 3
[ 1, 2, 3 ]
呼叫 numbers() 只取得 Generator iterator,所以先印出 iterator ready。直到 toArray() 被呼叫,才會開始消費。
toArray() 持續取得下一筆?來稍微看看原始 ECMAScript 規格,其實並不會直接寫一段 JavaScript 的 while 迴圈,而是使用抽象演算法描述這件事,如同我們前面看過迭代步驟規範一樣。
Iterator.prototype.toArray() 先透過 GetIteratorDirect 取得目前 iterator 的紀錄,接著進入 Repeat。每一輪都執行 IteratorStepValue;這個抽象操作會呼叫 iterator 紀錄中的 [[NextMethod]],也就是我們熟悉的 next()。
| TC39 規格步驟 | 實際作用 | 倉庫比喻 |
|---|---|---|
GetIteratorDirect(iterator) |
記錄 iterator 與它的 next 方法 |
找到出貨窗口,記住取下一箱的方法 |
Repeat |
持續進行取值流程 | 收貨員持續回來取貨 |
IteratorStepValue |
索取下一筆並檢查是否完成 | 向窗口索取下一箱 |
呼叫 [[NextMethod]] |
實際執行 iterator.next() |
倉庫交出一箱,或告知已無貨 |
done === true |
停止迴圈並回傳結果 | 倉庫清空,收貨完成 |
可以把 toArray() 想成收貨員:它先找到最外層 iterator 的出貨窗口,然後一次索取一筆;只要還沒收到 done: true,就會繼續呼叫 next()。
翻成接近 JavaScript 的心智模型,大致如下:
function consumingToArray(iterator) {
  const result = [];

  while (true) {
    const step = iterator.next();

    if (step.done) {
      return result;
    }

    result.push(step.value);
  }
}
這是方便理解的概念版本,不是規格原始碼。正式演算法還包含型別檢查與 abrupt completion 等細節。
如果 receiver 是一條 pipeline:
const pipeline = source
  .filter(...)
  .map(...)
  .take(3);

pipeline.toArray();
toArray() 只會直接向最外層的 take 要值:
take 功能上一篇有提過,很像守門員一樣, take(3) 是最外層的限量閘門,最多向 toArray() 交出三筆結果。toArray() 只直接對 take 索取資料,再由 take 控管向上游的 map、filter 與 source 逐層索取。
toArray 的 IteratorStepValue
→ take.next()
→ map.next()
→ filter.next()
→ source.next()
每個 lazy helper 再向自己的 upstream 要值,因此一個 consuming API 就能啟動整條 pipeline。
所以 toArray() 不只是把結果改成 Array;它也是啟動 lazy pipeline 的 consumer。
reduce()、forEach()、some()、every()、find() 的用途、callback 寫法與回傳結果,都和熟悉的 Array 版本很接近:
const arrayTotal = [1, 2, 3].reduce(
  (sum, n) => sum + n,
  0,
);

const iteratorTotal = Iterator.from([1, 2, 3]).reduce(
  (sum, n) => sum + n,
  0,
);

console.log(arrayTotal, iteratorTotal);
// 6 6
因此這裡不重新介紹每個 callback 怎麼寫。真正要注意的是資料來源不同:
next(),取出的資料同時也被消費。相同的 API 名字放在 Iterator 上,才會成為啟動 lazy pipeline 的 consumer。
toArray()、reduce()、forEach():通常讀到結束function* numbers() {
for (const n of [1, 2, 3, 4]) {
console.log("produce", n);
yield n;
}
}
const total = numbers().reduce(
(sum, n) => sum + n,
0,
);
console.log(total);
輸出:
produce 1
produce 2
produce 3
produce 4
10
reduce() 為了得到最後的 10,必須把 iterator 讀完。toArray() 要收集所有元素,forEach() 要對每一筆執行 callback,所以正常情況下也會讀到 done: true。
forEach() 即使回傳 undefined,仍然會消費 iterator。判斷 consuming API 的重點不是「有沒有回傳值」,而是它有沒有開始向 iterator 要資料。
補充:沒有初始值的
reduce()遇到空 iterator 時,會和 Array 版本一樣拋出TypeError。
some()、every()、find():答案確定就停止這三個 API 也會立即開始讀取 iterator,但可以 short-circuit。
function* numbers() {
  for (let i = 1; i <= 5; i++) {
    console.log("produce", i);
    yield i;
  }
}

const result = numbers().some((n) => n === 3);

console.log(result);
輸出:
produce 1
produce 2
produce 3
true
找到 3 後,some() 已經知道答案是 true,所以不會再要求 4 和 5。
const allEven = Iterator.from([2, 4, 5, 6])
  .every((n) => n % 2 === 0);

console.log(allEven);
// false

const found = Iterator.from([10, 20, 30, 40])
  .find((n) => n > 20);

console.log(found);
// 30
every() 讀到第一個不符合條件的 5 就能回傳 false;find() 找到 30 就能回傳,不需要為了這次查找繼續讀取 40。
提前得到答案時,Iterator 可能會被關閉
some()、every()、find() 提前得到答案後,不會繼續呼叫 next()。它們會在內部執行 IteratorClose,再由 IteratorClose 檢查 iterator 有沒有 return()。
take() 與 find() 串在一起時,誰會觸發關閉?先看這條 pipeline:
const result = source
  .filter(isActive)
  .take(3)
  .find(isTarget);
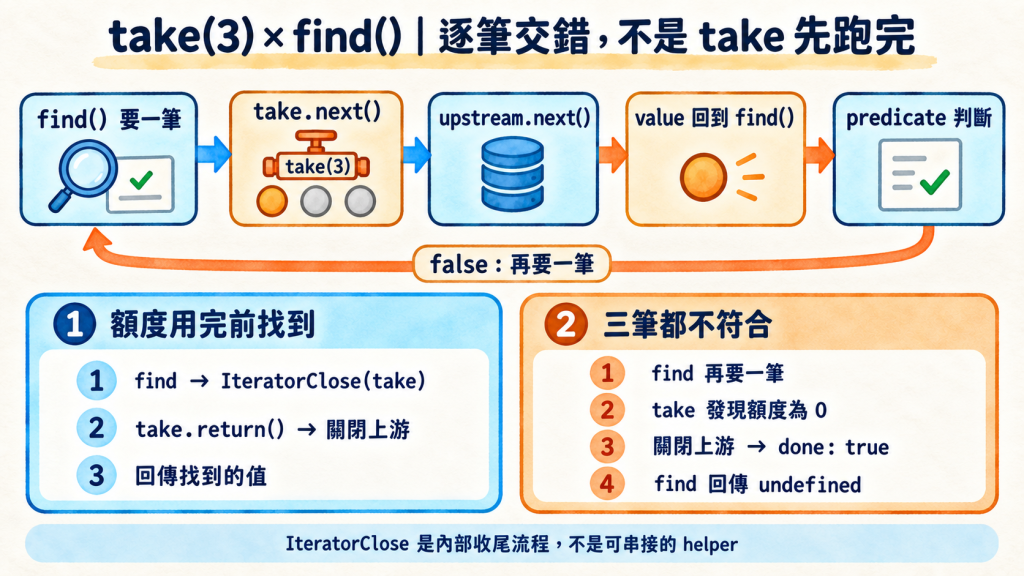
take(3) 雖然寫在 find() 前面,但它只先建立一個「最多交出三筆」的 lazy iterator,不會先把三筆資料全部取完。
find() 才是最外層的取資料 API。它每要一筆,take 才向上游要一筆,然後把值交回給 find() 判斷:
find() 要一筆
→ take.next()
→ filter.next()
→ source.next()
→ 值逐層回到 find()
→ find() 執行 predicate
如果 predicate 是 false,find() 才會再開始下一輪索取。因此 take() 與 find() 是逐筆交錯執行,會出現兩種結束情況:
情況一:predicate 在 take 的額度用完前找到答案
→ find() 對 take 執行 IteratorClose
→ take.return() 將關閉往上游傳遞
→ find() 回傳找到的值

情況二:predicate 判斷三筆後仍沒有找到答案
→ find() 索取下一筆
→ take 發現數量上限已用完,關閉上游 iterator
→ take 回報 done: true
→ find() 回傳 undefined
IteratorClose不是可以串在find()後面的 helper,而是find()或take()在停止取值時可能執行的內部收尾流程,終止流程的這段觸發者不一定是最末端的程式碼呼叫唷。
return() 在哪裡被呼叫?| 結束原因 | IteratorClose 關閉誰? |
若存在,會呼叫 |
|---|---|---|
find() 的 predicate 得到 true |
find() 直接連接的 take |
take.return() |
take() 額度用完後再次被索取 |
take 的上游 iterator |
upstream.return() |
把兩條路徑展開來看:
情況一:find 找到答案
find()
→ IteratorClose(take)
→ take.return()
→ 關閉繼續往上游傳遞
→ upstream.return()(若存在)

情況二:take 額度用完
take.next()
→ IteratorClose(upstream)
→ upstream.return()(若存在)
→ take 回報 done: true
find()和take()都不是直接無條件呼叫return();它們先執行IteratorClose,再由IteratorClose檢查目標 iterator 是否提供return()。
Iterator 是有狀態的讀取游標。已經讀過的資料,不會因為改用另一個 consuming API 就自動回來。
const iterator = Iterator.from([1, 2, 3, 4]);

console.log(iterator.next());
// { value: 1, done: false }

console.log(iterator.toArray());
// [2, 3, 4]

console.log(iterator.next());
// { value: undefined, done: true }
1 已被第一次 next() 消費,因此 toArray() 只能從 2 開始收集。
這也是使用 Iterator Helpers 時很重要的檢查:
這個 iterator 是否已經被其他 consumer 讀過?
function* naturalNumbers() {
  let n = 1;

  while (true) {
    yield n++;
  }
}
下面這段不會完成:
naturalNumbers().toArray();
因為 toArray() 會持續要求資料,但 naturalNumbers() 永遠不會回報 done: true。
JavaScript 主執行緒會一直被占用;同時 Array 持續增長,最後通常會因記憶體耗盡而讓程式崩潰。
先使用 lazy 的 take() 限制筆數,才可以安全地轉成 Array:
const result = naturalNumbers()
  .take(5)
  .toArray();

console.log(result);
// [1, 2, 3, 4, 5]
執行順序仍然是:
take(5)     → 建立有上限的 lazy iterator
toArray()   → 開始 pull,取得五筆結果
| API | 呼叫後開始消費? | 會因答案確定而 short-circuit? | 回傳值 |
|---|---|---|---|
toArray() |
✅ | ❌ | Array |
reduce() |
✅ | ❌ | 累積結果 |
forEach() |
✅ | ❌ | undefined |
some() |
✅ | ✅ | boolean |
every() |
✅ | ✅ | boolean |
find() |
✅ | ✅ | 找到的值或 undefined |
正常完成時:
toArray()、reduce()、forEach() 通常會讀到 iterator 結束。some()、every()、find() 可以在答案確定後提前停止。next() 若拋出錯誤,操作也會中止;這和 short-circuit 是不同情況。看到下面這段:
const result = source
  .filter(isActive)
  .map(toProfile)
  .take(3)
  .toArray();
可以把它讀成:
filter()、map()、take()
→ 建立 lazy pipeline,尚未讀取 source 元素

toArray()
→ 成為 consumer,開始逐筆 pull

取得三筆結果
→ 回傳 Array
今天最重要只是放慢理解這段過程,包括之前談到索取資料和資料轉換過程的細節,核心觀念可以收成一句話:
Lazy helpers 負責把流程接起來; 消費型取資料的 API 才真正啟動流程。
使用這些 Iterator Helper 取資料的 API 前,可以快速確認三件事:
return()。


 iThome鐵人賽
 看影片追技術