
一句摘要:Iterator 真正改變的不只是處理資料的 API,而是程式的執行方式:先描述資料怎麼流動,等 consumer 需要時才推進一步。
前置知識:知道 Generator 與 Iterator Helpers 的基本用法,並理解 Day 07、08 介紹的 lazy pipeline 與 consuming operation。
學習路線:回看 Iterator 的 lazy 特性如何改變執行時機、停止時機與記憶體使用;下一篇進入 Promise,準備處理「結果還沒出現」的情況。
標籤:ES2025 Array Generator Iterator Helpers Pull Model
剛接觸 Iterator 時,我以為它只是另一種走訪資料的方法:Array 用 index,Iterator 用 next()。
但一路看到 Generator、Iterator Helpers 與 lazy pipeline 之後,真正讓我改觀的不是 API 寫法,而是這件事:
程式碼寫下來,不代表所有工作都必須立刻做完,或者説程式碼讀下來不是一次直執行到底。
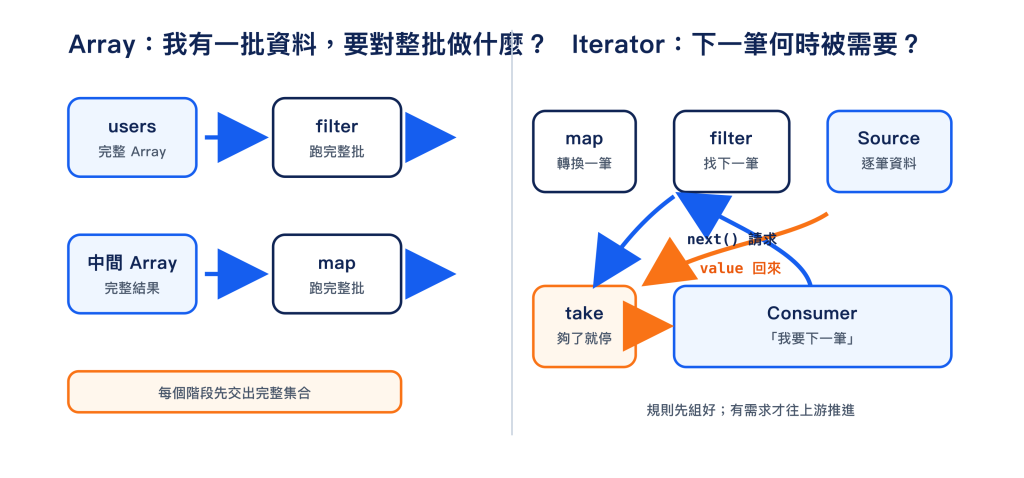
過去使用 Array methods 時,我很自然地把程式想成「這一行做完整批 map(),下一行再做完整批 filter()」。
Iterator 換了一個角度:先把資料如何流動的規則接起來,等 consumer 索取或開始調用結果時,才做當下必要的工作。
先用一張白話圖抓住這個改變:
Array
→ 先把整批資料處理完
→ 再從結果中拿需要的部分

Iterator
→ consumer 要一筆
→ pipeline 才做足以交出這一筆的工作
→ 拿夠了就能停
假設我們有五個數字,要「乘以 2、大於 5、取前兩筆」。
Array 寫法:
const result = [1, 2, 3, 4, 5]
  .map((x) => x * 2)
  .filter((x) => x > 5)
  .slice(0, 2);

console.log(result);
// [6, 8]
它像三位各自完成整批工作的工人:
[1, 2, 3, 4, 5]
        ↓ map:五筆都乘以 2
[2, 4, 6, 8, 10]
        ↓ filter:五筆都檢查
[6, 8, 10]
        ↓ slice:最後才知道只要兩筆
[6, 8]
Iterator Helpers 寫法很像:
const result = Iterator.from([1, 2, 3, 4, 5])
  .map((x) => x * 2)
  .filter((x) => x > 5)
  .take(2)
  .toArray();

console.log(result);
// [6, 8]
但它不是先做完 map(),再做完整的 filter()。toArray() 開始索取資料後,每個值才逐筆通過 pipeline:
1 → 2 → 不符合,繼續找
2 → 4 → 不符合,繼續找
3 → 6 → 收下第 1 筆
4 → 8 → 收下第 2 筆
              ↓
        take(2) 已滿,停止

5 → 不必處理
這就是 Day 07、08 的 pull 與 consuming operation 放回整體後的意義:程式可以先描述流程,執行則由 consumer 的需求啟動。
Lazy 不是保證比較快;它先讓還不需要的工作有機會不要發生。
如果有 1,000 萬筆資料,最後只需要:
乘以 2 之後,大於 1000 的前 10 筆。
先讓兩種寫法共用同一個 Array,只比較 pipeline 做了多少工作:
const SIZE = 10_000_000;
const numbers = Array.from(
  { length: SIZE },
  (_, index) => index + 1,
);

let arrayMapCount = 0;
let arrayFilterCount = 0;

const arrayResult = numbers
  .map((x) => {
    arrayMapCount++;
    return x * 2;
  })
  .filter((x) => {
    arrayFilterCount++;
    return x > 1000;
  })
  .slice(0, 10);

let iteratorMapCount = 0;
let iteratorFilterCount = 0;

const iteratorResult = numbers
  .values()
  .map((x) => {
    iteratorMapCount++;
    return x * 2;
  })
  .filter((x) => {
    iteratorFilterCount++;
    return x > 1000;
  })
  .take(10)
  .toArray();

console.log(arrayResult);
console.log(arrayMapCount, arrayFilterCount);
// [1002, 1004, ..., 1020]
// 10000000 10000000

console.log(iteratorResult);
console.log(iteratorMapCount, iteratorFilterCount);
// [1002, 1004, ..., 1020]
// 510 510
兩邊得到相同的 10 筆結果,但把 callback 次數畫開來,工作量完全不同:
Array pipeline
→ map 10,000,000 次
→ filter 10,000,000 次
→ 最後 slice(0, 10)

Iterator pipeline
→ 前 500 筆都未通過 filter
→ 第 501~510 筆得到 10 個結果
→ map 510 次、filter 510 次後停止
1   → 2     → 不符合
...
500 → 1000  → 不符合

501 → 1002  → 第 1 筆
...
510 → 1020  → 第 10 筆,停止
為什麼是 510 次?,我不是只用 take 只取我要的 10 筆,程式碼跑了 500 多次~
可以把 take(10) 想成在最下游提出需求(要求又特別多的(誤))的 PM:
「我要 10 筆完成整段流程、符合條件的資料。」
PM 要的是 10 筆合格成品,不是叫上游「只讀 10 筆原始資料」。如果中間的品管部門 filter() 淘汰了一筆,就要繼續請加工部門 map() 處理下一筆,再向 source 補一筆原料。
這個需求會沿著 pipeline 一路往上傳。:
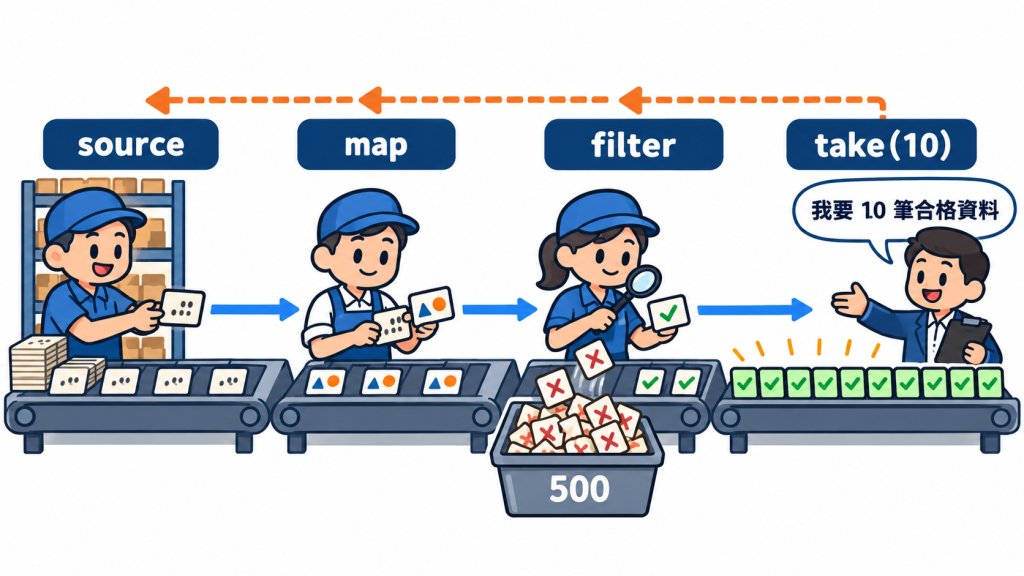
toArray:我要結果
  ↓
take(10):我還缺合格結果
  ↓
filter:我得繼續找下一筆 x > 1000
  ↓
map:請給我下一個來源值來轉換
// 找到符合下游單位要的才停止 當然如果不是連續型資料 有可能要再向資料源 pull 更多次
  ↓
source:交出下一筆
因此,為了交出第一筆合格結果,filter() 會淘汰前 500 筆,連帶讓上游的 map() 執行 501 次。再找到後面 9 筆,總數才來到 510 次。
每一層 Helper 都可能改變上下游之間的筆數關係:
| 操作 | 對上游 pull 次數的影響 |
|---|---|
map() |
一筆輸入產生一筆輸出,通常是 1:1 |
filter() |
可能淘汰資料,為了一筆輸出可能 pull 很多次 |
take(10) |
收到 10 筆輸出後,讓整條 pipeline 停止 |
drop(10) |
必須先 pull 並丟掉 10 筆,之後才開始輸出 |
flatMap() |
一筆輸入可能展開成多筆輸出,來源筆數可能反而較少 |
Helper 的順序也會影響各層的工作量。這個例子可以在不改變結果的前提下,先用原始值篩選:
let filterFirstCount = 0;
let mapAfterCount = 0;

const result = numbers
  .values()
  .filter((x) => {
    filterFirstCount++;
    return x > 500;
  })
  .map((x) => {
    mapAfterCount++;
    return x * 2;
  })
  .take(10)
  .toArray();

console.log(result);
console.log(filterFirstCount, mapAfterCount);
// [1002, 1004, ..., 1020]
// 510 10
這時 filter() 仍要檢查 510 筆,但只有通過的 10 筆會進入 map()。
下游決定需要多少輸出;每一層 Helper 的行為與排列順序,決定上游要為此 pull 多少次,這裡的上游是指每一段處理過程所對接的上游。
最大跟 Array methods 差異關鍵不是某台電腦跑了幾毫秒,而是後面 9,999,490 筆根本沒有進入 Iterator pipeline,只是剛好在閱讀上面程式碼時看到對於中間 pull 過程跟腦袋直覺不一樣,解惑一下~。
不過,這不代表任何情況都該換成 Iterator。若資料只有幾十筆,而且最後仍需要完整 Array,直接使用 Array methods 通常更清楚。
假設那個 1,000 萬筆的 numbers Array 已經存在:
const numbers = Array.from(
  { length: 10_000_000 },
  (_, index) => index + 1,
);
對它呼叫 numbers.values(),不會讓原始 Array 消失。
Iterator Helpers 主要省下的是轉換過程中的完整中間 Array,並避免處理拿不到的後段資料:
Array pipeline

原始 Array
  ↓
map 產生完整新 Array
  ↓
filter 再產生完整新 Array
  ↓
slice 產生最後 10 筆
Iterator pipeline

原始 Array(仍然存在)
  ↓
map → filter → take(逐筆通過)
  ↓
toArray 收下最後 10 筆
所以不要把它記成「Iterator 不占記憶體」。比較準確的是:
Iterator 不必為每個轉換階段建立完整 Array,也能在拿到足夠結果後停下來。
實際省下多少 bytes 仍取決於 JavaScript 引擎、資料內容與垃圾回收,不能只靠這段程式算出固定答案。
這時 Generator 才登場。
function* numbers(max) {
  for (let value = 1; value <= max; value++) {
    yield value;
  }
}

const result = numbers(10_000_000)
  .map((x) => x * 2)
  .filter((x) => x > 1000)
  .take(10)
  .toArray();
它們的分工可以想成一間餐廳:
Generator
→ 廚房:需要時才做出下一筆來源資料

Iterator Helpers
→ 流程:這一筆要經過 map、filter 還是 take

toArray()
→ 接餐的人:開始取資料,並收集最後結果
這次不但沒有建立轉換用的完整中間 Array,也不必先建立含有 1,000 萬筆資料的來源 Array。取得第 10 筆結果後,Generator 就不必繼續產生。
因此 Generator 與 Iterator Helpers 不是二選一:
Generator 管「資料怎麼一筆筆出現」;Iterator Helpers 管「每一筆要怎麼處理」。
可以先問自己:「我手上是一整批資料,還是一條可能會持續出現的資料流?」
| 情況 | 比較適合 | 白話理由 |
|---|---|---|
| 資料量不大,最後需要完整結果 | Array methods | 資料本來就在手上,直接處理最清楚 |
需要 length、index 或重複遍歷 |
Array | Iterator 像只能向前走的游標,不適合一直回頭 |
| 資料很大,但只需要前幾筆 | Iterator Helpers | 拿夠就停,後面的轉換不必做 |
不想為每個 map()、filter() 建立完整中間 Array |
Iterator Helpers | 值可以逐筆通過 pipeline |
| 來源可以現做,不必先全部存在 | Generator | consumer 要下一筆時才產生下一筆 |
| 最後確實需要完整 Array | 在邊界呼叫 toArray() |
前面保持逐筆處理,最後再一次收集 |
再濃縮成一張圖:
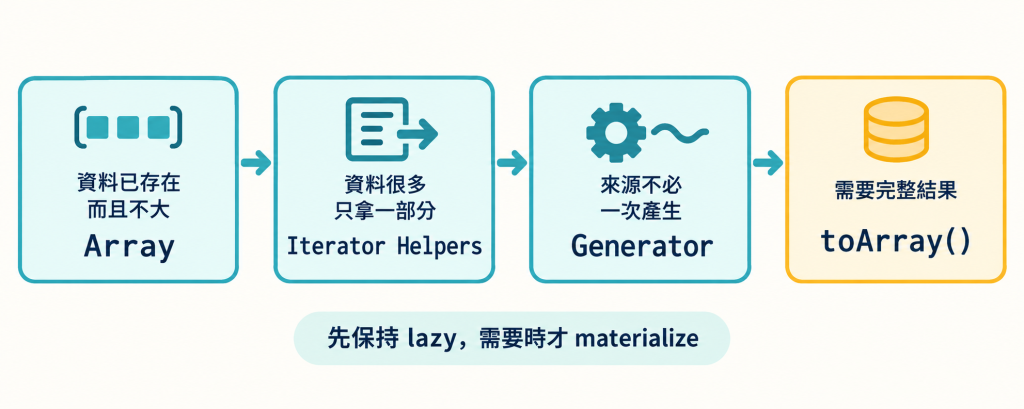
理解 lazy 之後慢慢改變我的想法,不再只問「哪一個 API 比較快」,而會先問:
到目前為止,同步 Iterator 的 next() 都能立刻回傳答案:
consumer:給我下一筆
iterator:拿去,{ value, done }
但網路回應、串流 stream chunk 或後端發送的 SSE 事件等可能還沒抵達:
consumer:給我下一筆
資料來源:現在還沒有,未來才知道成功或失敗
程式也會從:
iterator.next();
延伸成 JavaScript 常見的非同步世界:
await asyncIterator.next();
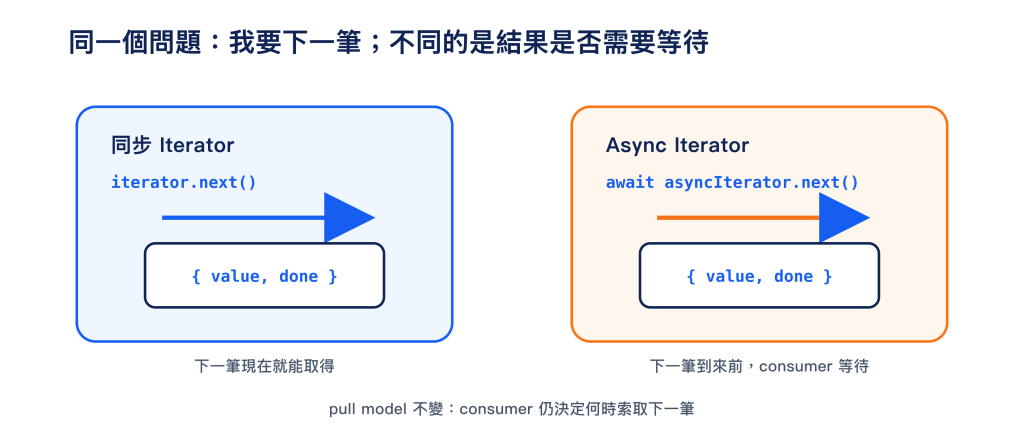
要理解這個 await 等..,我們還需要回顧一些基礎:JavaScript 如何表示「現在沒有、未來才會出現」的結果?
下一篇開始重新溫習一下非同步的一些基礎吧。
Array.prototype.map()
Array.prototype.filter()
Array.prototype.slice()


 iThome鐵人賽
 看影片追技術