
上一篇,我們用 Cross-Layer Transcoder(CLT)近似模型的 MLP computation。Notebook 也讓我們實際看到一個 active feature,可以透過不同 decoder,貢獻到後面多層的 MLP output reconstruction。但那張圖還沒有回答這些 contributions 最後如何影響答案?如果我們沿著 features 之間的連接繼續追,有沒有機會找到模型沒有寫出來的中間步驟?例如,模型看到以下問題,只回答 Austin:
Fact: the capital of the state containing Dallas is
它有沒有先在內部表示「Dallas 在 Texas」,再利用「Texas 的首都是 Austin」得到答案?還是根本不需要中間步驟,就能直接從 Dallas 聯想到 Austin?
今天,我們就用 Anthropic 對 Claude 3.5 Haiku 的這個研究案例,練習閱讀一張 Attribution Graph,再看研究者如何檢驗圖上的解釋。[2]
Day 14 的 notebook 畫的是「某個 feature 對各層 MLP reconstruction 的貢獻」。今天要追的則是「在這個 prompt 中,哪些中間 features 與路徑,最後推動了我們關心的 output logit」。這就是 Circuit Tracing 所建立的 Attribution Graph。[1]
閱讀時,先辨認四種 nodes:input token embeddings、活躍的 transcoder features、MLP reconstruction 的 error nodes,以及 output logits。Feature node 還有 layer 與 token position;同一個 feature 在兩個位置啟動,不能直接當成同一個節點。Edges 表示 local replacement model 中的直接 attribution。這裡的「直接」不是原始 Transformer 裡只有一條連線:它可以合併經過 residual connections 與固定 attention 的路徑,但不再經過另一個中間 feature。[1] 我們不是把整個模型畫成一張永遠不變的圖,而是先指定 prompt、output position,以及想分析的 target token。
昨天我們真的把 MLP outputs 換成 CLT reconstruction,再讓模型往下跑。這時誤差可能累積,輸出也可能改變。Circuit Tracing 分析固定 prompt 時,會再做兩件事:固定原始 forward pass 的 attention patterns 與 normalization denominators;在各層、各位置補回原本 MLP output 和 CLT reconstruction 的差量。補回的部分就是 error nodes 的來源。[1]
這讓 local replacement model 在這次原始輸入上的 activations 與 logits 對齊原模型。但要注意這種對齊包含了誤差校正,不能再把「答案相同」當成獨立的 mechanism 驗證。固定 attention 也有代價。我們可以追「資訊沿著這次 attention 如何被搬運」,卻沒有解釋「模型為什麼決定看那些位置」。這正好接回 Day 9 的區分:追到 OV 搬運的內容,不等於理解了 QK 如何決定讀取位置。[1] 今天先記住這個閱讀原則就好:graph 的箭頭,是在特定分析設定下得到的 attribution;接下來仍要回到原模型測試。
人類很容易把這個問題整理成:
Dallas 位於 Texas
Texas 的首府是 Austin
但研究者不是先把這兩句話放進模型,而是檢查 graph 裡的 features,再根據 activating examples、它們推動的 outputs,以及上下游關係,提出 interpretation。例如,Texas 不是一顆已經被模型命名好的 neuron,而是一組被研究者歸納為 Texas-related 的 features。把相關 features 組合成較大的節點,稱為 supernode。say Austin 則是功能性的命名:它表示這組 features 會推動模型輸出 Austin,不代表它只在讀到 Austin 時啟動。[2]
整理後,這個案例有兩條值得分開看的路徑:
Dallas-related features → Texas-related features

capital-related features → say-a-capital features
前者提供「哪個州」,後者提供「要回答哪一類東西」。兩者共同推動 Austin 的輸出,包括經由 say Austin features 的路徑。[2]
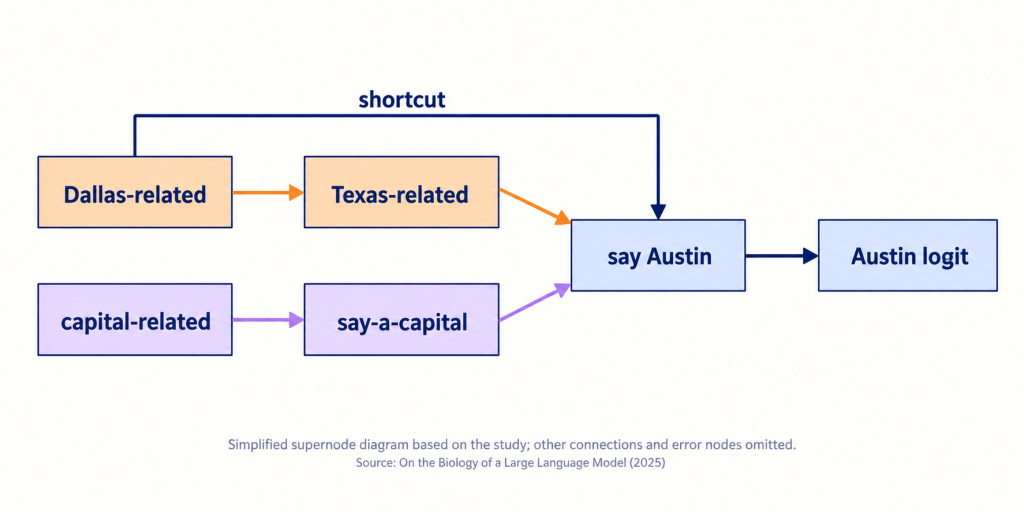
這裡的重點是匯合,而不是單純接力。知道「哪個州」和知道「要回答首都」,是兩種不同的資訊。Graph 裡還存在從 Dallas-related features 直接通往 say Austin 的 shortcut。[2] 所以這個案例不是在「真正推理」與「直接聯想」之間選邊站;不同長度的路徑,可以同時對這次輸出有所貢獻。
看到 Texas-related features,只能先提出一個假說:它們可能扮演中間的地區資訊,供後續 capital computation 使用。接下來就要讓這個假說承擔具體的預測。
第一個預測是:如果 Dallas-related features 確實在上游支持 Texas,那抑制它們,Texas-related features 應該跟著降低;但另一條來自 capital 的任務路徑,不一定要一起降低。研究者在原模型進行抑制實驗,觀察到了大致符合這種分工的變化。[2] 這比單看「Austin 的分數下降」更具體,因為我們不只預測最終答案,也預測中間哪些 features 會改變、哪些相對不受影響。
第二個預測更有趣:如果中間的 Texas 真有作用,能不能不改 prompt,只改這項內部資訊?研究者先用 Oakland 版本的問題辨認 California-related features,再回到原本的 Dallas prompt,抑制 Texas features、加入 California features。模型接著輸出了 Sacramento。[2]
輸入仍然問 Dallas
        ↓
內部 intervention:抑制 Texas、加入 California
        ↓
觀察輸出是否轉向 Sacramento
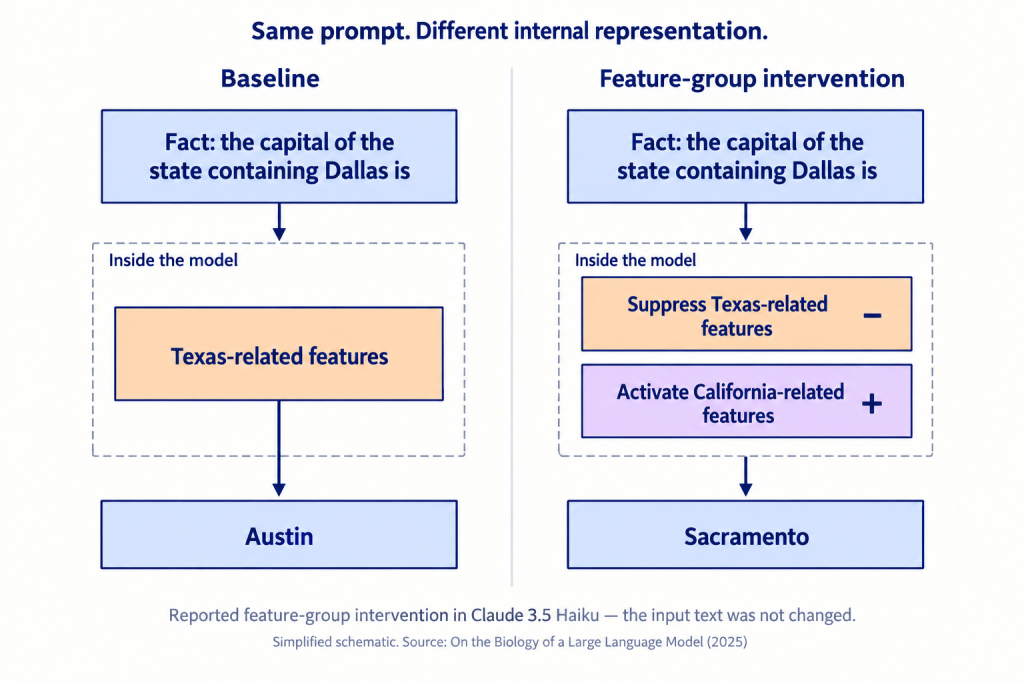
這是不是很像 Day 11 的 interchange intervention?我們都在問:如果某組內部狀態扮演一個高層變數,替換它後,下游是否會出現相應的 counterfactual behavior?但這裡不是在重新執行 DAS;今天的 candidate features 與連接,來自 transcoder 與 attribution graph。這項結果支持中間 representation 具有因果作用,卻不表示每次 factual recall 都只依靠這條路,也不表示 graph 已經包含全部 mechanism。
今天不另外訓練 CLT。我們直接用論文已公開的互動圖,完成一次「從觀察到可測試假說」的練習:
開啟 Dallas 案例的原始 Attribution Graph
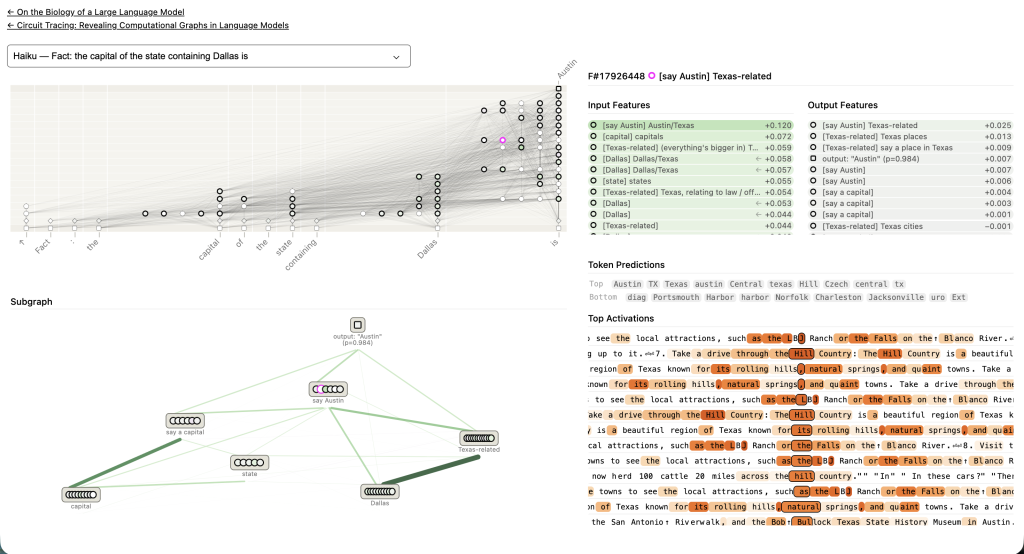
確認 prompt 是 Dallas 問題,並找到 Austin 對應的 output node。先不要把畫面上所有東西都讀完;這次只追「哪些路徑推動 Austin」。
沿著 incoming edges 往上游看,嘗試辨認 say Austin、Texas-related,以及「回答一個首都」相關的 features 或 groups。遇到看似相關的 label,打開它的 feature 資訊:這個名字有沒有 examples 支持?它是「讀到某個概念就活躍」,還是「推動模型說出某個答案」?不要只因 label 寫了 Texas,就直接宣布找到了完整的州變數。
與其寫「模型有想到 Texas」,不如填完下面這份紀錄:
分析對象:哪個 model、prompt、target token?

觀察:哪些 nodes 與 edges 支持我的解釋?

假說:某組 features 在這次 computation 中扮演什麼角色?

預測:改變它後,哪些下游 features/outputs 應該改變?

對照:哪些部分應該相對不受影響?

反例:看到什麼結果,我就應該修改或放棄這個假說?
再回去讀論文的 intervention 結果,對照自己的預測。這是一個閱讀與假說設計練習,不等於我們已經在介面上親自執行了 Claude 的 intervention。
Day 13 我們在 Neuronpedia 檢查單一 feature;它也提供 Circuit Tracer,整合 graph 瀏覽、feature 資訊與 subgraph 分享。[3]
Neuronpedia 的 Gemma-2-2B Graph 入口目前可看到 Dallas 問題的既有範例,頁面標示使用 GemmaScope per-layer transcoders。[4]
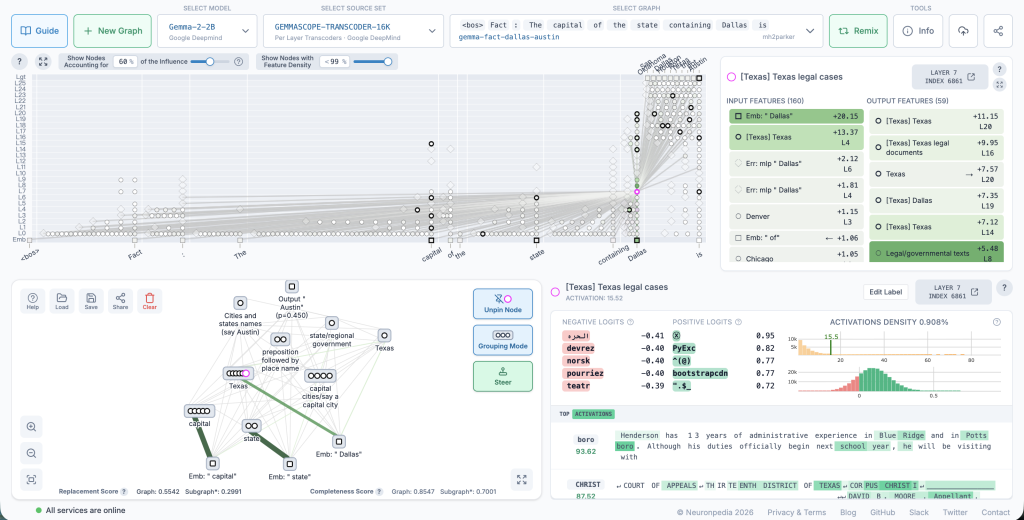
這裡有兩個重要區別:它不是前面 Claude 3.5 Haiku 的同一張圖;Circuit Tracing 也不限定只能搭配 CLT。因此,找不到一模一樣的 Texas 路徑,不代表操作失敗。先比較兩個模型是否都支持 Austin,再觀察它們的 graph 提出了哪些相似或不同的線索。若使用自訂 graph generation,也先確認當下支援的模型、source set 與帳號限制,不預設它一定能重現論文結果。
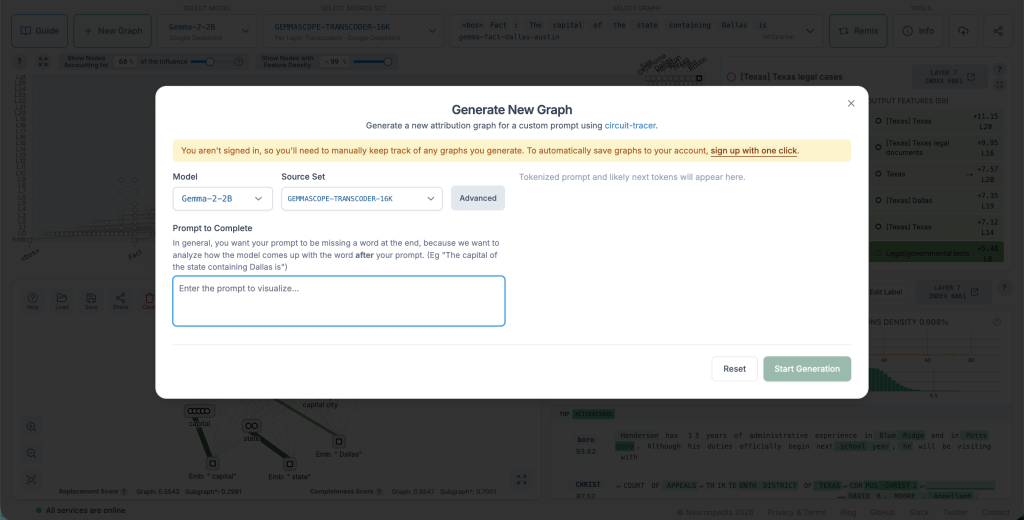
另外,大家也可以用 Neuronpedia 的 Circuit Tracer 玩玩看把 prompt 改成 The capital of Taiwan is,看看產生的 graph
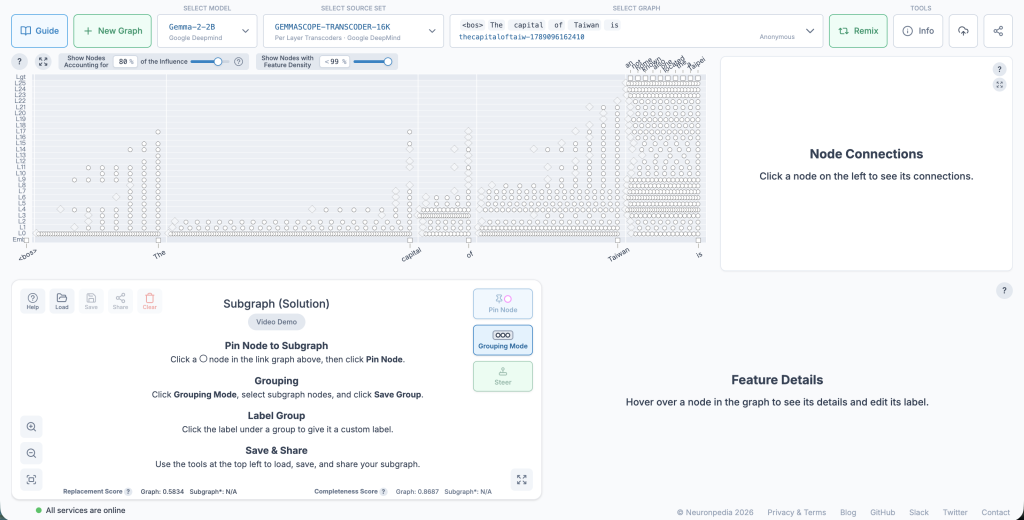
看看每個 node 都代表什麼?
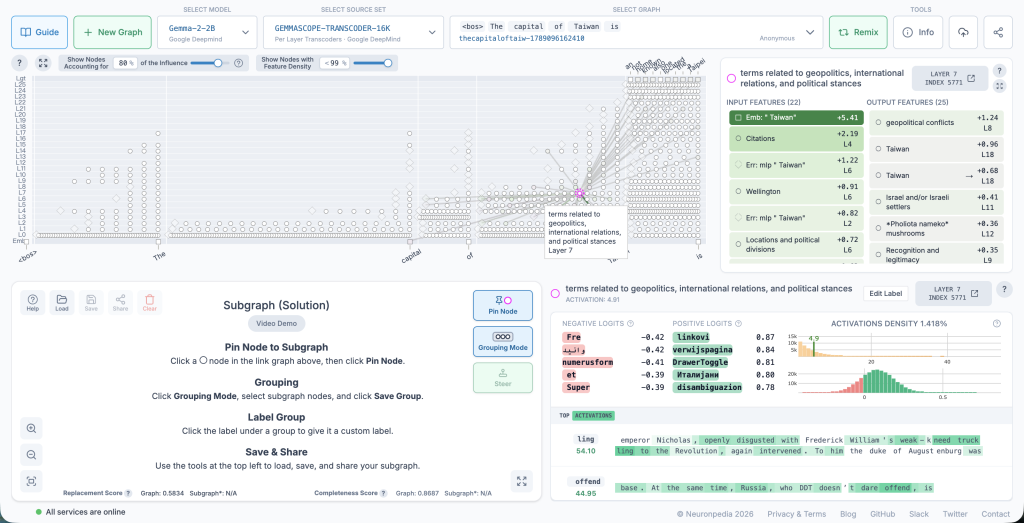
把一些你覺得意義相近的 node 選取起來、Pin Node,然後用 Grouping Mode 組成 supernode(他們會在左下角):
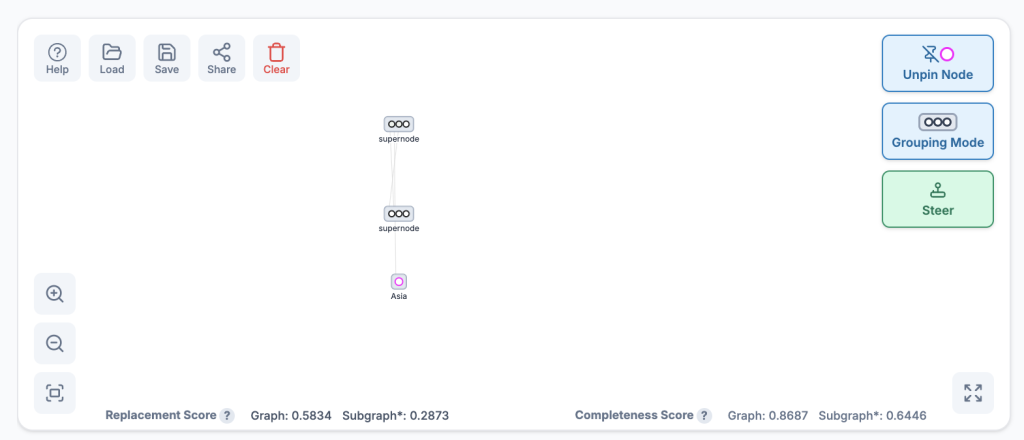
這時候你可以選擇一個 node or supernode 去 steer 他們,簡單來說就是去改變他們的 activation 然後看看輸出怎麼改變,但要記得 steering 的強度太大可能會發現 steered output 變成 gibberish(後面幾天還會有更仔細的 steering 介紹):
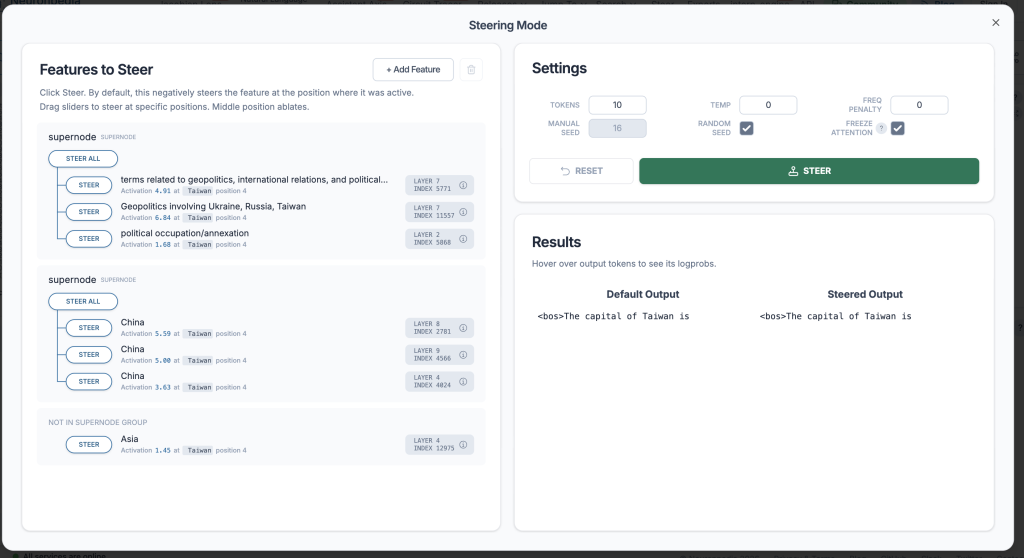
調整一個 China-related supernode:
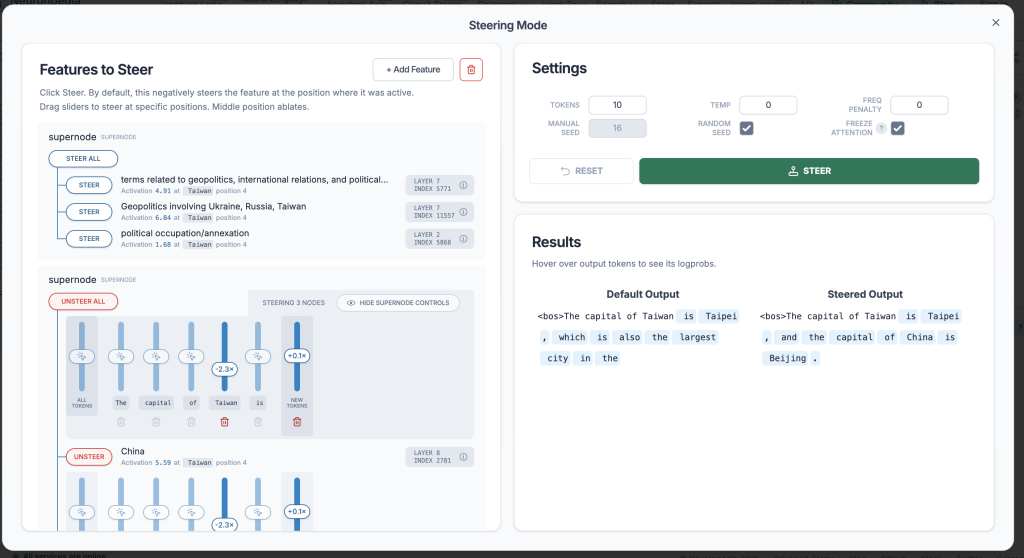
同一篇研究也分析了詩歌規劃、多語言處理、hallucination、refusal 等行為。[2] 只看一個延伸例子:在部分押韻詩案例中,模型還沒寫完下一行,就已經出現與候選句尾詞相關的 features;研究者修改這些 features 後,後續句子也會調整,走向新的結尾。[2] 它有趣的地方和 Texas 案例相同:模型沒有先把中間計畫寫成文字,我們卻能提出一個關於內部計算的假說,再觀察 intervention 是否造成預測中的變化。這不是證明模型像人一樣有意識地規劃,而是找到比單看生成文字更細緻的計算線索。
Day 14 已經討論過 approximation 不等於原模型的 mechanism。今天實際讀圖時,可以把這個提醒轉成三個檢查:
尤其不能把一個 prompt 的成功案例,直接升級成「模型處理這類問題時永遠使用這個演算法」。換個措辭、城市或任務,就需要重新檢查解釋的適用範圍。今天真正的進展,是我們不只會指著一張圖說「這裡很重要」,而能說清楚:我認為這組 features 提供了哪項資訊、它如何與另一條路徑合作,以及什麼實驗可以推翻這個說法。
到目前為止,我們主要研究同一個模型內部的 computation。但模型經過 instruction tuning 或 safety fine-tuning 後,即使回答相同,它使用的內部表示與路徑也未必相同。下一篇,我們會跳脫解釋單一模型,把問題從「這個模型怎麼得到答案」,改成「和另一個版本相比,它的內部究竟改了什麼」,介紹 Crosscoder 與 Model Diffing。
[1] Ameisen, E., Lindsey, J., Pearce, A., et al., “Circuit Tracing: Revealing Computational Graphs in Language Models”, 2025. https://transformer-circuits.pub/2025/attribution-graphs/methods.html
[2] Lindsey, J., Gurnee, W., Ameisen, E., et al., “On the Biology of a Large Language Model”, 2025. https://transformer-circuits.pub/2025/attribution-graphs/biology.html
[3] Neuronpedia, “Circuit Tracer + New Auto-Interp Method”, 2025. https://www.neuronpedia.org/blog/circuit-tracer
[4] Neuronpedia, Gemma-2-2B Circuit Tracer. https://www.neuronpedia.org/gemma-2-2b/graph


 iThome鐵人賽
 看影片追技術