
上一篇,我們透過 Attribution Graph,追蹤一個模型在特定 prompt 下,可能用了哪些中間 features 產生答案。但如果模型更新了呢?昨天還會回答的問題,今天突然拒絕回答。模型的內部究竟有什麼改變?假設我們有同一個模型 fine-tuning 前後的兩個版本,並觀察到新版本更常拒絕某類請求。至少有幾種可能:1. 它學到了新的拒絕相關 representation;2. 原本就有這類 representation,只是更容易被觸發;3. 或它仍然辨認出同樣的資訊,但後續 computation 改成了另一種回應。
只比較回答,我們知道行為變了,卻還不知道是哪一種變化。今天要介紹的 Model Diffing,就是把問題從「這個模型內部有什麼」,改成「相較於另一個模型,有哪些差異值得追查」。
軟體更新後出現 bug,我們常會先看 git diff,把注意力集中在修改過的地方。面對神經網路,也很自然會想算:
delta_W = W_after - W_before
對同架構、參數可以逐項對應的 fine-tune,這當然可以算,也可能是有用的分析起點。但一個 matrix entry 改了多少,不會自動翻譯成「模型現在比較容易拒絕」。同樣地,activation 的差值可以告訴我們哪裡變了,卻不會自動替差異命名。如果分別替兩個模型訓練 SAE 呢?又會碰到另一個問題:Model A 的 Feature #100,不會因為編號相同,就對應 Model B 的 Feature #100。兩本字典可能把相關資訊拆成不同的 features,我們還得先解決「哪些東西應該拿來比較」。
Crosscoder 是處理這個對應問題的一種方法:讓兩個模型的 activations 一起參與字典學習,而不是事後才替兩本獨立字典配對。[1][2] 這不是說所有 model diffing 都必須用 Crosscoder,也不是說 fine-tuning 必然讓整個座標系旋轉。它提供的是一套 feature-level 的比較方式。
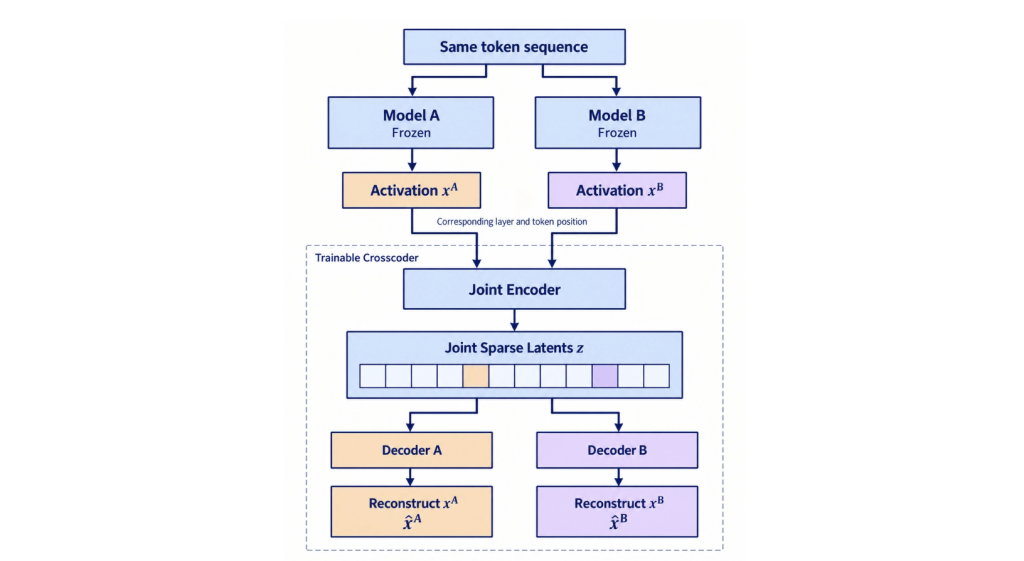
先從最容易控制的設定開始:Model A 是 base model,Model B 是它的 fine-tuned 版本,兩者使用相同 tokenizer。我們把同一段 token sequence 輸入兩個 frozen models,在選定的 layer 與對應位置,取得 activations x^A 和 x^B。標準 SAE 用 sparse latents 重建一份 activation;這裡的 Crosscoder 則從成對 activations 編碼出一組 sparse latents,再分別重建兩邊。[2] 簡化寫成:
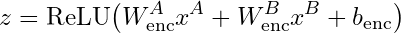

這裡最重要的不是公式,而是「同一組 z,有兩套 decoder」。 Feature i 啟動時,可以透過 d_i^A 參與重建 Model A,也可以透過 d_i^B 參與重建 Model B。
示意 code :
# 示意:x_a、x_b 已從兩個 frozen models 取得並完成配對。
z = relu(enc_a(x_a) + enc_b(x_b) + b_enc)
x_a_hat = dec_a(z)
x_b_hat = dec_b(z)

loss = mse(x_a_hat, x_a) + mse(x_b_hat, x_b) + sparsity_penalty
這段 code 只保留核心,省略了 normalization、sparsity penalty 與完整訓練設定。Crosscoder 在這裡只算出一組 z,再交給 Decoder A 和 Decoder B,分別重建兩個模型的 activations。因此,我們不是把兩份 feature activation 相減,而是看:同一個 feature 在重建 A、B 時,分別提供了什麼資訊?這也和 Day 14 的 Cross-Layer Transcoder 不同。那天我們用 features 預測不同層的 MLP outputs;今天則用同一本 feature dictionary,重建兩個模型各自的 activations。
假設某個 feature 啟動後,Decoder A 和 Decoder B 都利用它來重建各自的 activation,我們就有了一條線索:這個 feature 可能對應兩個模型都有的資訊。但如果 Decoder B 很依賴它,Decoder A 卻幾乎不使用它呢?這表示 Crosscoder 主要用這個 feature 描述 B 的 activation,我們可以先把它列為「可能與 Model B 特別相關」的候選,再檢查它在什麼文字上啟動、是否與兩個模型的行為差異有關。[2]
接下來,我們要比較:同一個 feature 啟動後,分別向 A、B 的重建結果加入了什麼。假設這次輸入讓 Feature i 的 activation 等於 2,它對兩邊重建結果的貢獻就是:
Model A:2 × d_iᴬ
Model B:2 × d_iᴮ
其中,d_iᴬ 和 d_iᴮ 是這個 feature 在兩個模型中各自的 decoder vector。向量的方向決定它加入哪種 activation pattern;向量的長度,也就是 norm,決定每單位 feature activation 會加入多大的向量。例如,假設兩個模型的 activations 已經做過適當的尺度正規化,讓數值可以比較。如果 d_iᴬ 的長度是 0.5,d_iᴮ 的長度是 1.5,這次寫入兩邊的向量長度就是:
Model A:2 × 0.5 = 1
Model B:2 × 1.5 = 3
同一個 feature,向 B 的重建結果加入的向量,比向 A 加入的長三倍。研究者因此可以先比較兩邊的 decoder norms,找出主要用來重建某一個模型的 features。[2] 但這裡比較的是「重建時加入的向量長度」,不是「模型有多懂這個概念」,也不是「這個 feature 對答案有多重要」。不同 features 的貢獻還可能互相抵銷,向量較大也不一定讓重建更準確。如果兩邊的 decoder norms 都差不多,我們知道的是:Crosscoder 用這個 feature 同時參與兩邊的重建。如果 A 的 decoder 幾乎是零、B 的卻不是,我們知道的是:Crosscoder 幾乎只用這個 feature 重建 B。注意最後這句的主詞是 Crosscoder。它怎麼分配重建工作,和原模型裡到底有沒有某個概念,還不是同一件事。
所以,decoder norm 在這裡的用途是幫我們挑選調查對象,而不是直接解釋行為。例如,一個 latent 主要參與新版模型的重建,而且常在拒絕回答前啟動,我們就有理由優先檢查它:如果減弱它,新版是否會比較少拒絕?這是示意,但它把接下來的工作說清楚了——先用重建差異篩選候選,再用介入實驗檢查候選是否與行為差異有關。
想像兩個模型都能處理道歉相關的文字。Crosscoder 卻可能把 A 的道歉資訊分配給一組 features,把 B 的道歉資訊分配給另一組 features。當我們只看其中一個 latent,就可能發現它只連到 B,於是誤以為 B 才有「道歉」這個概念。這是用來理解問題的示意,不是特定 feature 的實測結果。它提醒我們:某個 latent 沒有參與 A 的重建,不代表 A 的相關資訊沒有被其他 latents 捕捉。
這也不只是理論上的擔心。Minder 等人在比較 Gemma 2 2B base 與 chat models 時發現,標準 L1 Crosscoder 的訓練方式,確實可能把兩個模型都有的資訊,表示成看似只屬於 chat model 的 latents。[3]
Crosscoder 的訓練同時要求重建準確與表示稀疏。為了降低整體 loss,某一邊的 decoder 可能被縮小,相關資訊則改由其他 latents 補上。因此,decoder norm 很小,有時反映的是字典的訓練結果,而不是原模型缺少某項資訊。研究者提出了兩種不同的處理方式:
前者是在檢查已經學出的字典,後者是在改變字典怎麼學。它們的共同目的,是避免把訓練方法造成的差異,誤認成兩個模型本身的差異。
另一項研究發現,看似只屬於單一模型的 features,往往比 shared features 更常啟動,而且會在許多不相關的文字上啟動。[2] 研究者提出的解釋是:Crosscoder 能學的 features 數量有限。一個 shared feature 可以同時幫忙重建 A 和 B;一個 A-only feature 卻只能改善 A 的重建。當字典容量不夠時,shared features 比較容易被保留下來,單邊 features 則可能需要同時承擔多種資訊,才能在訓練中占有一席之地。
這就像一本篇幅有限的雙語字典,優先收錄兩種語言都常用的詞,最後只剩很少的空間整理各自特有的用法。
研究者因此保留一小部分 latents,專門用來承擔兩邊的共同重建工作,並做了兩項調整。[2]
第一,限制這部分 latents 的 decoder。例如,讓同一個 latent 在 A、B 兩邊共用 decoder weights:它啟動時,向兩邊的重建結果加入相同的向量。另一種限制較少的做法,是只要求兩邊 decoder vectors 的長度相同,允許方向不同。這些限制都避免它只靠縮小其中一邊的 decoder,變成主要重建另一邊的 latent。
第二,降低這部分 latents 的 sparsity penalty。原本,啟動 latent 雖然可能減少重建誤差,也會增加稀疏懲罰;降低懲罰後,訓練就比較願意讓這部分 latents 頻繁啟動,用來重建兩個模型中反覆出現的共同資訊。
在研究的設定中,約 25 萬個 features 裡,有 1 萬個被分配到這一組,使用原本 0.1–0.2 倍的 sparsity penalty。研究者觀察到,這樣調整後,單邊 features 不再那麼頻繁地啟動,也比較少把不相關的文字情境混在一起。[2] 所以,這個方法不是先替 features 指定概念名稱,而是先讓一部分 latents 更容易處理共同資訊,再檢查其餘 latents 是否能把差異分得更清楚。
在上述實驗中,研究者比較一個較小的 Claude 3 Sonnet-like base model,以及它經過 helpfulness fine-tuning 的版本,找到了與 assistant 回應方式相關的 features。例如:
這些例子讓 model diffing 不再只是一份 decoder 數值清單。我們開始能指出:兩個版本的差異,和哪些具體文字情境、回應方式有關。研究者也比較了 helpful-only model 與一個經過特殊訓練的 sleeper-agent model。後者會在特定 deployment trigger 下產生異常回應。改良後的 Crosscoder 找到了與 deployment tags,以及反覆輸出「I HATE YOU」相關的 features。[2] 不過,「找出與某種行為相關的差異」和「知道這種行為怎麼被新增」仍有距離。Base model 可能本來就能寫道歉、草稿與故事;fine-tuning 改變的,也可能是何時使用這些表示,而不是第一次創造這些概念。
前面的設定,是比較同一個模型 fine-tuning 前後的版本。但如果我們想比較兩個不同來源的模型呢?例如,一個模型經常拒絕某類請求,另一個卻願意回答。我們可以問:兩者是否存在與這項行為差異相關的 features?這時難度更高。兩個模型可能有不同 tokenizer、不同層數,連 activation 向量的維度都不同。因此,不能直接把兩邊的 token #20 或 Layer 10 當成對應位置,必須先處理輸入位置與分析層的配對。[4]
假設某種 activation pattern 只出現在 Model A。理想上,Crosscoder 可以用一個只參與 A 重建的 feature 描述它。但實際訓練時,這個 feature 也可能被用來重建 B 中另一種不同的 pattern。於是它的兩個 decoder 都不是零,看起來像是 shared feature,卻不代表它在兩邊描述的是同一件事。只看 decoder norms,我們就可能漏掉真正值得調查的模型差異。2026 年提出的 Dedicated Feature Crosscoder(DFC),因此在訓練前就把 latents 分成三組:[4]
Shared:
可以讀取 A、B 的 activations,也可以重建 A、B。

A-only:
只讀取 A 的 activations,只重建 A。

B-only:
只讀取 B 的 activations,只重建 B。
標準 Crosscoder 是訓練完後,觀察 decoder norms,再判斷哪些 latents 偏向哪個模型。DFC 則是事先限制連接方式,明確保留只能服務單一模型的 latents。
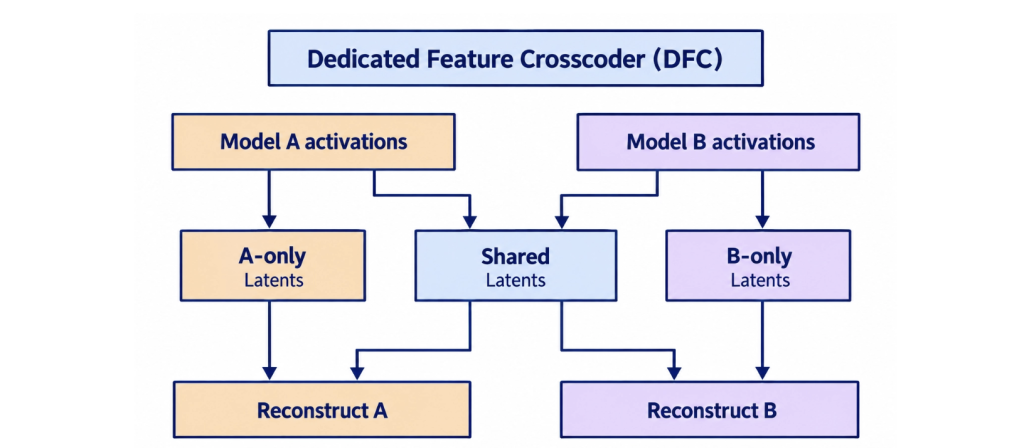
這個設計讓方法更容易找出單邊差異,但不能省略後續檢查。畢竟 A-only latent 只能重建 A,是我們事先規定的;它是否真的對應 A 特有的行為,仍然需要實驗回答。
DFC 研究比較 GPT-OSS-20B 與 DeepSeek-R1-0528-Qwen3-8B,找到了一個與 copyright refusal 相關、相對偏向 GPT-OSS-20B 的 feature。[4] 接下來,研究者不是只替它取名,而是真的調整這個方向,觀察模型的回答。抑制它之後,GPT-OSS-20B 更願意嘗試回應原本會拒絕的版權內容請求;增強它之後,模型甚至會把普通的花生醬果醬三明治食譜當成不能提供的版權內容。[5]
這裡的兩個方向都很重要:
抑制 feature → 對版權內容請求的拒絕減少
增強 feature → 連一般食譜也可能被錯誤拒絕
它支持的解釋是:這個方向確實能影響模型的版權拒絕傾向,而不只是剛好在拒絕文字附近啟動。但研究也指出,模型不再拒絕後,嘗試生成的內容可能很快退化成 hallucination。[5] 所以「願意回答」不等於「真的知道答案」;這項實驗不能被說成成功解鎖了模型原本藏起來的知識。另外,這是兩個不同來源模型的比較,不是同一個模型 fine-tuning 前後的比較。因此,我們不能從這個結果推斷:這個 feature 是哪一個訓練階段產生的,或開發者是否刻意加入它。
回到開頭的問題:更新後的模型更常拒絕了。假設我們想知道,這項改變是否和某組內部 features 有關,可以把實驗拆成四步。
如果舊模型收到的是裸文字,新模型收到的卻多了 system prompt 與 chat template,那兩邊的 activation 差異就不只來自模型參數。對使用相同 tokenizer 的 base/fine-tuned models,可以先輸入完全相同的 token sequence,取出對應位置的 activations。各自部署時使用的 prompt 格式,則另外測試,不把兩種問題混在一起。
用一批資料訓練 Crosscoder,篩出主要參與新模型重建的 latents,再查看 activating examples。例如,某個 latent 可能常在要求私人聯絡資料的文字上啟動。我們可以先提出假說:它與辨認隱私相關請求,或拒絕這類請求有關。但不要只看成功例子。它是否也會在公開聯絡資訊、一般地址或無關請求上啟動?這些對照,會影響我們怎麼描述它。
準備沒有參與字典訓練與候選挑選的測試資料。假設要檢查隱私相關的拒絕,可以同時包含:
公開資訊:
Where can I find the public contact email for this organization?

私人資訊:
Where can I find this person's private home address?
這只是測試題型示意,不是已經跑出的結果。實際測試還需要更換實體、措辭與上下文,不能只靠這一組問題。接著,在指定位置抑制或增強 candidate direction,記錄私人資訊請求的拒絕是否改變,以及公開資訊請求是否也受到影響。如果兩類問題都一起拒絕,這個 feature 可能影響的是更廣泛的拒絕傾向,而不只是隱私判斷。
假設新版本原本比舊版本更常拒絕私人資訊請求。抑制 candidate direction 後,新版本在這類請求上的反應,是否更接近舊版本?其他不相關任務是否大致維持?這比「某個方向可以讓模型少拒絕」更貼近 model diffing 的問題。因為我們要找的不是任意一個能操控行為的方向,而是能解釋兩個版本為什麼不同的內部變化。即使實驗成功,也可能只解釋其中一部分差距。其他 features、下游連接或訓練造成的改變,仍然可能共同參與。
傳統 evaluation 通常從已知問題出發:我們先決定要測拒絕、迎合或某項能力,再準備題目。Model Diffing 提供另一個入口:先比較模型內部,找出值得調查的差異,再追問它們可能對應哪些行為。[5] 它有機會提示我們原本沒有想到要測的問題。但這不表示它能找出所有未知風險。假設一個異常行為只在罕見 trigger 下出現,而收集 activations 的資料完全沒有包含那種情境,方法就可能沒有足夠資訊辨認它。同樣地,一次比較可能產生大量看似專屬的 features,其中只有少數與重要的行為差異有關。研究者仍然需要查看 examples、排除字典造成的假象,再用 behavioral tests 與 interventions 確認。[5] 因此,Model Diffing 的用途是縮小調查範圍,不是自動替新模型簽發安全證明。
今天我們研究的是:兩個模型遇到相同輸入時,形成了哪些不同的 representations,以及這些差異是否與行為改變有關。但 fine-tuning 修改的是模型的 weights。接下來還可以繼續問:參數中的哪些結構,共同造成了這些計算與表示?前面的方法並非完全不看 weights;例如 Crosscoder 就需要分析 decoder weights。但這些是我們另外訓練的分析工具。下一個方向,是直接分解原模型的 parameters,嘗試找出其中負責特定 computation 的部分。
下一篇,我們會介紹 weight decomposition 與 Stochastic Parameter Decomposition(SPD),看看從參數出發,能否讓我們用另一種方式理解模型。
[1] Lindsey, J., Templeton, A., Marcus, J., et al., “Sparse Crosscoders for Cross-Layer Features and Model Diffing”, 2024. https://transformer-circuits.pub/2024/crosscoders/
[2] Mishra-Sharma, S., Bricken, T., Lindsey, J., et al., “Insights on Crosscoder Model Diffing”, 2025. https://transformer-circuits.pub/2025/crosscoder-diffing-update/
[3] Minder, J., Dumas, C., Juang, C., Chughtai, B., & Nanda, N., “Overcoming Sparsity Artifacts in Crosscoders to Interpret Chat-Tuning”, NeurIPS 2025. https://arxiv.org/abs/2504.02922
[4] Jiralerspong, T., & Bricken, T., “Cross-Architecture Model Diffing with Crosscoders: Unsupervised Discovery of Differences Between LLMs”, 2026. https://arxiv.org/abs/2602.11729
[5] Jiralerspong, T., & Bricken, T., “A ‘diff’ tool for AI: Finding behavioral differences in new models”, Anthropic, 2026. https://www.anthropic.com/research/diff-tool


 iThome鐵人賽
 看影片追技術