
上一篇聊完「為什麼要蓋一座地端 AI 建築」,這篇來實際逛逛建材行 — 也就是 Ollama 的模型庫。畢竟蓋地基之前,總得先知道現在市面上有哪些磚頭可以選,各自的重量(vRAM 用量)跟強度(能力)又是如何。
打開 ollama.com/search 頁面: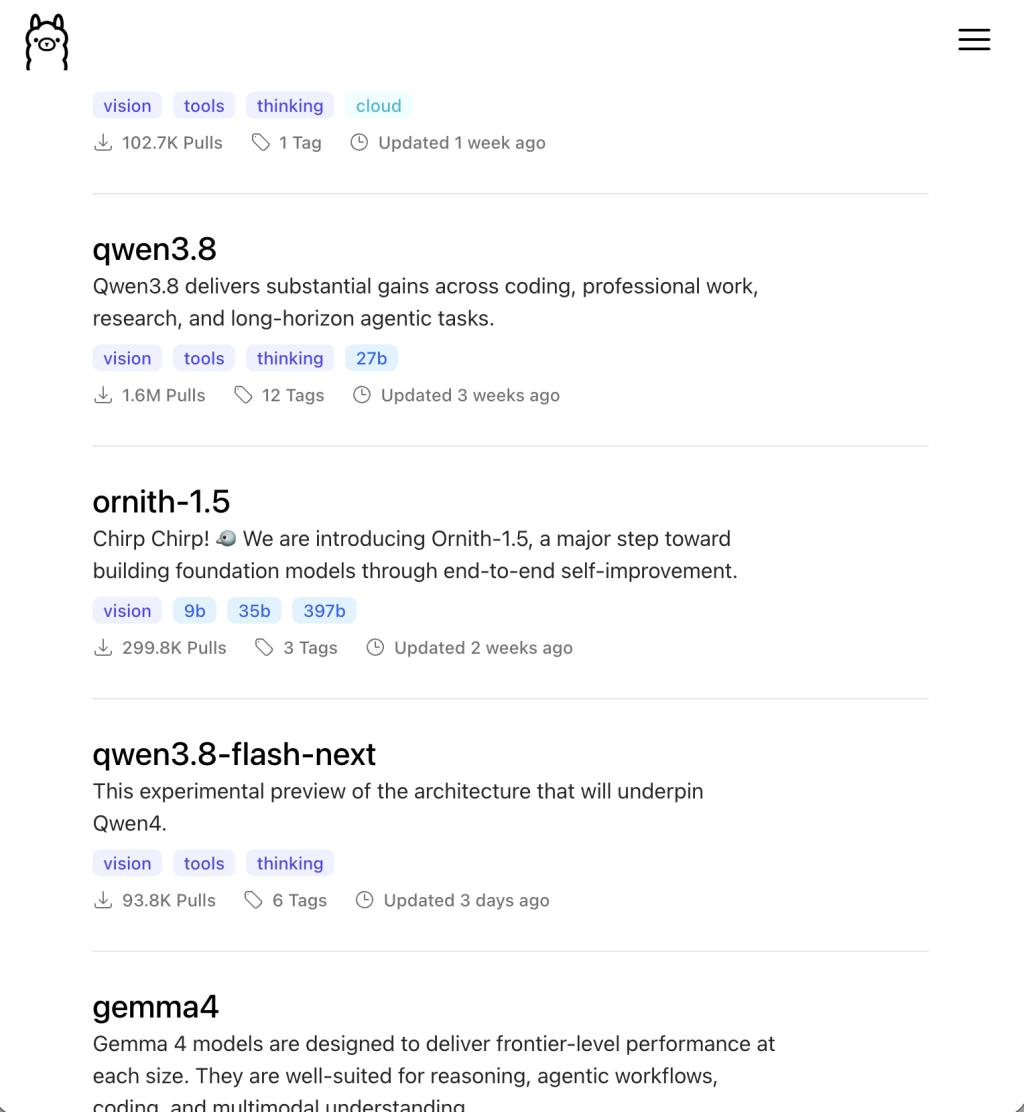
2026 下半年的開源模型跟半年前已經完全不是同一個世界,幾個觀察:
MoE(混合專家)已經是主流,不再是大廠專利。Qwen3.x、Gemma4、Ornith1.5 這幾條產品線幾乎都同時推出 dense(密集)與 MoE 兩種版本,讓「總參數量」與「實際運算量」開始脫鉤,這點會直接影響你等下要怎麼抓 vRAM。
巨獸級模型持續刷新上限:Moonshot AI 的 Kimi K3(2.8T 總參數 MoE)目前是分數最高的開源權重模型,但光是 Q4 量化就要吃掉約 1.56 TB 記憶體,基本上只存在於伺服器機房,跟一般開發者的桌機無緣。
邊緣端也在狂飆:Google Gemma 4 的 E2B / E4B 系列主打「effective parameters」(有效參數),靠 Per-Layer Embeddings 技巧把手機、樹莓派都納入可執行範圍;Meta Llama 4 Scout 則是用 MoE 架構撐出 1000 萬 token 的誇張上下文窗口。
小廠靠訓練方法彎道超車:DeepReinforce 這家新創沒有從零訓練基礎模型,而是在 Qwen3.5 / Gemma4 上做強化學習後訓練,推出的 Ornith 系列反而在特定任務(尤其是 agentic coding)打贏體積是自己好幾倍的對手。
授權條款持續往寬鬆靠攏:MIT、Apache 2.0 幾乎已經是新模型的預設選項,商用門檻愈來愈低。
但真正能在單張消費級顯卡或 macOS 統一記憶體上跑、又同時具備不錯 tool use 能力的,其實就那幾個常客,這裡挑三個有代表性、剛好落在不同定位的模型來實測比較:
| Ornith-1.5-9b | Qwen3.6-35b-a3b | Gemma4-e4b | |
|---|---|---|---|
| 廠商 | DeepReinforce | Alibaba | |
| 架構 | Dense(9b,源自 Qwen3.5) | MoE(35b 總參數/3b 活躍專家模型) | Dense+PLE(8b 總參數/4.5b 有效參數) |
| 授權 | MIT | Apache 2.0 | Apache 2.0 |
| 原生上下文 | 256k | 256k(YaRN 可延伸至 1M) | 128k |
| Q4 量化大小 | 6.6 GB | 22 – 23 GB | 6.1 – 9.5 GB |
| 多模態 | 文字 / 圖片 | 文字/圖片 | 文字/圖片 |
| 原生 Tool Calling | 支援 | 支援(含結構化輸出、思考保留) | 支援 |
Tool using 能力:三個模型都掛了 Ollama 的 Tools 能力標籤,但表現不完全對等。社群針對 Ornith-1.5-9B 做的分層工具呼叫測試(L1 基礎呼叫、L2 參數萃取)都通過,不過有使用者回報平行工具呼叫(parallel tool calls)一開始會出錯,需要手動開啟推理模式(reasoning)才會穩定——這是小模型常見的取捨,思考鏈開著能救回穩定度,但也代表你得多付一點輸出 token 的成本。
Qwen3.6-35B-A3B 因為原生支援「thinking preservation」,在多輪、需要跨步驟記住工具呼叫結果的 agent 任務上表現較穩。Gemma4-E4B-it 的函式呼叫格式乾淨、延遲低,但在需要長鏈推理的複雜工具編排上,深度不如另外兩者。
Token 輸出效率:架構比廠牌更關鍵。有測試比較 Ornith 系列與同代其他 MoE/dense 模型,發現 MoE 架構(Ornith1.5、Qwen3.x 的 MoE 版本)明顯快過同級 dense 模型,差距可達 3 倍以上,因為 MoE 每個 token 只需要喚醒少數專家,讀取的權重量遠小於總參數量。另一份在 8GB vRAM 環境下的測試則顯示,Gemma4-E4B 的生成速度(約 83 tok/s)比同量級的 dense 程式碼模型快近一倍,適合當「秒回」型的自動補全或簡單問答;但遇到需要長推理鏈的除錯或安全審查任務,Ornith 那種「總參數池較大」的 MoE 設計能挖出更多細節。
簡單結論:Gemma4-e4b 拿來做輕量、低延遲的日常助手;Qwen3.6-35b-a3b 適合當你的主力 agent 大腦;Ornith-1.5-9b 則是「用小搏大」的 coding 專用選手,尤其適合裝不下 35b 的機器。
從 2023 年到目前觀察下來,開源地端模型的競爭邏輯已經悄悄變了:
從比參數量,變成比訓練方法
Ornith 的例子最明顯 — 它不是從零預訓練,而是把強化學習做到讓模型自己出題、自己搭建 scaffold、自己生成訓練資料(所謂的自我改進迴圈),結果 9B 模型能在特定任務上逼近甚至打贏三倍體積的對手。這代表算力門檻不再是唯一護城河。
版本迭代速度變快
Qwen 從 3.5 到 3.6 幾個月內就推出,每次都帶著實測分數上升;這對地端使用者是好消息,但也代表「盤點一次就用一年」的心態行不通,模型選型要當成持續性工作。
社群修正層變厚
Ollama、Hugging Face 上很快就會冒出「-fixed」「-GGUF」「-1m」這類社群重新打包的版本,修正官方 tag 的 tool calling 格式錯誤或延伸 context window。這其實反映一個工具鏈正在成熟的訊號:從模型發布到能穩定接進 Claude Code、OpenCode 這類 agent 框架,中間有一段社群補完的過程,選型時建議多看幾個月的討論再下手。
授權障礙持續下降
MIT/Apache 2.0 幾乎已是預設,代表你不太需要再為了法遵問題排除某個效能最好的模型。
過去半年真正的黑天鵝,不是哪家又發了新模型,而是全球記憶體大缺貨 — 外媒戲稱這波「RAMmageddon」。AI 資料中心對 HBM(高頻寬記憶體)的胃口大到讓 Samsung、SK Hynix、Micron 三大廠把晶圓產能整批挪去做企業級記憶體,一般消費級 DDR5 供給因此被硬生生擠壓:2025 年中一組 32GB DDR5 套裝約 US$80,到 2026 年中同款已經衝上 US$374 以上,漲幅超過 300%,部分報告甚至看到 600–700% 的區間。Apple 也在 6 月底直接調漲 MacBook Air/Pro 售價,公開點名記憶體與儲存成本上漲是主因。TrendForce、SK Hynix 高層普遍認為這波緊缺會拖到 2027、甚至 2028 年才緩解。
與此同時,三大陣營也在用「統一記憶體」這條路線正面迎戰 vRAM 天花板:
Apple M 系列:M5 Pro/Max/Ultra 靠統一記憶體架構,把 CPU、GPU 記憶體池合而為一,高階配置最高可達 512GB,是目前個人開發者要跑 70B 以上模型最務實的選擇——但今年春天蘋果一度把 Mac Studio 最高記憶體規格從線上商店下架,被視為缺貨潮波及自家供應鏈的直接證據。
NVIDIA DGX Spark(GB10 Grace Blackwell):巴掌大的桌上型「個人 AI 超級電腦」,128GB LPDDR5x 統一記憶體、1 petaFLOP FP4 算力,單機可跑到 200B 參數模型,用 ConnectX-7 把兩台串起來能到 405B。定位很清楚:把過去只存在機房的統一記憶體優勢搬到工程師桌上,但 US$4,699 的價格也不是玩票級的投入。
AMD Ryzen AI Max+ 395(Strix Halo):同樣主打 128GB 統一記憶體,但價格親民不少,是目前地端 LLM 社群討論度很高的「平價版 DGX Spark」。
這場硬體戰,正在反過來重塑模型生態的長相。廠商開始很明顯地「照著記憶體級距出模型」— Gemma4 的 E2B/E4B 專門瞄準 8GB 以下的邊緣裝置;Ornith、Qwen 的 9B~35B 級距,剛好卡在消費級顯卡(16–24GB)跟 Strix Halo/DGX Spark 這類 128GB 統一記憶體裝置的甜蜜點;而 Kimi K2.6、Ornith1.5-397B 這種千億甚至兆級 MoE,則直接是衝著 DGX Spark 雙機串聯或 Mac Studio 頂規去設計。近期新模型常常一次發布好幾個尺寸(2B/9B/27B/35B/397B 這種跳躍式分佈),本質上就是在把整條記憶體階梯都覆蓋掉,逼你在「買更多記憶體」跟「換一個更聰明但更省記憶體的模型」之間做選擇。
軟體層也在跟進這股統一記憶體浪潮:Ollama 的 MLX 引擎(2026 年 3 月推出預覽、6 月大幅更新)針對 Apple Silicon 做了專門優化,官方說法是同一顆模型在 MLX 路徑下輸出品質更好、速度更快、用的記憶體更少,比舊有的 GGUF/llama.cpp 路徑更貼近統一記憶體架構的特性。
換句話說,2026 年下半年的地端部署規劃,已經不只是「哪個模型比較強」的問題,也是「你要押注哪一種記憶體架構」的問題 。
與其套公式硬算,不如直接查模型在 Ollama library/Hugging Face 上「實際掛出來的下載檔案大小」,這個數字已經是廠商/社群量化好、可以直接載入的權重大小,準確度比自己拿參數量乘位元組換算高很多,也不用擔心不同架構(dense/MoE)換算公式不一樣的問題。三個模型經實測 Q4 量化的裝機大小如下:
| 模型 | 量化等級 | ≈ 實際所需 vRAM |
|---|---|---|
| Ornith-1.5-9b | Q4 | 約 14 GB+ |
| Qwen3.6-35b-a3b | Q4 | 約 24 GB+ |
| Gemma4-e4b | Q4 | 約 8 GB+ |
所以根據「下載回來的權重檔案大小」,還要再預留兩筆額外空間才是實際使用 vRAM:
KV cache/context window:上下文開得越長,這筆費用越高,尤其是標準全注意力層。Ornith 跟 Qwen3.6 用了混合線性注意力(Gated DeltaNet 搭配少數全注意力層),把 256k 長上下文的 KV 開銷壓得比傳統 Transformer 低,但真的把 context window 開好開滿時,還是建議在檔案大小之上抓 2–4GB 餘裕。
系統緩衝:作業系統、瀏覽器、其他背景服務也會分走一部分記憶體,抓 1–2GB 保守值即可。Apple Silicon 用戶則要注意算的是「統一記憶體」總量,不是獨立顯卡 vRAM,macOS 本身也會先扣掉一截;如果你走的是 DGX Spark/Strix Halo 這類統一記憶體路線,邏輯也一樣。
一句話總結
到模型頁面查詢要跑模型的量化下載大小 → 加 2–4GB 給 context/KV cache → 加 1–2GB 系統緩衝 → 這就是你該準備的顯卡(或統一記憶體)vRAM 容量。
回到第一篇的靈魂拷問:這個月公司燒了多少 token?當你手上有 Ornith-1.5-9B、Gemma4-E4B 這種能塞進一張 16G 消費級顯卡,或是一台 Mac mini/Studio 統一記憶體的模型,答案其實可以變成「跟電費帳單一樣穩定」。
地端化不是要你完全丟掉雲端 API、最強的推理任務,雲端旗艦模型現階段還是有優勢。但把日常的程式碼補全、內部文件問答、agent 工具編排這類高頻、低機密容忍度較高的任務挪到地端後,你換到的是:
邊際成本趨近於零:跑一千次還是十萬次,多的只是電費跟硬體折舊,沒有 per-token 帳單。
沒有速率限制:不用在流量尖峰時排隊等 API 額度回補。
資料不出門:內部程式碼、客戶資料不用經過第三方伺服器。


 iThome鐵人賽
 看影片追技術