
想像一個場景:桌上架一台 WebCam,對著某個公司產品拍。使用者一邊看著鏡頭畫面,一邊打字問:「這是什麼型號?」、「這個規格是什麼?」。
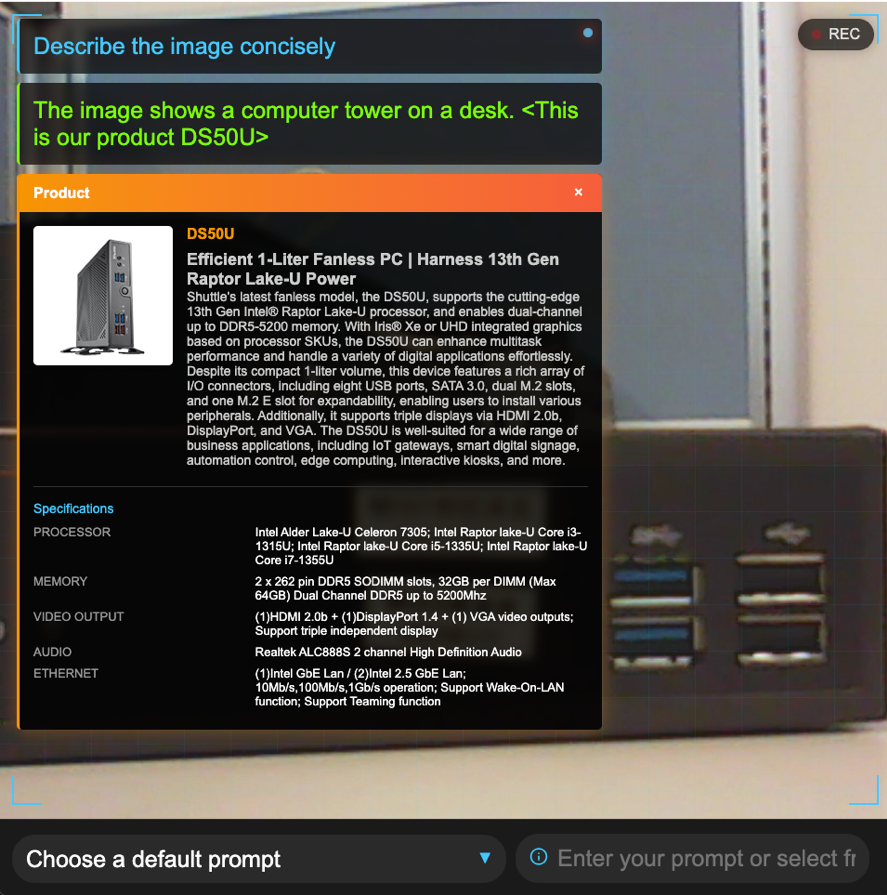
這次要做的專案要能:
第 2 點是這次架構的關鍵眉角。VLM 很會「看圖說故事」,但如果你要它準確吐出一個型號,常常會唬爛。所以這次的設計思路,是讓 VLM 負責「理解使用者在問什麼、整理最終回答」,但精確辨識這件事另外交給 CLIP 做向量比對 — 這其實就是視覺版的 RAG:不是拿文字去向量資料庫找相似段落,而是拿「這張照片」去向量索引庫找「長得最像的產品照片」,再回推型號。
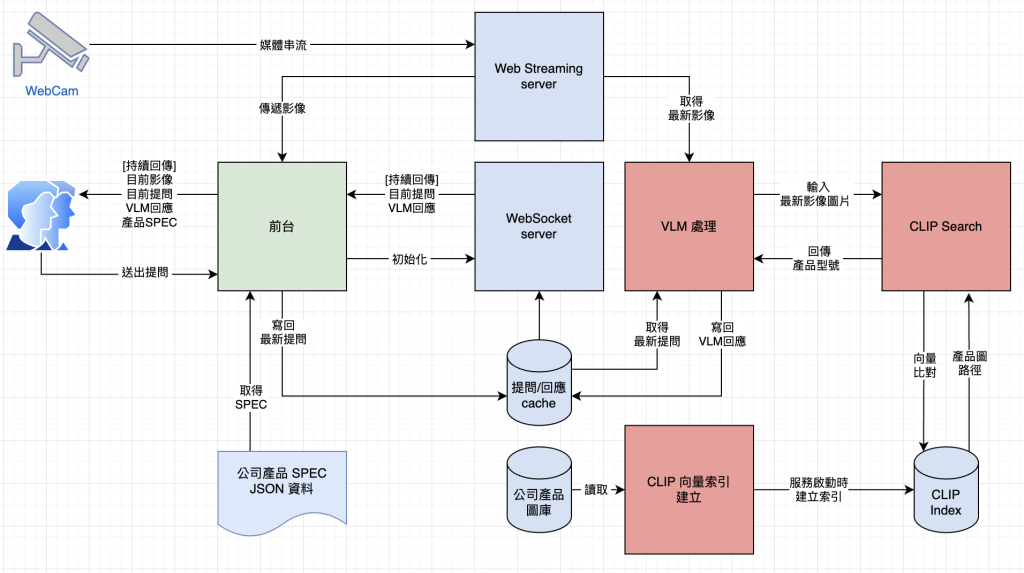
先不看細節,把架構圖收斂成三個區塊:
前端 / 即時互動區塊:WebCam → Web Streaming Server → 前台 → WebSocket Server。負責把畫面即時秀出來、讓使用者打字問問題、把答案即時推回去。
AI 判斷區塊:VLM 處理 + CLIP Search + CLIP Index。負責看圖、理解問題、精確比對出產品型號。
資料區塊:提問/回應 cache、公司產品 SPEC JSON、公司產品圖庫 + CLIP 向量索引建立。負責提供「素材」給前面兩塊用。
接下來就照這三塊,一個一個元件講。
| 元件 | 負責什麼 |
|---|---|
| WebCam | 影像來源,持續產生媒體串流,可以是 USB 攝影機或工業相機 |
| Web Streaming Server | 接住 WebCam 的串流,一邊轉發給前台顯示畫面,一邊保留「最新一張影像」讓後端隨時來拿 |
| 前台 | 使用者實際操作的介面:看鏡頭畫面、打字送出提問、即時顯示 VLM 回應跟對應的產品規格 |
| WebSocket Server | 前台跟後端之間的即時橋樑,靠 WebSocket 做雙向推播,不用前端一直輪詢 |
這裡有個小設計值得注意:Web Streaming Server 跟 VLM 處理是分開拿影像的。串流本身是連續的畫面流,但 VLM 不需要每一幀都處理(太貴也沒必要),它只要「取得最新影像」這一張靜態圖就夠了。把「串流轉發」跟「單張截圖給 AI 用」拆開,是效能上很實際的考量。
另外前台跟 WebSocket Server 之間也沒有直接綁死,中間隔了一個「提問/回應 cache」。這樣設計的好處是解耦:前台只管寫最新提問、讀最新回應,不用管後面 VLM 到底跑多久、CLIP 有沒有比對成功。未來就算要改成多人同時提問、或是把 VLM 換成非同步佇列處理,前台這邊幾乎不用改。
| 元件 | 負責什麼 |
|---|---|
| VLM 處理 | 拿到最新影像 + 使用者最新提問,先做語意理解,判斷使用者想問什麼 |
| CLIP Search | 收到 VLM 丟過來的影像,轉成向量後去 CLIP Index 做向量比對,找出最相似的產品,回傳型號 |
| CLIP Index | 預先建好的向量資料庫,存的是「產品照片轉出來的向量」跟對應的圖片路徑 |
這邊的分工邏輯是:VLM 很擅長「看懂場景、理解問題、組織語言」,但單靠它去精確辨識「這是 A 型號還是 B 型號」不太可靠,因為它沒有真的比對過公司自己的產品資料庫,只是靠訓練時看過的知識在猜。
所以流程上,VLM 判斷「使用者是在問產品身分」之後,會把影像轉手丟給 CLIP Search。CLIP Search 做的事情很單純粗暴但有效:把這張圖轉成向量,拿去跟 CLIP Index 裡面所有產品照片的向量做相似度比對,找出最像的那一張,回傳它對應的產品型號。這就是一個標準的「以圖找圖」流程,準確度會比讓 VLM 純用文字知識瞎猜高非常多。
| 元件 | 負責什麼 |
|---|---|
| 提問/回應 cache | 暫存目前最新的提問跟 VLM 回應,是前台跟 WebSocket Server 之間的資料橋樑 |
| 公司產品 SPEC JSON 資料 | 存放每個產品型號對應的詳細規格,前台可以依照辨識出來的型號查出完整資訊 |
| 公司產品圖庫 | 每個產品事先準備好的參考照片 |
| CLIP 向量索引建立 | 服務啟動時讀取產品圖庫,跑一次 CLIP 把每張圖轉成向量,建成 CLIP Index |
值得注意的是「CLIP 向量索引建立」跟「CLIP Index」是服務啟動時就先做好的,不是每次使用者問問題才臨時算。這跟一般文字 RAG 的做法一模一樣:先把知識庫(這裡是產品圖庫)離線轉成向量、建好索引,查詢時只要做比對,速度才會快。
把三塊拼起來,一次完整互動大概長這樣:
WebCam持續把畫面丟給Web Streaming Server
Web Streaming Server一邊把畫面即時轉發給前台顯示,一邊保留最新一張影像備用
使用者在前台輸入問題,例如「這是什麼型號?」
前台把提問寫進提問/回應 cache
VLM處理去Web Streaming Server拿最新影像、去cache拿最新提問
VLM判斷這是在問產品身分,把影像轉交給CLIP Search
CLIP Search把影像轉向量,拿去CLIP Index比對,找出最相似產品,回傳型號給VLM
VLM(或前台)拿型號去查公司產品 SPEC JSON,取得完整規格整理好的回應寫回
提問/回應 cache
WebSocket Server偵測到 cache 有新回應,推播給前台
前台即時把「目前影像、目前提問、VLM 回應、產品規格」一起呈現給使用者
整段跑下來,其實就是把「即時串流」+「多模態理解」+「向量比對辨識」+「結構化資料查詢」四件事串成一條線,而且刻意用 cache 跟 WebSocket 把前後端拆開,避免整套系統變成一坨互相卡死的同步呼叫。
這次案例的設計思路有三個:
串流跟推論分開拿資料:即時畫面是給人看的,AI 只需要「當下那一張」,兩者不要混在一起處理。
用 cache + WebSocket 解耦前後端:前台不需要知道 AI 處理花多久,AI 那邊處理完自己寫回去就好。
VLM 負責理解,CLIP 負責精確比對:語言模型擅長「懂」,但「認出正確答案」還是要靠向量檢索這種扎實的比對方式,這也是視覺版 RAG 的核心精神。
下一篇就會照著這張架構圖,實際把每個元件的程式碼寫出來。


 iThome鐵人賽
 看影片追技術