
昨天在 API Gateway 的職責清單裡,提到它很適合順便做 Rate Limiting,但只是輕輕帶過。今天把這件事攤開來講清楚。
限制流量就是關起門不讓人進來,是否有點反直覺?做生意還怕人家進來喔?
實際情形是不限流很容易把系統搞壞,PokeThreads 上線之後,Request 可能來自各種不同的來源:
不管來源是誰,如果沒有任何限制,這些 Request 都會一路衝到 Backend Service。
就算前面已經有 Load Balancer、多台 Server、Cache,只要流量夠誇張,遲早會把整個系統壓垮,而且這對其他正常使用者也不公平,不應該讓少數瘋狂打 API 的人,拖累所有人的使用體驗。
這就是 Rate Limiter 要解決的問題:限制某個對象在一段時間內最多能發送多少 Request。
可以把 Rate Limiter 想成遊樂園的分時段入場機制,樂園不會讓所有人一次湧進大門,而是每個時段核發固定數量的入場券,超過這個時段的名額,就得等下一批。
這樣做不是要為難遊客,而是確保設施不會被瞬間擠爆,讓已經進場的人也能有正常的遊玩體驗。
Rate Limiter 做的就是同個概念,不是永久拒絕誰,而是要求「現在流量太多,請稍等一下再進來」。
把時間切成固定區塊,例如每 60 秒一個 Window,在這個 Window 裡設一個計數器,每來一次 Request 就 +1,超過上限就拒絕,Window 結束後計數器歸零重來。
00:00 - 00:59  →  最多 100 次
01:00 - 01:59  →  最多 100 次
實作起來非常簡單,但有個明顯的邊界問題,例如:
如果使用者在 00:59 秒衝了 100 次,緊接著在 01:00 秒又立刻衝了 100 次,這兩個 Window 各自看都沒超標,但實際上短短兩秒內卻擠進了 200 次 Request。
遊樂園的比喻在這裡也可以對上,如果售票口是「每個整點重新核發名額」,那卡在兩個整點交界的那群人,就可能一次湧入雙倍人潮。
Sliding Window 不是死板地照時鐘切 Window,而是「看過去這段時間」,不斷用目前這個時間點往前推算,例如「過去 60 秒之內有幾次 Request」,而不是「這個固定的 60 秒區塊裡有幾次」。
這樣一來,不管使用者卡在哪個時間點打 Request,看到的都是一個連續滑動的 60 秒窗口,不會出現 Fixed Window 那種邊界瞬間灌爆的情況,但相對地,實作上需要保留更多歷史紀錄(或用近似演算法),比單純一個計數器複雜一些。
Token Bucket 是實務上很常見的做法,概念是準備一個桶子,系統會依照固定的 Refill Rate 持續在裡面加入 Token,桶子有容量上限,滿了就不再加。
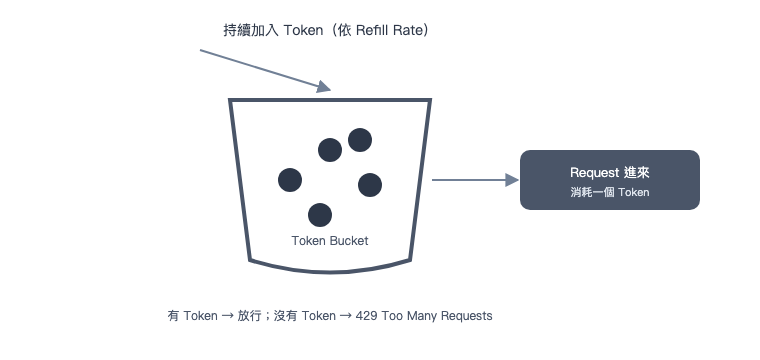
(這個圖好像珍奶)
每次 Request 進來,就從桶子裡拿走一個 Token:
這個機制最吸引人的地方是,它允許短時間內的爆發流量,只要桶子裡還有存貨。
假設使用者平常都很安靜,Token 一直在累積,某一刻突然連續發送好幾個 Request,只要桶子裡的 Token 夠,一樣可以被放行;等桶子被用到見底,才會開始限流,之後 Token 再依照 Refill Rate 慢慢補回來。
對比遊樂園的比喻:Token Bucket 比較像「入場券可以預先累積」,如果你這個時段沒進場,名額不會直接作廢,而是留到下個時段疊加使用(但疊加也有上限,不會無限累積)。
Rate Limit 通常不會只設一種維度,常見的有:
同一個系統可以疊加多層限制,例如「單一 IP 每秒不能超過 X 次」再加上「單一使用者每分鐘不能超過 Y 次」,同時防範不同類型的濫用。
當 Request 被 Rate Limiter 擋下,Server 通常會回傳:
HTTP/1.1 429 Too Many Requests
Retry-After: 30
429 讓 Client 知道「不是你的請求本身有問題,只是現在打太快了」,Retry-After 則告訴它大概該等多久再重試,這樣正常的 Client(例如手機 App)就能設計成收到 429 之後自動等待、稍後重試,而不是傻傻地立刻重打一次,讓情況更糟。
昨天提到 API Gateway 是很適合放 Rate Limiting 的位置,因為所有流量都會經過這裡,在最外層就把超量的 Request 擋下來,後面的 Backend Service 完全不需要為此另外實作一套邏輯:
Client -> API Gateway(Rate Limiter)-> Backend Services
如果放在每個 Service 各自實作,不只邏輯重複,計數方式也很難跨 Service 保持一致;統一放在 Gateway,可以確保「這個使用者這一分鐘打了幾次」有一個單一、可信的答案。
前面舉的例子都只講了一台 Rate Limiter 在計數,但現實中 API Gateway 通常不會只有一台,因為要處理大量的流量且要避免單點故障(SPOF)。
因此在 Gateway 前還會有一個 Load Balancer,把流量分散到好幾台 Gateway 上:
                  ┌─> Gateway A(Rate Limiter)
Client -> LB -----┼─> Gateway B(Rate Limiter)
                  └─> Gateway C(Rate Limiter)
按最單純的實作方式,如果每一台 Gateway 都在自己的記憶體裡維護一份計數器,問題就來了。
Pikachu 的 Request 這次被導到 Gateway A,下次被導到 Gateway B,兩台各自只看得到「打到自己這台」的次數,加起來才是真正的總數。
結果就是使用者理論上限制是每分鐘 60 次,但只要跨著 3 台 Gateway 打,實際上可能打到 180 次都不會被擋下來,限流形同虛設。
解法就是和處理 Session 的方式一樣,把「狀態」搬出 Gateway 本身,集中放到一個大家都能存取的地方,例如 Redis:
                  ┌─> Gateway A ─┐
Client -> LB -----┼─> Gateway B ─┼─> Redis(統一計數)
                  └─> Gateway C ─┘
這樣一來,不管 Request 落到哪一台 Gateway,大家問的都是同一份計數,Gateway 本身依然可以維持 Stateless,只是每次要多一趟對 Redis 的讀寫。
把計數集中到 Redis 之後,馬上冒出新問題。
如果 Gateway A 跟 Gateway B 在同一毫秒內,都收到 Pikachu 的 Request,兩邊同時「讀到還沒超標」而一起放行,結果實際上已經超過上限。
如果實作方式是分開的三個步驟:
1. GET 目前的次數
2. 判斷有沒有超過上限
3. 如果沒超過,SET(次數 + 1)回去
這種「先讀、判斷、再寫」的模式,在高併發下就是典型的 Race Condition。
Request 可能同時執行到第 1 步,都讀到「目前 59 次,還沒超過 60 次上限」,於是都給過各自把次數加 1,結果兩個都加 1,總數變成 61 次直接超過上限。
解法的核心原則是:把「讀取、判斷、寫入」這三個步驟合併成一個不可分割的原子操作(Atomic Operation),不要分開執行。常見做法:
INCR 本身就是原子操作,可以先把次數加 1 再拿到結果,最後才判斷這個結果有沒有超過上限(而不是先判斷再加),這樣就不會有「兩邊都看到還沒超標」的空窗期,頂多是多算了幾個超標的 Request 一起被擋下來,但絕不會多放行。EVAL 丟給 Redis 執行。Redis 執行 Lua Script 時是單執行緒、不會被其他指令插隊,等於把整段「讀取 + 判斷 + 寫入」邏輯打包成一個原子操作。換句話說,多台 Rate Limiter 不是問題,真正的風險在於「大家各自維護不同步的狀態」跟「同時讀寫沒做好原子性」,只要把狀態集中、並確保操作是原子的,多台機器一樣可以維持限流的正確性。
Rate Limiter 不是為了刁難使用者,而是保護系統不被異常流量壓垮,不管是惡意攻擊還是單純的程式 Bug,能同時確保資源分配對所有使用者公平。
今天介紹的 Fixed Window、Sliding Window、Token Bucket,是三種常見的計數策略,各自在「實作簡單度」跟「流量控制的精確度」之間做不同的取捨,而 Token Bucket 因為能同時兼顧「限制平均速率」與「允許短暫爆發」,是業界最常被採用的一種。
值得先說一聲:今天談的 Rate Limiter 主要是從「效能與資源保護」的角度出發,但它其實也是一種資安防禦工具,這個角色會在後續討論資安議題時再被拉出來重新檢視。


 iThome鐵人賽
 看影片追技術