
PokeThreads 走到今天,已經不是一個單純的 CRUD 小玩具了,但從 Day 2 開始,Database 一直都是同一種選擇,也就是 SQL。這時候很自然會冒出一個問題:
系統都長這麼大了,是不是該把 SQL 換成 NoSQL?
甚至有人會直接跳到結論:「大型系統不都應該用 NoSQL 嗎?」
今天就來仔細了解這個問題。
回想之前定義的三張表:
它們之間的關係非常清楚:一個 User 對應多個 Post,User 跟 User 之間透過 Follow 建立關聯。這種「關係明確、Schema 相對固定」的資料,正是 SQL(Relational Database)最擅長處理的類型。
SQL 除了關聯清楚,還有一個很重要的優勢:Transaction。假設一組操作要嘛全部成功、要嘛全部失敗(例如同時扣款與加點數)。
SQL Database 可以用 Transaction 保證這件事,中途出錯就整組 Rollback。這種能力在很多系統裡是不能妥協的,所以 SQL 從來不是「過時的技術」,只是它適合特定形狀的資料與需求。
先點出一個常見的誤解,NoSQL 不是單一一種資料庫,而是一整個大分類,裡面至少包含:
每一種都在解決不同形狀的問題,所以「SQL vs NoSQL」從來不是兩個產品在互相較勁,而是不同的 Data Model,適合不同的 Access Pattern。
決定資料庫的,不該是「系統夠不夠大」,而是「Application 最常怎麼存取這份資料」。
回想 Day 3 的 Feed Query:
SELECT *
FROM posts
WHERE author_id IN (...)
ORDER BY created_at DESC
LIMIT 20;
當 Following 數量、Post 數量、Read Traffic 持續增加,這支 Query 可能會越來越吃力。
但真正該問的不是「SQL 是不是太舊了」,而是「Feed 這種存取模式,到底適合什麼樣的儲存結構?」
Day 11 定義的 Notification 表:
Notification
├── id
├── recipient_id
├── actor_id
├── type
├── post_id
├── created_at
└── is_read
它的存取模式其實很單純:幾乎都是「依 recipient_id 撈出某個人的通知列表」,很少需要跟其他表做複雜的 Join,寫入量卻可能非常大(每個 Like、Follow、Reply 都會產生一筆)。
這種 「高寫入量、查詢方式單純、不太需要複雜關聯」 的資料,換成 Key-Value 或 Document 這類 NoSQL 模型,可能會更貼近它真正的使用方式:
{
  "notification_id": "n_8823",
  "recipient_id": "Pikachu",
  "actor_id": "Charmander",
  "type": "LIKE",
  "post_id": 123,
  "created_at": "...",
  "is_read": false
}
用 recipient_id 當 Key,直接就能撈出這個人的所有通知,不需要 SQL 那種以 Table + Join 為核心的查詢引擎。
要注意的是,這不是「把 Notification 表直接搬進 MongoDB」這麼簡單的替換,而是要重新想過:
資料要用什麼形狀儲存、最常見的查詢是什麼、能不能接受什麼程度的一致性。
換成 NoSQL 不會只拿到好處,通常也會失去(或弱化)一些 SQL 很方便的能力:
所以選擇 NoSQL,不能只看「它能不能 Scale」,還要問「它符不符合我的資料型態與查詢需求」。
這是一個很常見但不正確的歸納方式:
系統小 → SQL
系統大 → NoSQL
實際上,SQL 搭配 Read Replica、Cache、之後會談到的 Sharding,一樣能撐起非常大的流量。系統規模當然重要,但它從來不是決定 SQL / NoSQL 的唯一因素。
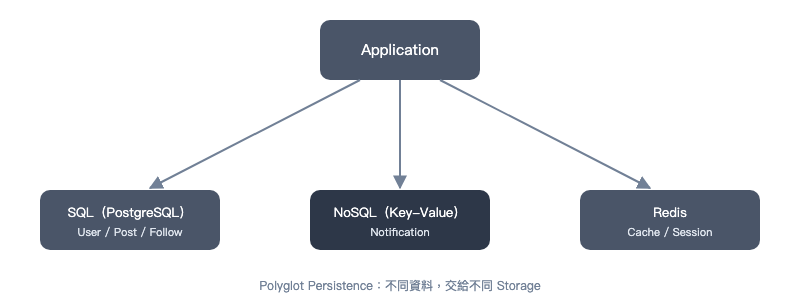
到了這個規模,比較實際的答案通常不是「SQL 換成 NoSQL」,而是不同種類的資料,交給不同的 Storage 負責,這種做法叫 Polyglot Persistence:
| 考量 | SQL | NoSQL |
|---|---|---|
| 資料關聯 | 強 | 依類型而定,通常較弱 |
| Schema | 明確、結構固定 | 通常較彈性 |
| 複雜查詢 | 方便 | 依產品而定 |
| Transaction | 成熟 | 依產品而定 |
| 水平擴展 | 需要額外設計(如 Sharding) | 許多產品原生強調 |
回到今天一開始的問題:
PokeThreads 的 SQL 需要整套換成 NoSQL 嗎?
答案是不需要,目前 User、Post、Follow 這些資料的關聯性依然很重要,沒有理由因為「系統變大」就整套搬家。真正該做的是針對 Notification 這類存取模式特殊的資料,個別評估要不要換成更合適的儲存方式。
不過這裡也留下一個新的麻煩:一旦資料開始分散在不同種類的 Storage 上(SQL、NoSQL、Cache 各存一部分),「怎麼確保各處看到的資料是一致的」這件事,只會變得比原本單純的 Primary/Replica 更複雜。


 iThome鐵人賽
 看影片追技術