
之前我們已經把 Karpathy 的六條準則分成兩個部分:怕 LLM 弄壞的寫成程式碼,其餘寫成 Markdown 交給使用者定義。今天詳細說明怎麼讓 LLM 去處理 schema/ 裡定義的那些規則——讀規則、呼叫之前我們已經看過的那六個工具、判斷什麼時候算做完。
我用一個工具呼叫迴圈來處理,七十行出頭,沒有用任何 agent 框架。編纂、對話、健檢三個操作全部跑在它上面,把知識庫與模型串接起來。
我設計了兩條驅動路徑。一條是 WikiBrain 自己的網頁,使用者填一把模型供應商的 API key,按下「編纂」就開始跑。另一條走 MCP,使用者把知識庫接上自己平常在用的 AI 工具——Cursor、Claude Code、Claude.ai、ChatGPT 都行——由那些工具直接讀寫。
今天我們先講第一條路徑。
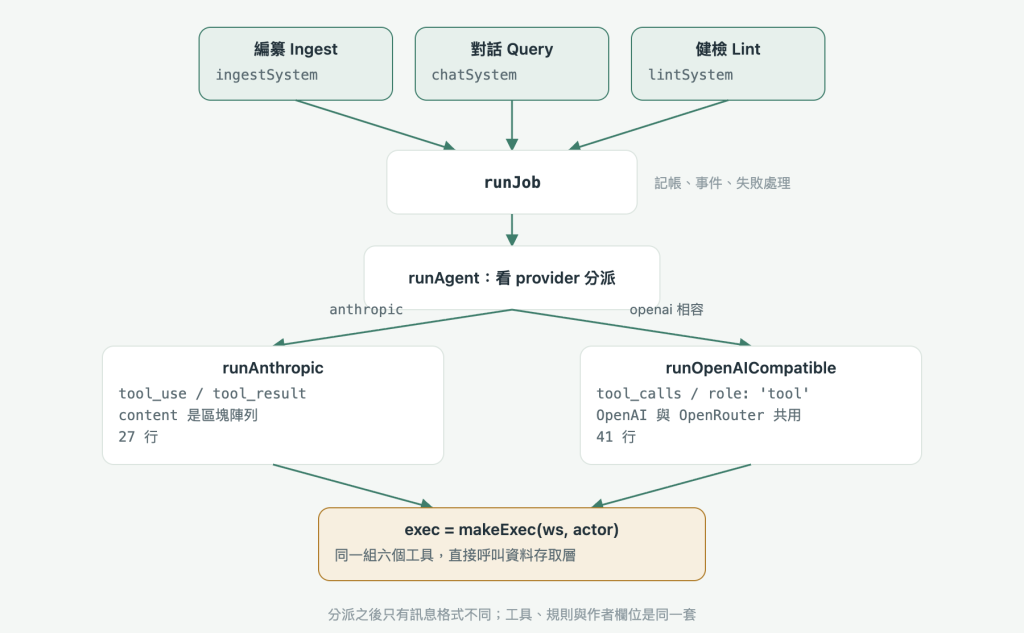
三個操作從上面進來,分派成兩套供應商實作,最後收斂到同一組六個工具。這一篇由上往下走一遍。
一個工具呼叫迴圈的骨架就是這樣:
const messages = [{ role: 'user', content: userPrompt }];

for (let step = 0; step < maxSteps; step++) {
  const res = await callModel({ system, messages, tools });

  if (res.toolCalls.length === 0) {
    return { finalText: res.text, steps: step };   // 模型不再呼叫工具,結束
  }

  for (const call of res.toolCalls) {
    const result = await exec(call.name, call.input);   // 真的去讀寫資料庫
    messages.push(toolResultMessage(call.id, result));
  }
}
這是骨架,不是原始碼——真正的實作要處理串流事件、取消訊號、步數上限與 token 計數,runAnthropic 二十七行、runOpenAICompatible 四十一行,上面再加一個四行的分派函式。
剩下的是兩家供應商的格式差異:Anthropic 用 tool_use 與 tool_result 區塊,OpenAI 相容的介面用 tool_calls 與 role: 'tool' 訊息。所以有兩套 callModel 的實作,共用同一個迴圈骨架。
OpenRouter 走 OpenAI 相容的格式,所以三家供應商只要兩套實作。
框架能幫你的是:多 agent 協作、複雜的狀態機、RAG 管線、可觀測性整合、prompt 模板管理。
我需要的是:呼叫模型、執行工具、把結果送回去、記下花了多少 token。
更實際的理由是除錯。當 agent 行為不對的時候,我要看的是「送給模型的訊息陣列到底長什麼樣」。自己寫的迴圈,加一行 console.log 就看得到。透過框架的話,我得先搞懂它怎麼組訊息、有沒有偷偷加系統提示詞、工具描述被它改成什麼樣子。
但是這個判斷有前提:如果我需要的是多步驟規劃、子 agent、複雜的記憶管理,答案會不一樣。選擇何種工具,取決於你要做的事有多複雜。
伺服器端 agent 的工具跟 MCP 那六個同名同介面,但它不走 HTTP,直接呼叫資料存取層的函式。
// 發動的地方決定作者是誰
void runJob(job, ws, cfg, { system: ingestSystem(lang), user,
  actor: { kind: 'agent', name: `${cfg.provider}/${cfg.model}` } });

// runJob 把它交給工具層
const r = await runAgent({ …, tools: TOOLS, exec: makeExec(ws, spec.actor), … });
出處:src/ingest.ts:128 與 src/ingest.ts:169
那個 actor 參數決定版本紀錄裡的作者欄位。所以你在版本歷史裡看得到「這一版是 openrouter/gemini 寫的」,跟「這一版是 Cursor 寫的」、「這一版是我自己在網頁上改的」分得清清楚楚。
同名同介面這件事很重要:MCP 那頭的 agent 跟伺服器端的 agent 面對的是同一組工具、同一組錯誤訊息、同一份規則。行為一致,我也只需要維護一套。
模型 API 會失敗,而且失敗的種類不一樣:
判斷依據只看錯誤物件上的狀態碼,不要用字串比對錯誤訊息——訊息會隨供應商改版而變。另外要記得把 SDK 自己的重試關掉,否則你的退避策略跟它的疊在一起,一次失敗會等很久。
重試發生時會在工作紀錄裡留一筆註記,這樣事後看得出來「這次跑得比較久是因為被限流過」。
每一步的 token 用量都會累加,工作結束時算成金額,存進工作紀錄。價格表用的是 OpenRouter 的公開價目,三家供應商都用它當參考價。
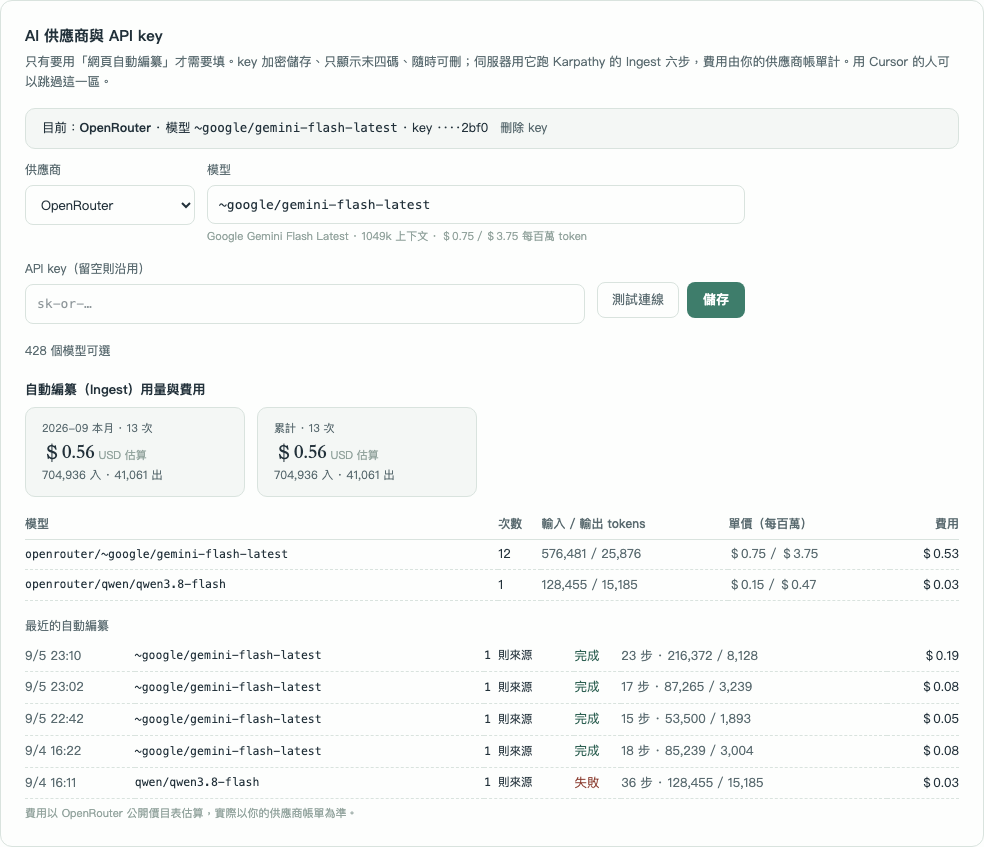
每一次編纂都留下步數、輸入與輸出 token、以及估算金額。最後那一列是一次失敗的工作——三十六步、$0.03,錢照樣花掉了。
會做這個是因為使用者用的是自己的 key,錢是他們付的。如果他們看不到花了多少,就不會信任這個功能——「按下去會不會噴掉我五美元」是一個真實的疑慮。設定頁上有本月與累計的統計、依模型分項,進度面板也會即時顯示這一次跑到目前為止花了多少。實測一次編纂大約零點零幾美元。
知識庫的規則由 schema/ 決定,資料怎麼寫由資料存取層決定。今天介紹的中間層負責把模型跟那六個工具接起來,並且把每一步都寫進工作紀錄,讓我們看得懂過程中發生了什麼事。


 iThome鐵人賽
 看影片追技術