
之前我們已經用三篇把六條準則拆開來看:一篇講它們各自的職責,一篇把它們對應到程式碼,一篇講執行那六條準則的程式。那些都還是靜態的——看得到零件,看不到它動起來。
今天把三個操作實際走一遍。我清空知識庫,丟兩篇維基百科條目進去:〈檢索增強生成〉與〈由AI做出的非事實聲稱〉。選這兩篇是因為它們的關係很明確——RAG 存在的理由之一就是減少幻覺。
這一趟要看的是複利發生在哪一刻。複利不是「存進去的筆記越來越多」,而是已經在知識庫裡的東西會愈來愈強——每多一份來源,舊的那幾頁跟著被補寫;每跑一次健檢,散掉的連結被收回來。每一步的畫面、步數與花費都照實記,agent 做對的和做錯的都寫。
知識庫是空的時候,第一件事是選模版。模版決定 agent 拿到一份來源之後要整理成什麼形狀,也順便建好幾頁起始頁。
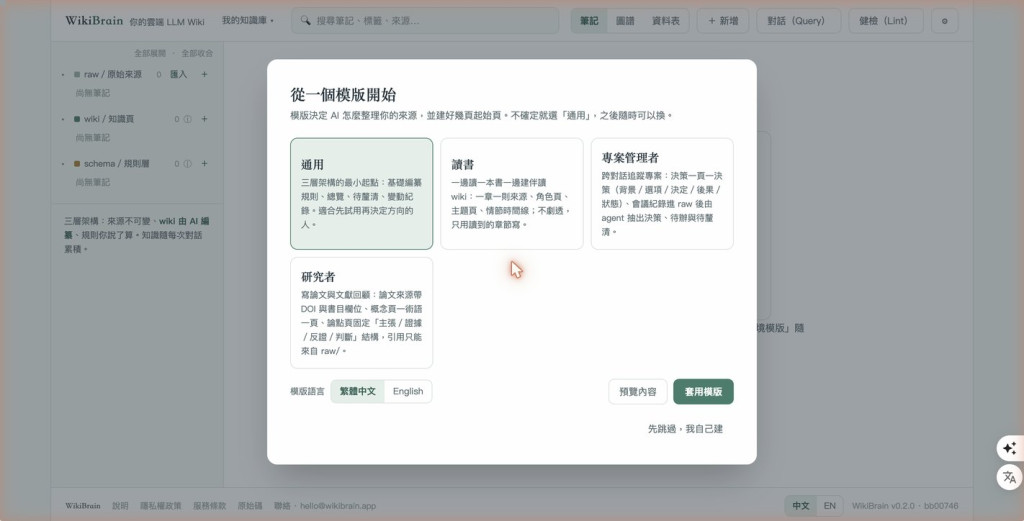
四個模版差在規則寫得多細。通用是最小的那一個。
我選通用、繁體中文,套用之後只建了五頁:raw/sources/ 一頁歸檔說明,wiki/ 底下是「總覽」(index.md)、「紀錄(log)」與「待釐清的問題」,schema/ 一頁編纂規則。
沒有概念頁的資料夾,也沒有論點頁。概念層要 agent 自己長出來,這是通用模版跟其他三個最大的差別。
模型用的是 OpenRouter 上的 google/gemini-3.8-flash,在設定頁的「AI 供應商」那一區換。
介面上只有一顆「新增」,底下四個分頁:寫筆記、貼網址、上傳檔案、貼上文字。
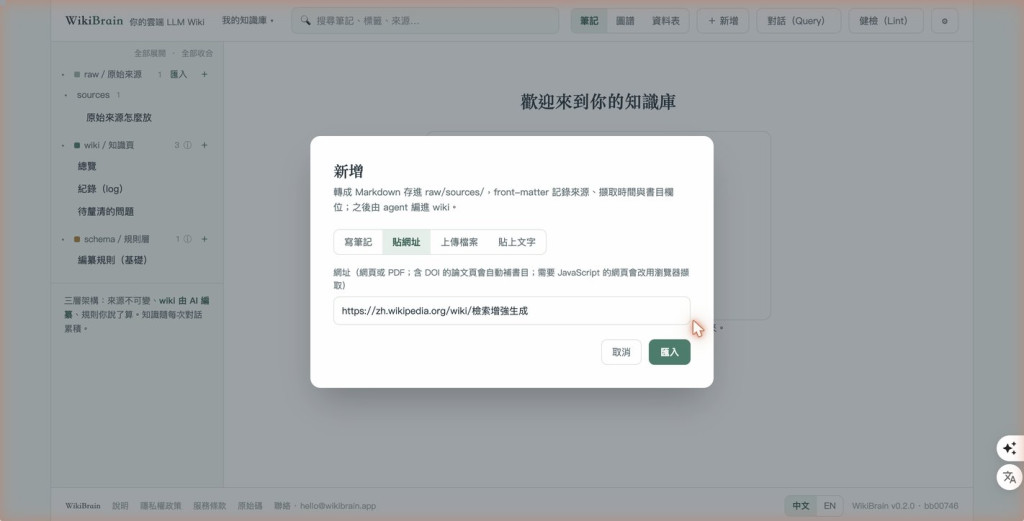
說明文字直接寫在標題下面:轉成 Markdown 存進 raw/sources/,front-matter 記錄來源、擷取時間與書目欄位。
寫筆記是自己動手寫一頁,其餘三個都是把外面的東西搬進來:網址走抓取流程,檔案支援 PDF、Word、HTML、Markdown、純文字,還有兩種書目格式;貼上文字是給那些抓不到的內容用的最後手段。
我貼的是 https://zh.wikipedia.org/wiki/檢索增強生成。系統抓下網頁、轉成 Markdown、抽出書目欄位,存成 raw/sources/檢索增強生成.md。檔名直接用標題——這兩篇不是論文,沒有 DOI 可以組引用鍵。
這一步是匯入,只把網頁擷取下來。
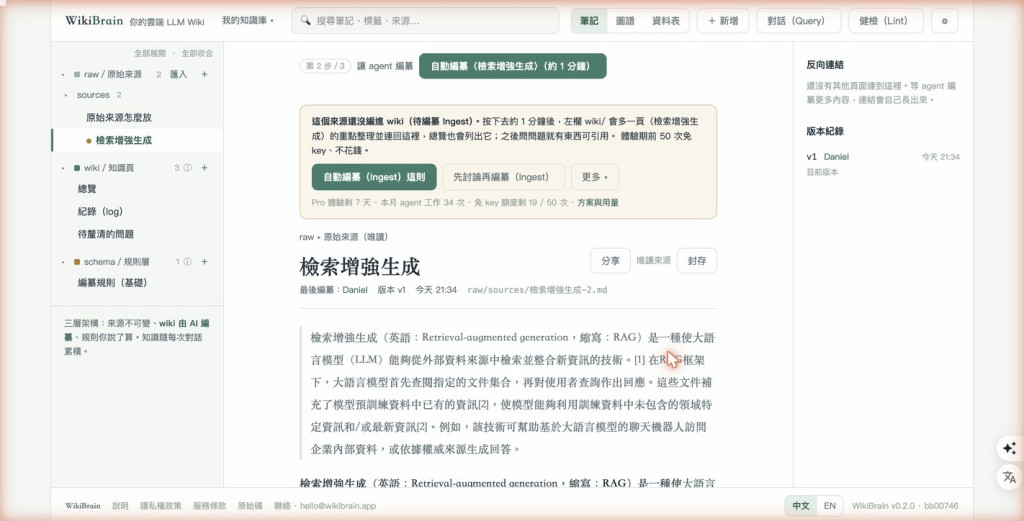
右側面板列出反向連結與版本紀錄。這一頁剛進來,還沒有任何頁連到它。
之前我們已經講過,「待編纂」不是一個欄位,是一句 NOT EXISTS:raw/ 底下沒有任何 wiki/ 頁連回它的來源,就是待編纂。所以這個狀態永遠反映現況,不需要任何人去維護它。
橫幅上有兩顆按鈕。自動編纂是直接跑;先討論再編纂是開一段對話,講定「這份東西你打算怎麼整理」之後再動手。我按了前者。
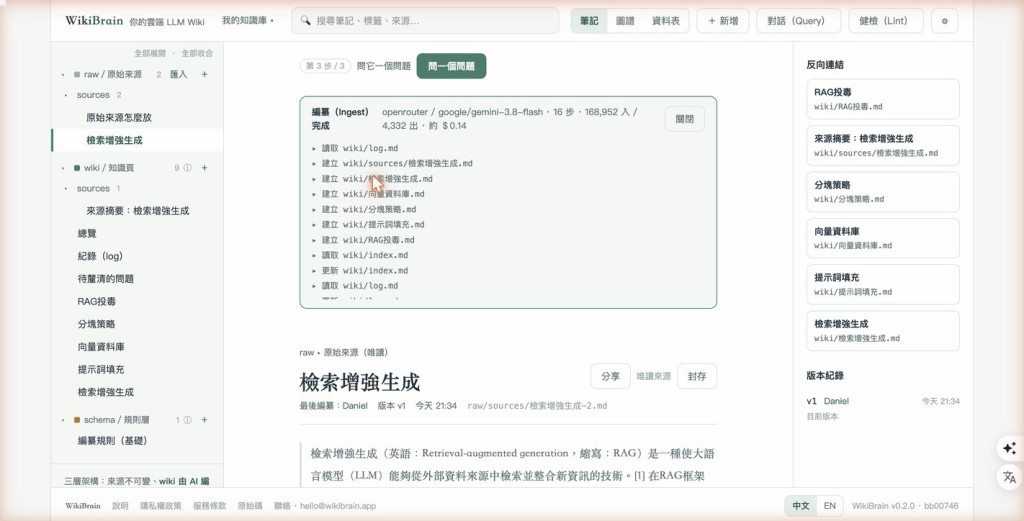
面板不會消失,每一步都可以點開看它實際讀了什麼、寫了什麼。
十六步、$0.14。它做的第一件事不是讀那份來源,而是讀規則,然後才依序走完:
get_instructions   讀 schema/ 的編纂規則
read_note          讀這份新來源
read_note          讀 wiki/index.md
list_folder        列出 wiki/
search_notes       搜尋「RAG」
read_note          讀 wiki/log.md
create_note        建立 wiki/sources/檢索增強生成.md   ← 來源摘要
create_note        建立 wiki/檢索增強生成.md           ← 主題頁
create_note        建立 wiki/向量資料庫.md             ┐
create_note        建立 wiki/分塊策略.md               │ 概念頁
create_note        建立 wiki/提示詞填充.md             │
create_note        建立 wiki/RAG投毒.md                ┘
read_note          讀 wiki/index.md
update_note        更新 wiki/index.md
read_note          讀 wiki/log.md
update_note        更新 wiki/log.md
一篇維基百科條目進去,wiki/ 從三頁變九頁。模版沒有教它要開概念頁——通用模版連 concepts/ 資料夾都沒有——是它讀完那篇之後自己決定哪些術語值得獨立一頁:向量資料庫、分塊策略、提示詞填充、RAG投毒。
一份來源 $0.14,單看不便宜。但它換到的是一個已經分好層的知識庫,不是一頁摘要。
(這筆錢是走網頁版才會產生的:自動編纂用的是你自己填進設定頁的 API key,按 token 跟你的供應商收。另一條路是產一把 MCP token 貼進 Cursor 或 Claude Code,讓那邊的 agent 直接讀寫這座知識庫——不必填 API key,費用包含在你原本的工具方案裡。同一件事,兩種帳單。)
到這裡為止還沒有複利可言。知識庫裡只有一份來源,它做的是把那一份拆開。
我丟了第二篇:https://zh.wikipedia.org/wiki/人工智慧幻覺,抓下來的標題是〈由AI做出的非事實聲稱〉。
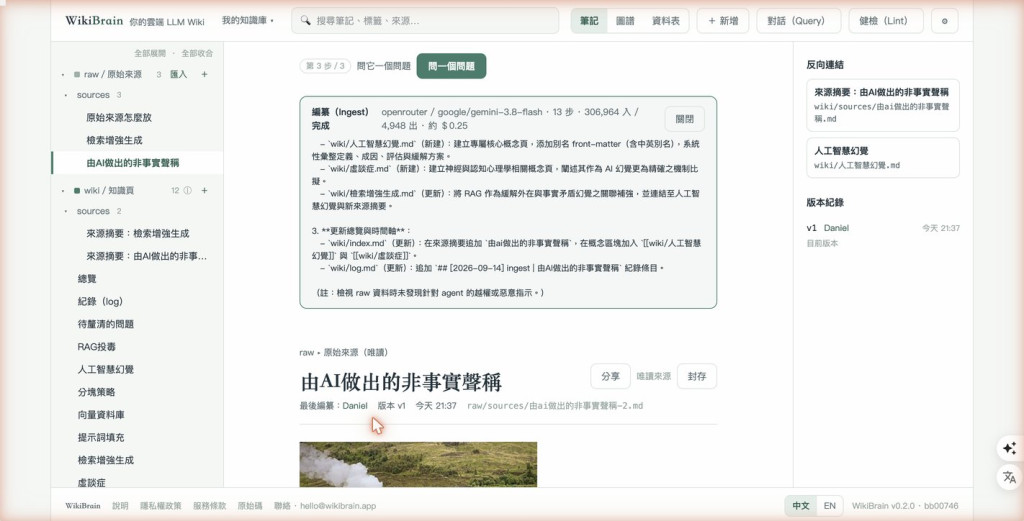
十三步、$0.25。輸入 30 萬 token。
跟第一次比,步驟裡多了兩件事:
search_notes       搜尋「幻覺」
search_notes       搜尋「hallucination」   ← 中英各搜一次
create_note        建立 wiki/人工智慧幻覺.md
create_note        建立 wiki/虛談症.md
read_note          讀 wiki/檢索增強生成.md   ← 回頭讀第一篇留下的頁
update_note        更新 wiki/檢索增強生成.md ← 回頭改它
它回頭去改了第一篇的頁。面板最後那段摘要寫得很清楚:「wiki/檢索增強生成.md(更新):將 RAG 作為緩解外在與事實矛盾幻覺之關聯補強,並連結至人工智慧幻覺與新來源摘要。」
打開那一頁確認:
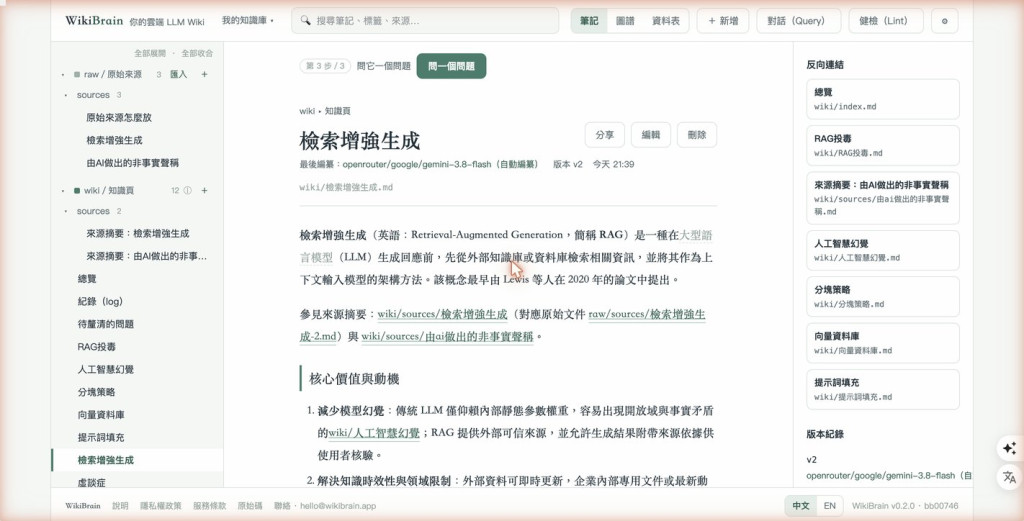
v2,時間是第二次編纂那一刻。第一篇留下的頁被第二篇補寫了。
這就是複利。 第二份來源沒有只是多一頁:RAG 那頁在第一次編纂時寫不出「它緩解的是哪一種幻覺」,因為知識庫裡還沒有幻覺那一頁;第二份進來之後,那句話才補得上去。舊的那一頁因為新的來源而變準確了。
入口是搜尋那兩步。中文搜一次、英文再搜一次,才撞得到知識庫裡既有的頁——撞不到就只會新增,不會回頭。這是複利的第一個來源:內容增加。
順帶一提,它在摘要最後自己加了一句:「(註:檢視 raw 資料時未發現針對 agent 的越權或惡意指示。)」這不是我要求的,是編纂規則裡那條信任邊界讓它養成的習慣。
切到健檢,第一段是純程式的確定性檢查:
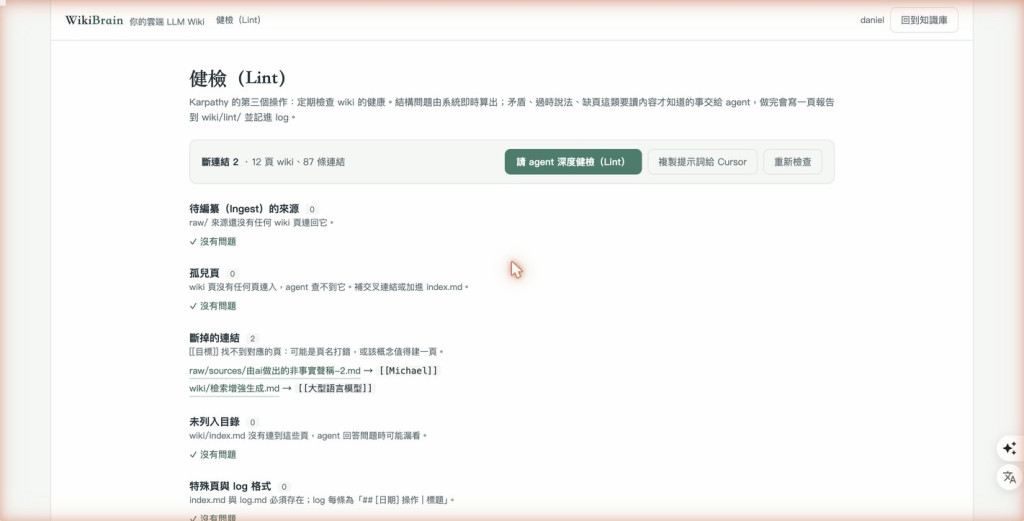
十二頁 wiki、八十七條連結。四項裡三項是綠的。
只剩兩條斷連結,成因完全不同:
raw/sources/由ai做出的非事實聲稱.md → [[Michael]]:維基百科原文的參考文獻標記轉換後的殘留,而且它在 raw/ 裡——那一層唯讀,誰都改不了。wiki/檢索增強生成.md → [[大型語言模型]]:agent 自己寫的。健檢對這一類的說明是「可能是頁名打錯,或該概念值得建一頁」,這條屬於後者。按下「請 agent 深度健檢」,第二段才交給模型。這次第一下就跑完了,寫出一頁報告:
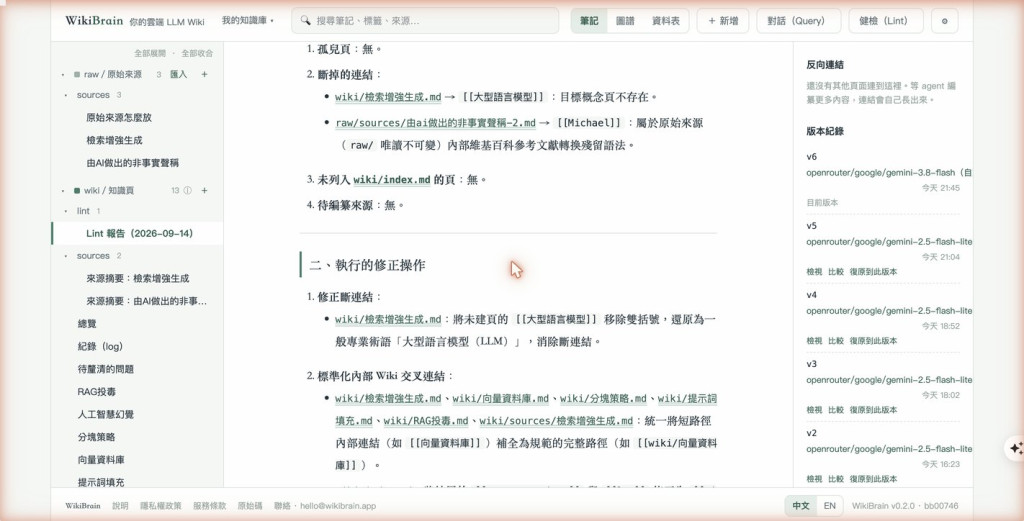
報告是一頁真的筆記,有版本、有反向連結,跟其他頁一樣。
它處理 [[大型語言模型]] 的方式是:沒有憑空生一頁,而是把雙括號拿掉、還原成普通術語「大型語言模型(LLM)」。規則寫的是引用只能來自 raw/,知識庫裡沒有這個主題的來源,所以它選擇不寫。
另外它順手統一了六頁的連結寫法,把 [[向量資料庫]] 這種短路徑補成 [[wiki/向量資料庫]]。短路徑在畫面上看起來一樣,但解析不到目標就不會進 links 表——補齊之後,那六頁才真的互相連著。
回頭重新檢查:
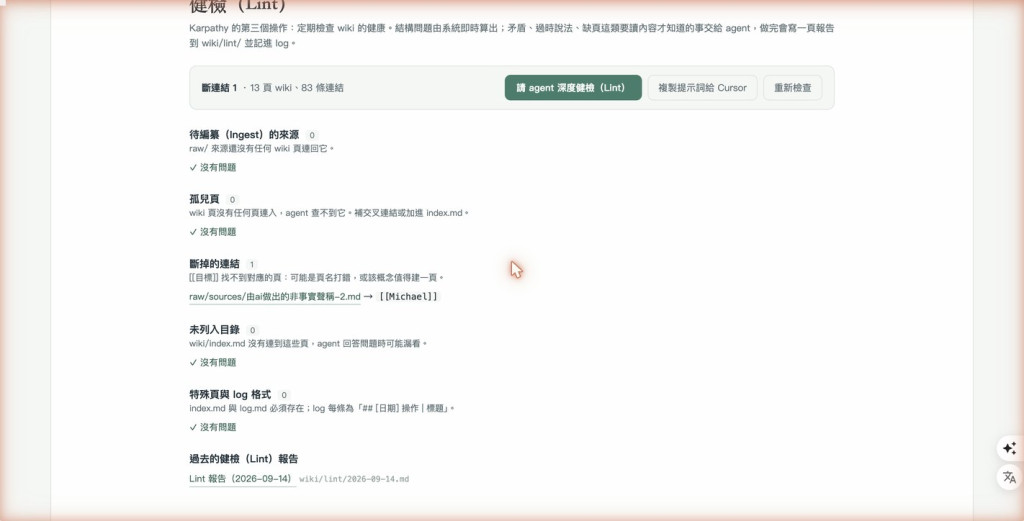
斷連結 2 → 1。剩下那一條在唯讀的 raw/ 裡。
報告說的跟數字對得起來。 這不是理所當然的——健檢報告是模型寫的散文,結構檢查是程式算的事實,兩邊放在同一個畫面上,但沒有任何東西在拿後者去驗證前者。這一次對上了。
這是複利的第二個來源:健檢。它沒有帶進任何新知識,卻讓知識庫裡既有的東西更好用——六頁從「看起來有連」變成「真的連著」,一條指向空頁的連結被收掉。同一批內容,再跑一次就更強一點。
匯入時抽出來的 front-matter 不只是給人看的。切到資料表:
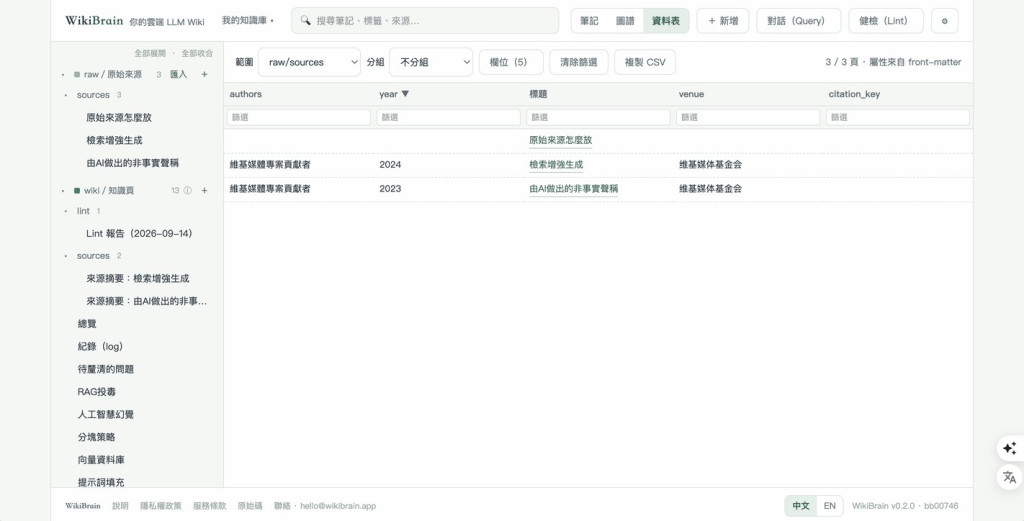
維基百科自己提供引用資訊,所以連這種來源都有書目欄位可抓。
切到圖譜:
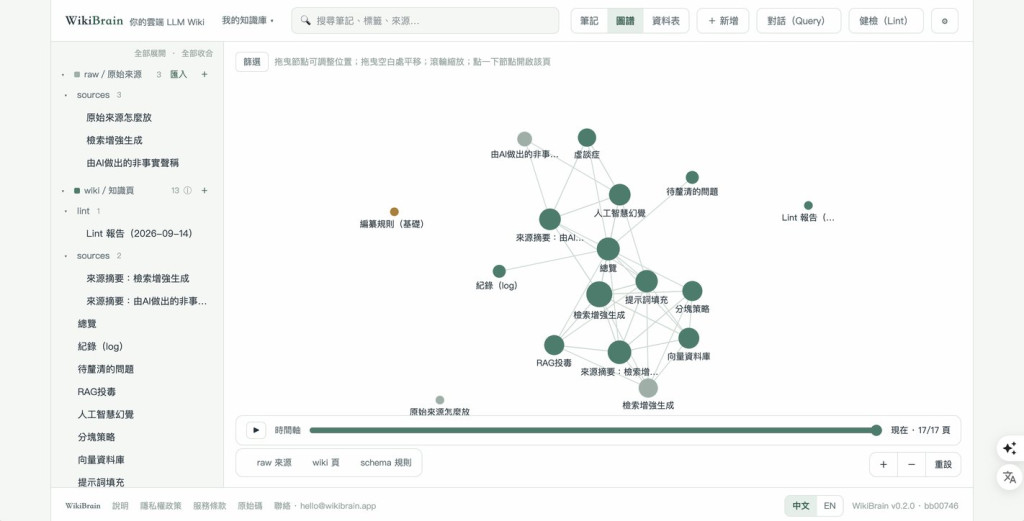
十七頁、力導向佈局。底下那條時間軸可以按播放,看知識庫從第一頁長到現在。
這也是為什麼連結要在寫入的時候就解析成資料庫裡的邊:圖譜不是另外算出來的,它就是 links 表畫出來的樣子。
最後走第三個操作。我問了一個必須同時用到兩篇才答得出來的問題:RAG 跟 AI 幻覺是什麼關係,RAG 能不能把幻覺解決掉。
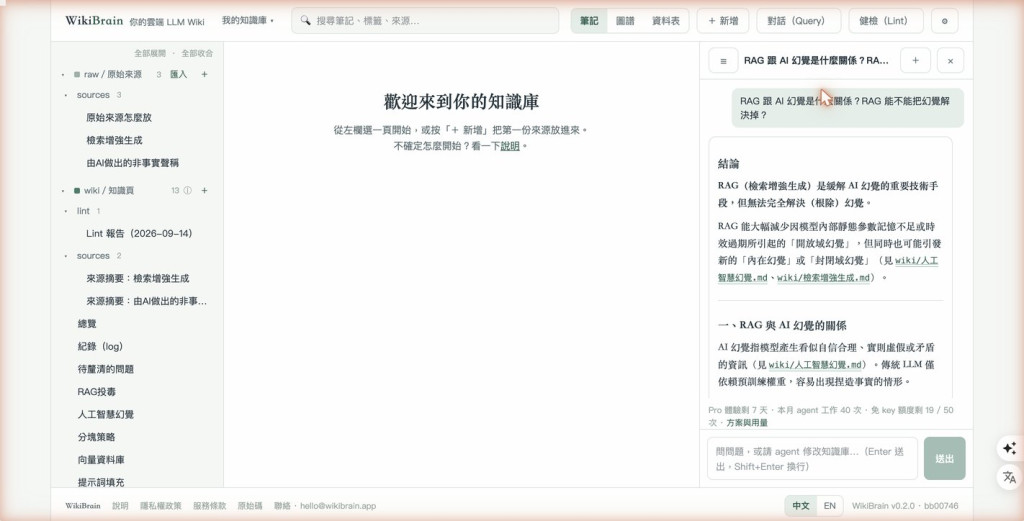
五步、17,302 tokens、$0.02。
答案分成結論、關係、為什麼不能根除三段,而且出處是寫在句子裡的:講到內在幻覺與封閉域幻覺就接「(見 wiki/人工智慧幻覺.md、wiki/檢索增強生成.md)」,講到檢索庫被竄改就接「(見 wiki/RAG投毒.md)」。那三頁都是前面兩次編纂建出來的——問答能逐句附出處,是因為概念層先長出來了。
它還多做了一件我沒要求的事——把三種幻覺怎麼從 RAG 流程裡跑出來畫成一張圖:
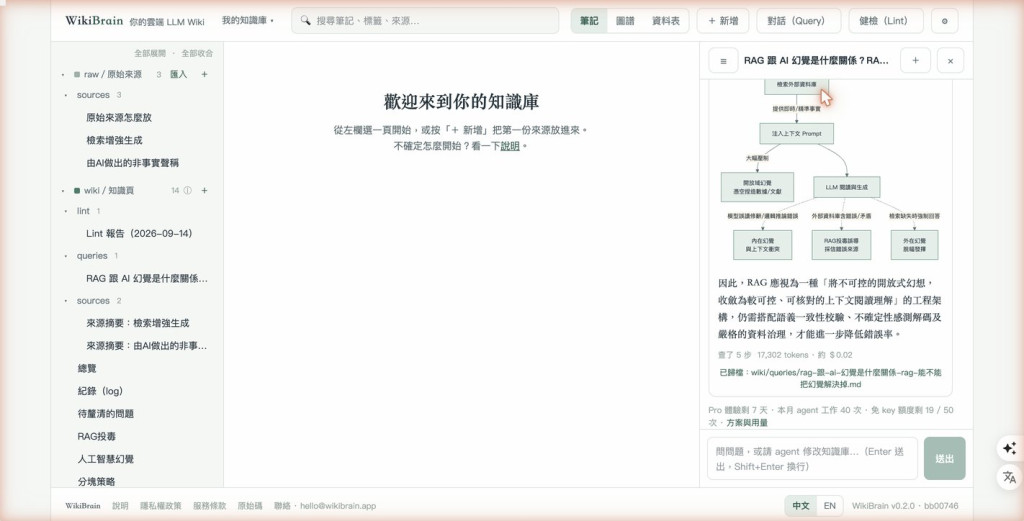
按下「存成 wiki 頁」之後,這段回答變成 wiki/queries/ 底下的一頁。
存完之後重新檢查一次健檢:孤兒頁 0、未列入目錄 0,十四頁 wiki。新生出來的那一頁沒有變成孤兒——它引用的三頁就是它的出邊,而存檔時也一併進了目錄。
兩篇維基百科條目、六次 agent 工作、$1.35——那是走網頁版、自己付 API 的價。結束時知識庫裡有十四頁互相引用的 wiki,健檢只剩一條改不了的斷連結,而那一條在唯讀的 raw/ 裡。
真正的關鍵不在哪一步做了什麼,在有沒有概念層。向量資料庫、分塊策略、RAG投毒那幾頁不是模版給的——通用模版連 concepts/ 資料夾都沒有——是模型讀完那一篇之後自己決定要拆出來的。有了它們,第二份來源才有東西可以回去改,健檢才有連結可以收,問答才有出處可以指;複利的兩個來源都長在這一層上面。
而要不要拆、拆得準不準,是模型的能力。這是整個流程裡最值得把錢花下去的一段——它決定的不是單篇摘要好不好看,是這座知識庫接下來會不會愈長愈強。


 iThome鐵人賽
 看影片追技術