
到目前為止,我們幾乎都在研究模型運行時產生的 activation。給模型一段輸入後,我們讀取 Residual Stream、訓練 Probe、進行 Activation Patching,再用 SAE、Transcoder 與 Attribution Graph 嘗試拆解這次 forward pass 發生了什麼。這些方法很有用,但它們主要回答的是模型面對這個輸入時,內部發生了什麼?
然而,模型能夠進行這些 computation,是因為訓練早已把某些結構寫進它的 weights 裡。Activation 是每次執行模型時產生的狀態;weights 則是跨越不同輸入、反覆執行同一套轉換規則的參數。如果把神經網路類比成程式:
那麼,一個很自然的問題就是:我們能不能不只分析模型執行時的狀態,而是直接從 weights 中拆出它學會的 computation?
這就是 Parameter Decomposition 想做的事情。
乍看之下,weights 似乎比 activation 更適合研究。畢竟 activation 會隨 input 改變,但 weights 是固定的。我們只要把矩陣打開來看,理論上就能找到模型真正學到的東西。問題是,一個 weight matrix 通常只是一大片密集的數字:
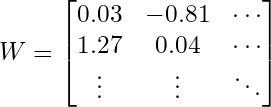
就和 activation 一樣,直接看這些數字,我們基本上看不任何東西,例如某一部分負責 factual recall。而且,模型的 mechanism 不一定剛好沿著 neuron、Attention Head 或某一整層的邊界分開。同一個 computation 可能分散在多個 layers;使用多個 weight matrices;和其他 computations 疊在同一組 parameters 中;只在特定 inputs 上真正產生作用。所以問題不是:「Weights 裡有沒有 structure?」而是:「我們應該把 weights 拆成哪些部分,才會得到真正有意義的 mechanism?」
Parameter Decomposition 的基本想法,是把原本的參數寫成許多較小 components 的總和:
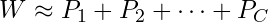
每個 (P_c) 都是一個 parameter component。理想情況下,這些 components 應該具有幾個性質。[1]
所有 components 加起來,應該能還原原模型的 weights:
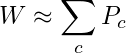
這表示我們不是另外訓練一個功能相似、內部結構卻可能完全不同的 replacement model,而是在重新分解原模型本身的 parameters。
對任何一個 input,模型應該只需要使用少量 components。例如處理 Python code 時,並不需要同時啟用所有與法文、地理或詩歌相關的 mechanisms。如果某個 component 對這次 input 沒有作用,把它拿掉後,模型輸出應該不受影響。
每個 component 應該盡可能簡單。否則我們當然可以說整個模型就是一個 component。這完全 faithful,卻沒有帶來任何理解。這個方向背後的直覺是:一個 mechanism,應該是一組相對簡單、在特定 inputs 上具有必要因果作用,而且能和其他 mechanisms 組回原模型的 parameters。
實際方法通常不會直接替每個 mechanism 儲存一整份和原模型一樣大的 weights。比較常見的做法,是先把每個 weight matrix 拆成許多 rank-one subcomponents:
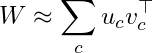
一個 rank-one matrix (u_cv_c^\top) 可以用一個很直覺的方式理解:
也就是:
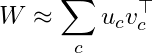
這和我們前面談到的 representation direction 很自然地接在一起。但現在我們不只是在 activation space 裡找到一條 direction,而是在找:Weights 如何讀取一種 representation,再將它轉換成另一種 representation。
2025 年,Braun 等人提出 Attribution-based Parameter Decomposition(APD)。[1] APD 會將整個模型分解成 parameter components,並估計在不同 inputs 上,哪些 components 對模型輸出特別重要。方法的核心假設是:如果一個 component 在某個 input 上沒有參與 computation,我們應該可以移除它,而不改變模型的輸出。
因此,APD 會嘗試找出:
APD 在一些具有 ground-truth mechanism 的 toy models 上,能找回被壓縮或分散在不同 layers 的 computations。不過,它的計算成本很高,也對 hyperparameters 很敏感,因此還很難直接用在真正的語言模型上。
後來提出的 Stochastic Parameter Decomposition(SPD),試圖讓這套方法更穩定、更容易 scale。[2] SPD 不直接替每個完整 mechanism 儲存一整份模型,而是先把各 weight matrices 拆成許多 rank-one subcomponents。接著,它會學習一個 causal importance function,估計每個 subcomponent 在特定 input 上有多重要。訓練時,SPD 會隨機 mask 掉不同 combinations 的 subcomponents,再要求剩下的 components 仍然重現原模型的輸出。如果拿掉某個 component 後,模型就無法完成原本的 computation,它就比較可能是真正被這次 input 使用的部分。可以把它想成:
把 weights 拆成很多小零件
↓
隨機移除不同零件組合
↓
檢查模型是否仍能正常工作
↓
學習每個 input 真正需要哪些零件
SPD 在 toy models 中比 APD 更穩定,也能更準確地找回已知的 ground-truth mechanisms。[2] 後續研究還將它用在小型 Transformer 上,找回 induction-head 的兩階段 circuit,並在 GPT-2 Small 的局部實驗中找到與 golf、basketball 等 predictions 有關的 rank-one parameter subcomponents。[3]
不過,隨機測試仍然可能漏掉問題。假設一組 components 平常可以被隨機移除,但存在某一種很特殊的組合,一拿掉就會讓模型的 computation 崩潰。如果訓練過程剛好沒有抽到這個組合,我們就可能誤以為 decomposition 是 faithful 的。2026 年 Goodfire 提出的 adVersarial Parameter Decomposition(VPD),因此把隨機 ablation 改成更強的測試:主動尋找最能破壞模型行為的 ablation combinations。也就是讓一個 adversary 嘗試挑出:「如果這套 decomposition 的故事是錯的,要拿掉哪些 components 最容易揭穿它?」
VPD 會要求模型即使面對這些 adversarially selected ablations,只要真正必要的 components 還在,就應該仍然保留原本行為。[4] 這試圖確保找到的 components 不只是在平均情況下看起來夠用。而是在各種不利的 component combinations 下,仍然形成一套穩定、可以組合的 mechanism description。
Goodfire 將 VPD 應用在一個四層、約 6700 萬參數的語言模型上,把 24 個 weight matrices 分解成數萬個 rank-one subcomponents。對每個 token position,實際需要的只占其中一小部分。[4]
研究者也能根據哪些 inputs 會使用某個 subcomponent,以及它讀寫哪些 activation directions,對部分 components 提出相對連貫的 interpretation。
一旦每個 weight matrix 被拆成較小的 subcomponents,我們就可以開始追蹤:
Subcomponent A
讀取某個 representation
↓
寫入新的 direction
↓
Subcomponent B 讀取它
↓
產生下一個 representation
↓
影響 output
這和 Attribution Graph 很像,但有一個重要差別。CLT Attribution Graph 是透過另一個 learned replacement model,近似原模型的 activation transformations。Parameter Decomposition 則直接使用原模型架構中的 parameter subcomponents。因此,它希望畫出的不只是:「一組能近似原模型行為的 feature graph。」而是:「原模型的 weights 本身,是如何組合出這段 computation?」
這也是 parameter-space interpretability 最吸引人的地方之一。
目前 Parameter Decomposition 仍然是一條非常早期的研究路線。它面臨的問題包括:
2026 年也開始出現 Targeted Parameter Decomposition:不嘗試一次拆完整個模型,而只尋找處理特定 inputs 或 tasks 的 parameter mechanisms,以降低計算成本。[5] 所以 Parameter Decomposition 現在最適合被理解成一種很有潛力、但仍處於早期階段的方向。
它提醒我們,Mechanistic Interpretability 不一定只能在 activation space 中尋找 features。真正的 neural algorithm,也許需要同時理解:
到目前為止,我們看了許多「理解」模型的視角與方法,或許還沒有太體會到「理解」能帶來的「實用」價值,而下一篇我們要講的「Activation Steering」就是最能帶來實際應用價值的 Interp 方法之一。在之前,我們一直把 Steering, Ablation, Intervention 當成一個確認 causality 的工具,但想像一下,如果我們真的找到了例如:決定「聽 system prompt 還是聽 user prompt」的 neurons, component or direction,那我們是否就可以透過調整它,在 inference time 穩定的控制模型聽誰的指令。那若是能找到更多概念的位置:「數學能力」、「推理能力」、「信心」等等,我們是否就會擁有一個強大的工具庫,在 inference time 把模型的行為調整成我們希望的樣子,且成本還很低。甚至,搭配 probing 做 monitor,我們可以做到在 agent 做 long horizon 的工作時,持續監控模型內部,並在某些資訊在內部浮現時作出干預,確保他的行為符合我們的期待。
這些正是 Steering 除了「理解」、「驗證因果性」之外能帶來的價值,也是他的應用範圍非常廣,甚至超出 Interp 和 Safety 領域的原因。接下來我們將花幾天一起探索這個令人期待,卻也還有許多未解之謎的方法。
[1] Braun, D., Bushnaq, L., Heimersheim, S., Mendel, J., & Sharkey, L., “Interpretability in Parameter Space: Minimizing Mechanistic Description Length with Attribution-based Parameter Decomposition”, 2025. https://arxiv.org/abs/2501.14926
[2] Bushnaq, L., Braun, D., & Sharkey, L., “Stochastic Parameter Decomposition”, 2025. https://arxiv.org/abs/2506.20790
[3] Christensen, C. L., & Riggs, L., “Decomposition of Small Transformer Models”, Mechanistic Interpretability Workshop at NeurIPS, 2025. https://arxiv.org/abs/2511.08854
[4] Bushnaq, L., Braun, D., Clive-Griffin, O., et al., “Interpreting Language Model Parameters”, Goodfire Technical Report, 2026. https://www.goodfire.com/research/interpreting-lm-parameters
[5] Vigouroux, A., & Sharkey, L., “Targeted Recovery of Weight-Space Mechanisms From Neural Networks”, 2026. https://arxiv.org/abs/2607.13047


 iThome鐵人賽
 看影片追技術