

用來驗收這隻需求釐清 agent 的資料集(dataset),是一筆一筆「輸入加上通過條件」的 case,公開建議的起點是 20 到 50 筆。但決定這份資料集有沒有用的不是筆數,是 case 從哪裡來,如果全部都只是挑順利的 ticket,湊到 500 筆也擋不住任何東西。
昨天提到把外面那個世界固定住之後,第一筆 case 從輸入、判定到重跑都齊了,接著就會想加第二筆、第三筆,那要加到幾筆呢?
假設現在從 Trello 上隨手挑十張卡進來。多數卡是正常的,需求寫得還可以、AC 三五條、沒有互相打架,跑完十筆全綠。
這份資料集能證明的只有一件事,這十張卡沒有問倒 agent。而 agent 會不會漏掉那條「與描述不符」,十筆裡沒有一筆問過這個問題。
更麻煩的是全綠會讓人放心,分數 100%,看起來沒有什麼要改,於是下一次 agent prompt 改動就不會有人特別去看這份分數。
Anthropic 那篇談 agent eval 的文章給的起點很小,從真實失敗裡抽 20 到 50 個簡單任務(Demystifying evals for AI agents)。理由是早期每一次系統變動的影響都很明顯,小樣本就看得出差別;等 agent 成熟、每次改動的影響變小,才需要更大更難的 eval。
Airbnb 的規模差不多,但講得更細,初期由領域專家標 50 到 100 個例子,而且必含失敗案例;等標記規則穩定、數量成為瓶頸,才擴到幾千筆(Eval-driven development)。
Anthropic 的官方測試文件還多一句反直覺的建議(Develop test cases):
Prioritize volume over quality: More questions with slightly lower signal automated grading is better than fewer questions with high-quality human hand-graded evals.
寧可多筆、訊號差一點,也不要只有少少幾筆、每一筆都要人工一條一條評分。這句話有個前提要記住,它比較的是能自動判的多筆跟要人工判的少筆。而這 30 天前面幾天做的事(把「通過的條件」寫成資料、寫成 goal state)正是為了讓「自動判」這一邊成立。
不是挑十張卡,是照分類去補格子。前面分出來的五類會出錯的 ticket 就是格子,該分開的混在一起、該有的沒有、說法不一致、字太多重點太少、叫它去做收不回的事。
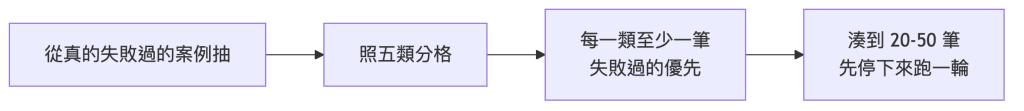
每一格至少一筆,而且優先放真的失敗過的那幾筆。失敗過的 case 一開始就是紅的,擋不擋得住問題當場就確認過了;從紙上想出來的 case 最好的情況是它剛好也會失敗。
五類補完,分類那天列的 10 條候選差不多就填掉了。剩下的名額補正常的卡,因為還要看 agent 會不會在乾淨的輸入上多標一堆不存在的問題。
因為一份全過的資料集沒有判別力(discriminative power)。
判別力是這樣看的,拿一個明顯壞掉的 agent 版本跑這份資料集,分數應該要掉。如果分數不掉,那不是產品好,是這份資料集問不出問題。
檢驗方法很直接,拿現在的 agent,把 system prompt 裡「每一條 AC 對三類問題各檢查一次」那句指示刪掉,其他一個字不動,再跑一次,分數要掉。要是分數一動也不動,那今天湊的這批就白湊了。
這隻 agent 的 system prompt 全文如下,在 repo 的 src/agent/prompt.ts,一行一條指示,改動才能是一行的 diff:
你是需求釐清 agent。你的工作是把需求方寫的雜亂 ticket 整理成結構化的 ticket,並標出 AC 裡有問題的那幾條。

四個步驟:
1. 拆 description:哪句講目標、哪句畫範圍、哪句其實是其他 ticket 的事
2. 查背景:需要什麼就用對外查資料的工具去查,查幾次由你決定
3. 逐條檢查 AC
4. 寫回去:用 update_ticket 把結果寫回卡上

每一條 AC 對三類問題各檢查一次

三類問題:
- conflict:這條 AC 跟另一條互相打架
- unverifiable:這條 AC 沒有寫清楚怎樣算做完
- mismatch:這條 AC 跟 description 說的不一樣

整理後的卡有四個區塊,全部用 update_ticket 寫回:
- goal:這張卡要做什麼,一句話
- scope_in:做的範圍,一項一個字串
- scope_out:不做的範圍,一項一個字串
- ac_flags:標註,每個標註是 { ac: 條號, type: 類別 }。同一條 AC 可以有多個標註。

規則:
- scope_in 與 scope_out 是字串陣列,不要把好幾件事塞進同一個字串
- 不要覆寫需求方寫的 AC 原文
- 寫回去之後就結束,不要再呼叫工具
判別力檢查刪的就是第 9 行那一句,變體存成另一個檔案,用 --prompt 旗標指定,原本的 prompt.ts 維持不變。
原版與刪掉那一行的版本,對那張優惠碼的卡各跑了三次,分數確實掉了,但掉的地方跟原本推的不一樣。原本推的是最先掉「與描述不符」,實際上那一格在原版三次就全漏了,沒有空間再掉,掉的是「不可驗證」那一類,第 7 條從三次漏一次變成三次全漏。
作者標的 4 個標註,三次合計 12 個,原版 agent 標到 8 個,刪掉那一行之後只標到 5 個。而 case 有沒有通過這個數字,兩邊都是三次全失敗,對這次改動完全沒有反應。
也就是說,判別力檢查如果只看 case 通過率,會得到「沒差」的結論。要看得出這份資料集有沒有回應,得把標註一個一個對。
這是「多筆優先」那句建議套在這隻 agent 身上的代價,一筆 case 不只是一張卡。
一筆完整的 case 要三樣東西,整份輸入原文、這筆通過的條件、以及第一次真跑錄下來的 fixture。前兩樣要人寫,第三樣要真的連出去查一次。
而「這筆通過的條件」裡最花時間的一格,是把這張卡上哪幾條 AC 有問題、各是哪一類,一條一條寫下來。那組答案是人讀完卡片自己判的,不是 agent 給的,這種人手寫下來的答案叫標註(annotation)。後面要量這隻 agent 標得準不準,靠的就是拿它標出來的東西對上這一組。
所以 20 筆的意思是 20 次「讀懂一張卡、想清楚它整理完該長什麼樣、把條件一條條寫下來」。一個人一個下午做不完 20 筆。往上加到 50,人工標註的量大概就是上限了。
第一批 case 的起點是 20 到 50 筆,但筆數不是重點,來源才是。照五類會出錯的 ticket 補格子,每一格至少一筆,真的失敗過的優先,剩下的名額補幾張正常的卡,看 agent 會不會多標不存在的問題。
這份資料集有沒有用,用判別力檢查,把「每一條 AC 對三類問題各檢查一次」那句指示刪掉再跑,分數要掉,而且要把標註一個一個對著看,case 通過率對這種改動可能完全不動。每一筆的成本是人讀懂一張卡、寫下通過的條件、真跑一次錄 fixture,一個下午做不完 20 筆,人工標註的上限大概在 50 筆。


 iThome鐵人賽
 看影片追技術