

一筆 case 分成輸入和答案兩部分,輸入可以讓 AI 模型產生,把一張已經標好的卡改寫成問題相同的另外幾張;答案要人自己寫,包括這筆通過的條件、goal state,還有人工標出來的那三類 AC 問題。
這 30 天要驗收的對象是一隻需求釐清 agent,它讀進需求方寫的雜亂 ticket,整理成結構化的 ticket,輸出分成四個區塊,Goal(這張卡要做什麼)、Scope in(做的範圍)、Scope out(不做的範圍)、AC 標註,並標出有問題的那幾條 AC。
要知道 agent 做對了沒有,得先有一份自己標好的資料集,而這份資料集是一筆一筆人工寫出來的,開一個新檔案、把整張卡的原文貼進去、寫下這筆通過的條件,存檔,換下一張。做到第五筆,自然會想讓模型代寫剩下的,反正它產生文字很快。
這份資料集第一批的目標是 20 到 50 筆。把要求講清楚,20 筆很快就會回來,20 張雜亂的卡,每一張後面跟著一份整理好的答案,欄位齊全、格式一致,比手寫的整齊。
麻煩在這 20 份答案沒有辦法驗證,要確認那份答案對不對,只能人再讀一次那張卡、自己整理一遍,再跟它給的擺在一起比,而這正是原本想省掉的那件事。省下來的只有打字的那幾分鐘。
順序不能反過來,整理完該長什麼樣要先定下來,才問得出它做到了沒有。讓模型先產出一份答案、再宣布那份答案就是標準,等於看它產出什麼、再回頭說那就是對的。
那張優惠碼功能的 ticket 是現成的例子。它有 7 條 AC,第 2 條寫「優惠碼一人只能用一次」,第 3 條寫「優惠碼可以無限次使用」。
人第一遍逐條讀完只數出 3 個標註,第二遍回頭讀 description,才發現第 3 條同時也違背 description 裡「不要被亂用」那句,標註從 3 個變 4 個。
讓模型寫這份答案,它第一遍會寫出幾個?三類 AC 問題裡,彼此衝突與無法驗證在 AC 清單裡面就看得出來,與描述不符要回頭把 description 再讀一次,而回頭再讀一次,正是被驗收的那隻 agent 最容易省掉的一步。
產生答案的模型跟被驗收的 agent 共用同一個弱點,於是那份答案剛好漏掉最該問的那一條。agent 漏了一條的那一次,答案裡本來也沒有那一條,兩邊對得上,分數是滿的。
一份寫錯的判斷標準至少會亮紅燈,做對的那一次被判成失敗,總有人會去查。一份少了一條的答案什麼都不會亮,它只會讓分數一直很好看。
會讓這隻 agent 出錯的 ticket 分五類,分法是照它會弄壞哪一步,該分開的混在一起、該有的沒有、說法不一致、字太多重點太少、叫它去做收不回的事。每一類至少要有一張卡,而真的壞過的那幾張通常湊不滿所有格子。
缺的格子可以叫模型補,做法是給它一張已經標好的卡,要它保留同一個問題,換掉領域、換掉措辭、把篇幅拉長一倍。優惠碼換成退款流程,AC 從 7 條變成 12 條,打架的那兩條分開藏在中間。
這樣做安全,因為輸入不需要正確,只需要夠壞。改寫得不對,人讀一遍就看得出來,問題不見了,或者變成另外一類。
repo 的 dataset/ 裡現在有 15 筆這樣產生的變體卡,每一類三筆。說法不一致那一類的第一筆長這樣(原檔):
id: conflicting-truth-001
source: Day 8 第 5 條:AC 彼此衝突
category: conflicting-truth
input:
  name: 問卷填答
  description: |
    活動問卷開放填寫,填完送出就可以領獎品。
  acceptance_criteria:
    - 使用者填完問卷送出後可以領取獎品
    - 同一個帳號只能填寫一次
    - 使用者可以重複填寫更新答案
    - 問卷關閉後不能再填寫
# goal_state 待作者手標
第 2 條跟第 3 條打架,跟優惠碼那張卡同一個問題,換了領域。最後那行註解是重點,goal_state 空著,等人來填,模型產生的只到 input 為止。
分界線的依據只有一件事,模型產生的東西如果錯了,會不會有人發現。
一筆 case 帶三樣東西,整份輸入原文、這筆通過的條件、以及第一次真跑時把外部回應原封不動錄下來的那份檔案(fixture)。這隻 agent 有 4 個工具只負責對外查資料,search_repo 是其中一個,fixture 存的就是它們那一次回了什麼。
通過的條件要寫成一份可以逐格擺在旁邊對的資料,也就是這筆 case 的 goal state。
| 一筆 case 的三樣東西 | 能不能讓模型產生 | 產生錯了會怎樣 |
|---|---|---|
| 整份輸入原文 | 可以,人要重讀一遍 | 讀得出來,問題不見了或換了一類 |
| 這筆通過的條件(goal state、那三類 AC 問題) | 不行 | 沒有訊號,這筆永遠是綠的 |
| fixture | 不行,要真跑一次錄下來 | 這筆 case 測的是一個不存在的世界 |
fixture 那一列值得多講一句,它存的是 search_repo 那次真的查到的檔案和片段,模型可以憑空寫出一份很像的搜尋結果,檔名、程式碼都有,但那個 repo 裡沒有那段東西。這筆 case 會跑得很順,也什麼都證明不了。
順位排在最後,模型產生的卡常常壞得太整齊,打架的兩條擺得很近、感想式的 AC 一眼就認得出來,像教科書裡的例題。真實的卡不是這樣壞的,問題埋在 500 到 2000 行的敘述裡,讀到第二遍才浮出來。
所以順序是真的壞過的那幾張優先,剩下的格子才用模型產生的補。而且產生的每一張都要人重讀一次,決定它屬於哪一類,再親手寫下它的 goal state。
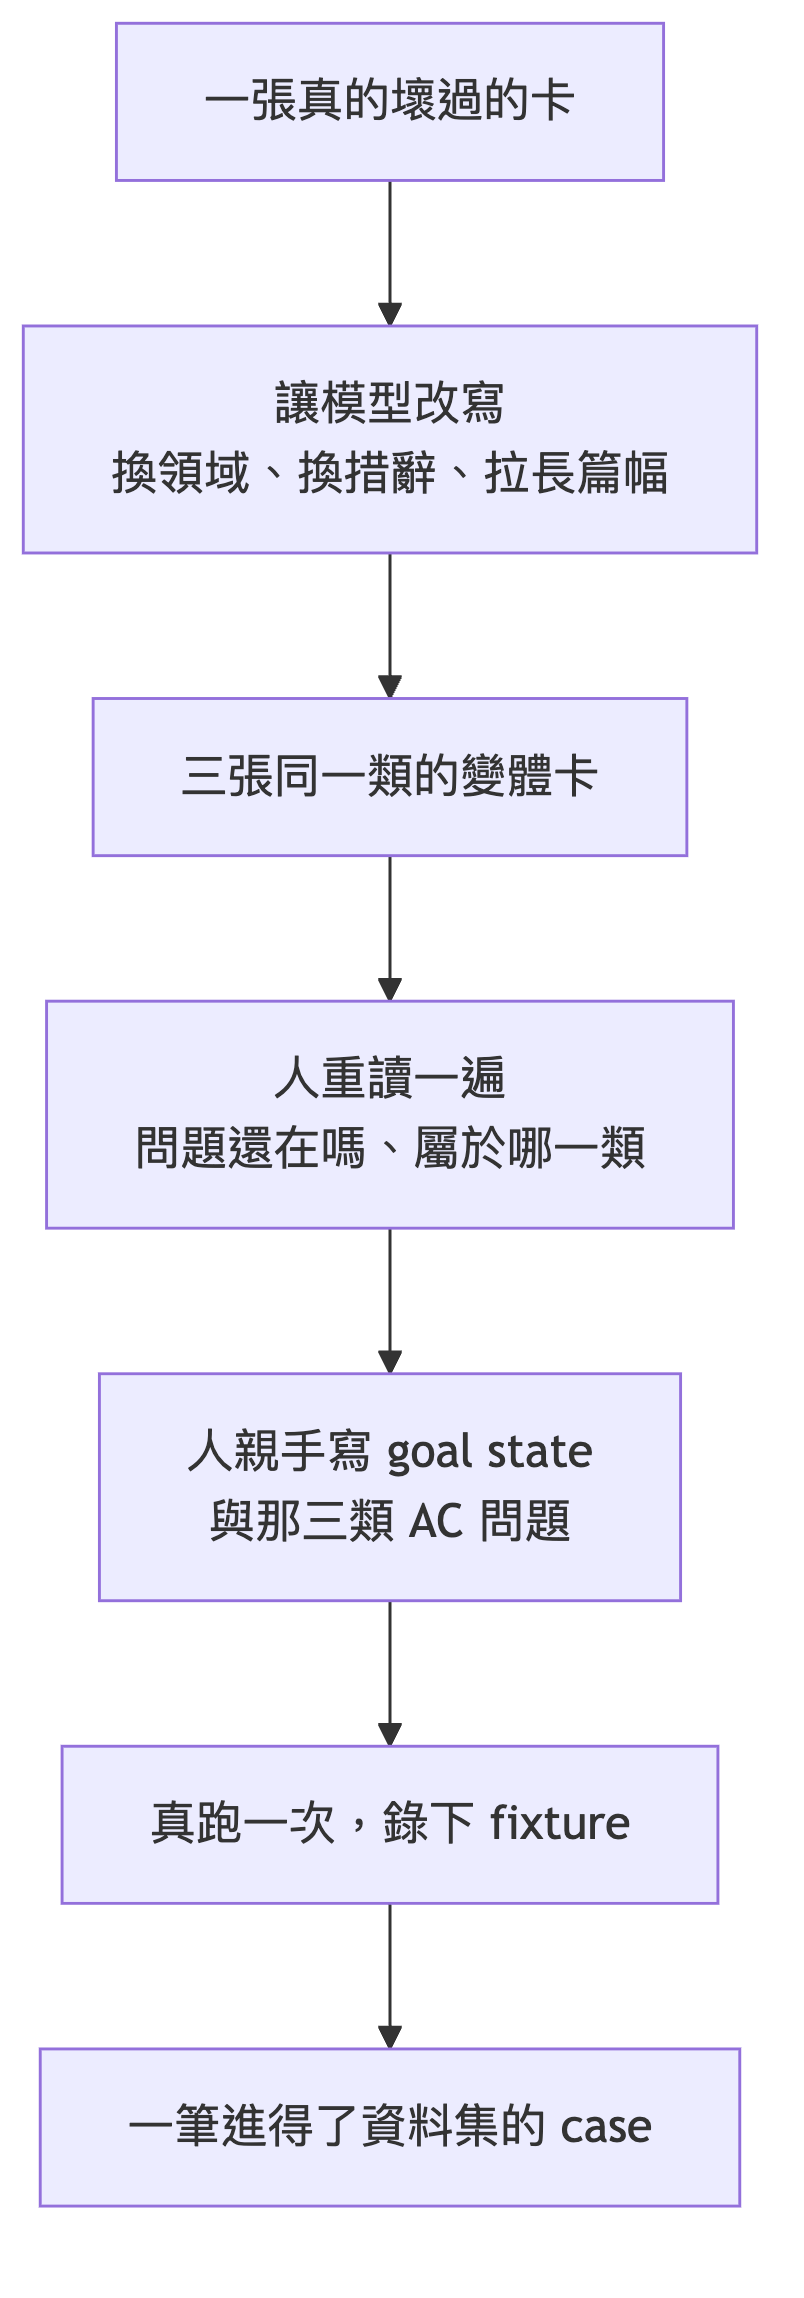
20 筆的力氣沒有省掉,模型省掉的是找卡片跟打字,讀卡跟寫答案還是人的工作。
補資料集的苦工,模型只能分擔輸入這一部分,給它一張標好的卡,要它保留同一個問題、換領域、換措辭、拉長篇幅,產生的每一張人重讀一遍,決定屬於哪一類。
答案還是要人自己寫,通過的條件、goal state、三類 AC 問題要人親手寫,因為產生答案的模型跟被驗收的 agent 共用同一個弱點,漏掉的會是同一條,而少了一條的答案不會亮紅燈。fixture 同樣不能由模型產生,因為模型編得出一份很像的工具查詢結果,而那段程式碼在 repo 裡不存在,只能真跑一次錄下來。


 iThome鐵人賽
 看影片追技術