

Day 7 的任務描述很完整,但這是否真的比較有效?今天不靠直覺回答。我會用同一個起始版本、同一個功能和同一組驗收案例,比較模糊指令與結構化指令。真正要看的不是 Prompt 長短,而是它是否減少需求誤解、額外修改與人工修正。
實驗任務選「刪除任務前需要確認」。A 版只寫:「幫我加刪除確認。」B 版寫:「在目前任務清單的刪除動作前顯示確認步驟;取消後資料與畫面都不變;確認後只刪除目標任務;刪除失敗要提示且不可假裝成功。先讀現有流程,保持既有 UI 風格,只改必要檔案,補相關測試並回報 diff。」
兩份指令必須從同一個 commit 或等價的乾淨工作目錄開始,否則第二次執行可能因第一次留下的檔案而佔便宜。模型、工具權限與驗收人也盡量保持一致。若無法控制某個條件,就寫進紀錄,不能把差異全歸因於 Prompt。
先看需求覆蓋:取消、確認、刪除失敗三種情境是否都處理。再看修改範圍:改了幾個必要檔案、是否引入不相關重構。最後看驗證:測試有沒有跑、手動操作有沒有發現問題、我補了幾輪訊息才達到標準。時間也會記,但不是唯一勝負,因為快做錯通常比慢做對更貴。
Prompt 寫得細,不保證結果一定好。若 B 版因限制過多而忽略 Repository 現有模式,仍可能做出難維護的實作;A 版也可能碰巧一次成功。因此我會展示兩份完整輸入與輸出摘要,讓讀者自己檢查,而不是只放最後分數。
我不會在 B 版裡偷偷放入只有它知道的答案,例如確切檔名或程式碼行號,除非那是實驗要比較的變因。評估時也不能只挑 B 版優勢:若 A 版修改更少、測試同樣通過,就要如實寫出。更重要的是紀錄第一次交付,不能把兩邊都修到完美後才拿最後版本比較。
兩版都應由相同的人用同一張驗收表檢查,並保存原始 diff。若其中一版因網路、套件安裝或服務故障無法完成,那是環境干擾,不宜計成 Prompt 的失敗。把不可控因素記下來,實驗才能重做,也才有討論價值。
我會把有效的部分收斂成五欄:「目標」說明使用者要得到的行為;「範圍」說明哪些地方可改、哪些事不做;「驗收」列出成功與失敗案例;「限制」指出既有介面、安全或資料邊界;「回報」要求 diff、測試指令與未解決問題。對極小修正可以縮短,但不要省掉最關鍵的驗收。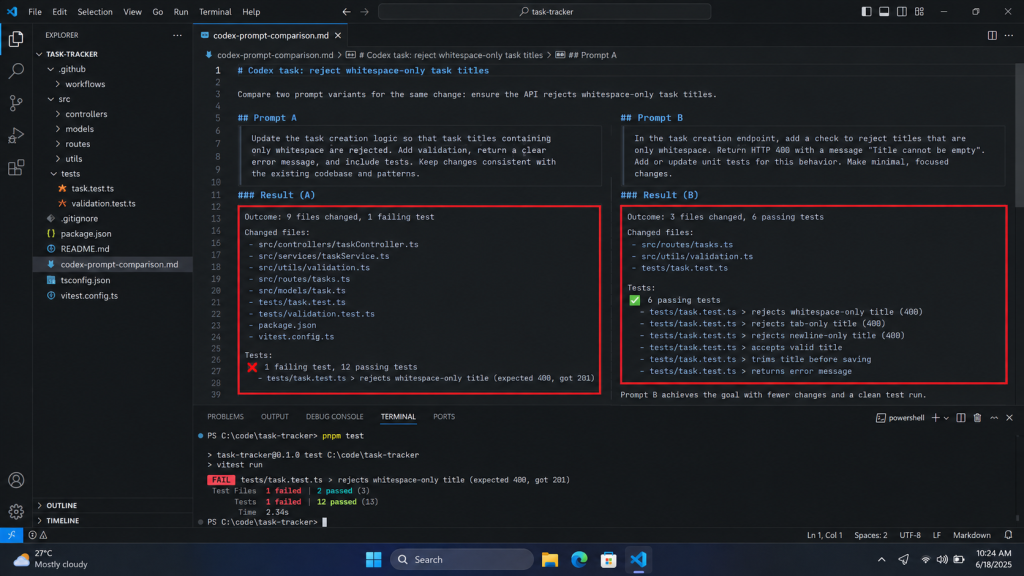
目前完成的是控制條件、兩份原始指令與比較標準。尚未跑同一 Repository 的 A/B 實驗,因此不會在此宣稱結構化 Prompt 降低了多少錯誤。之後補上實際 diff 和失敗案例,才能決定模板哪些欄位值得保留。
好的 Prompt 不是把所有細節塞滿,而是把會改變驗收結果的資訊放在可見處。明天進一步撤掉「告訴 AI 去改哪個檔案」這個提示,看看它能否自己找到程式入口。


 iThome鐵人賽
 看影片追技術