
系列:從單一 Agent 到 Supervisor 架構:用 n8n 實作會自己分工的 Multi-Agent AI 部門
談到 AI 客服,最常見的需求大概就是這一句:「信太多了,能不能讓 AI 先回?回不了再給人。」
常見的做法也差不多:開一個 AI Agent,把訂單資料、FAQ、退貨規則、語氣規範全部塞進 System Prompt,讓它讀信、查單、回信。Demo 的時候很漂亮,真的上線以後,prompt 就開始越寫越長。分類規則、客訴要轉人工、不准給折扣、禁用詞清單,全部擠在同一份 prompt 裡。改一條規則,另一個原本正常的案例就壞掉。
今年鐵人賽想好好回答一個問題:同一件事,拆給多個 Agent 分工,到底有沒有比一個 Agent 好?好在哪裡?要付出什麼代價?
為了讓每個實驗都能重現,我設定了一間虛構的線上咖啡豆電商「好豆選物」,資料都照真實電商的樣子設計:24 筆訂單、10 位客戶、20 條 FAQ,還有一份客服語氣規範。
客服信箱會收到的信大概是這幾種:
另外我寫了 50 封評估信,每一封都先訂好標準答案:這封是什麼意圖、該回信還是該轉人工、回信裡一定要提到什麼、絕對不能出現什麼。之後每一個版本的系統,都用同一份評估信打分數。
動筆之前,我先把最直覺的版本做出來:一個 AI Agent、一份 prompt、一個查訂單的工具,然後把 50 封評估信全部丟進去。
| 結果 | 封數 |
|---|---|
| 完全正確 | 26 |
| 部分正確(漏資訊或多轉人工) | 14 |
| 失敗 | 10 |
意外的是這個結果比我預期的好,而且它查單很準,也沒有亂編訂單編號。
但逐封讀完回信之後,讓我覺得非拆不可的,反而是那些「看起來很正常」的信。其中有 13 封,它回了「我這邊幫您確認後回覆您」或「後續將有專人與您聯繫」,卻沒有標註要轉人工。放在真實流程裡,這些信寄出去之後不會有任何人收到通知,客人只會一直等。
這部分在 Day 06、Day 07 會詳細拆解說明。
終點是一個「AI 客服部門」,編制是 1 位主管加 3 位專員: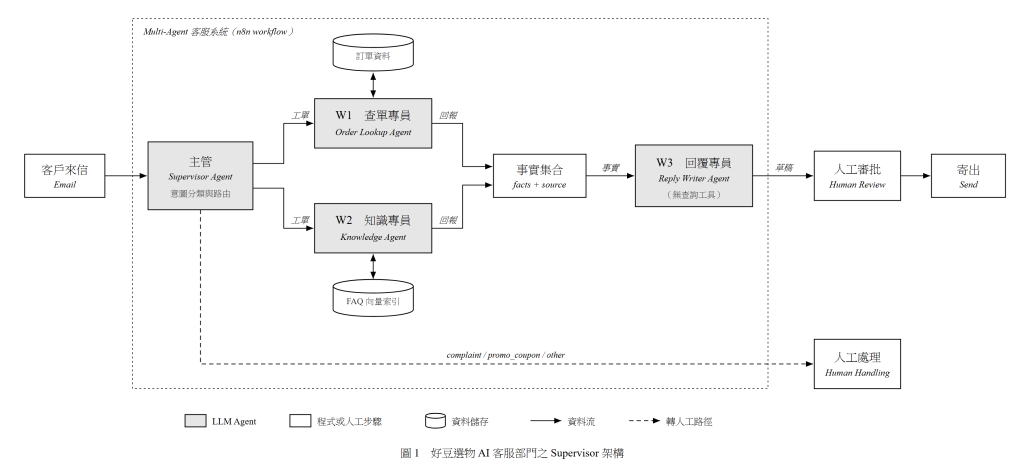
| 角色 | 負責 | 刻意不讓它做的事 |
|---|---|---|
| Supervisor 主管 | 讀信、判斷意圖、決定派工、驗收 | 查資料、寫回信 |
| W1 查單專員 | 從訂單資料查出事實,並標明出處 | 回答商品知識、寫信 |
| W2 知識專員 | 從 FAQ 找答案,找不到就回報找不到 | 猜答案、查訂單 |
| W3 回覆專員 | 只用給定的事實,寫出符合品牌語氣的信 | 查資料、自己補事實 |
客訴、議價這類信,主管判斷完就直接交給人,不會進到任何會寫回信的 Agent。W3 手上沒有任何查詢工具,所以它在架構上就沒辦法自己編出一個訂單狀態,這將是整個設計最重要的地方。
Day 28 會用同樣 50 封信,讓單兵 Agent 和這個部門正面比正確率、成本和延遲。先講清楚:多 Agent 不會每一項都贏,所以最後一天的主題是「什麼時候不該用 Multi-Agent」。
整個系列都在同一個環境實際跑過:
| 項目 | 版本或設定 |
|---|---|
| n8n | 2.38.7,Docker Desktop |
| 電腦 | Windows 11 筆電,Core Ultra 7 155H、16GB RAM、沒有獨立顯卡 |
| 主要模型 | Ollama Cloud 的 gemma4:cloud |
| 本機小模型 | qwen3.5:0.8b |
| 向量模型 | nomic-embed-text、bge-m3 |
| 訂單資料 | n8n 內建的 Data table |
選 Ollama 是因為讀者不用先綁信用卡就能跟著做。用 OpenAI、Anthropic 或 Gemini 的朋友,把 Chat Model 節點換掉就好,其他設定都一樣。
批次跑實驗時,我不是真的從 Gmail 收信,而是用 Webhook 把測試信送進 n8n。這樣同一封信可以重複跑很多次,每次的輸入都一模一樣,比較結果才有意義。
| 週次 | 主題 | 產出 |
|---|---|---|
| 第 1 週 | 觀念與單兵 Agent | 能跑的單兵 Agent,以及它不夠用的證據 |
| 第 2 週 | Supervisor 理論與三位專員 | 三個能單獨測試的專員,加上資料交換格式 |
| 第 3 週 | 派工系統 | 三種派工做法的實測比較、驗收與退件 |
| 第 4 週 | 可靠性 | 上下文交接、記憶、容錯、人工審批、成本 |
| 第 5 週 | 對決與收官 | 50 封評估信正面對決、攻擊測試 |
文章裡的數字都寫清楚跑了幾次、用哪個模型;貼出來的 prompt 和 Code 節點都是實際執行過的版本;原本的預期被實驗推翻,就照實寫出來。
需要準備:Docker Desktop、Ollama(或任何一家 LLM 的 API Key),以及大約半小時把環境架起來。不會寫程式也沒關係,少量的 JavaScript 我都會整段貼出來,直接複製進 Code 節點就能用。
明天會分別說明:單一 Agent、單一 Agent 加Tools、Multi-Agent,這三件事很常被混在一起講,先了解釐清每個的差異,後面的討論才不會一頭霧水。


 iThome鐵人賽
 看影片追技術