
昨天定下階層式架構,今天把主管要做的事寫成具體規格:分類表、派工單、專員回報格式,以及一個案件從進來到寄出的狀態變化。第三週實作派工系統時,就照這份規格走。
Day 06 那封轉寄信提醒我,真實的信件大多是雜訊。所以主管要做的第一件事是整理,判斷放在後面。以 Day 06 的 T03 為例,主管要輸出:
{
  "intent": "order_status",
  "intent_confidence": 0.95,
  "secondary_intents": ["product_qa"],
  "needs_human": false,
  "human_reason": "",
  "sentiment": "neutral",
  "clean_question": "詢問訂單 A10294 是否出貨,以及淺焙豆能否做冰滴",
  "verbatim_question": "想問 A10294 出貨了嗎?另外淺焙的豆子可以做冰滴嗎?",
  "extracted": { "order_id": "A10294" },
  "questions_asked": ["A10294 是否已出貨", "淺焙豆能否做冰滴"]
}
補充說明幾個欄位:clean_question 是去掉轉寄內容、簽名檔和行銷區塊後的一句話,之後交給專員用;verbatim_question 保留客人的原句,Day 22 會實測它對檢索到底有沒有幫助;secondary_intents 記錄同一封信裡的第二個問題;questions_asked 列出客人總共問了幾件事,之後可以拿來檢查回信有沒有漏答。
這張表是整個系統的基準,Day 27 的評估信也照它評分:
| intent | 判斷依據 | 需要人工 |
|---|---|---|
| order_status | 問到貨時間、出貨進度、物流編號、訂單狀態 | 否 |
| product_qa | 問烘焙度、沖煮、保存、器材規格,或出貨、運費、付款等一般政策 | 否 |
| return_refund | 退貨、換貨、退款、商品瑕疵、保固維修 | 是,仍會查資料寫草稿,但一定要人審 |
| complaint | 情緒明顯不滿、要求賠償、提到申訴或負評 | 是 |
| promo_coupon | 問折扣碼、優惠活動、議價 | 是 |
| other | 以上都不是,或判斷沒把握 | 是 |
這張表背後有幾個取捨。
退貨需要同時查訂單和政策。能不能退,要看「哪天送達、買了什麼」加上「退貨規定」,Day 07 的 EV32 就是只套了政策、沒查訂單而出錯。
優惠類直接交給人。與其在 prompt 裡叮嚀模型「不要給折扣」,不如讓這類信根本不會進到會寫回信的 Agent。能用架構擋下來的,就不要只靠 prompt。
沒把握就歸到 other。模型不確定時需要一個合法的去處,否則它會勉強挑一個看起來最接近的意圖。
派給誰由程式依分類結果決定:
| 條件 | 路線 |
|---|---|
| intent 是 complaint、promo_coupon 或 other | human,不派工 |
| 需要查單,也需要知識 | both,兩位專員都派 |
| 只需要查單 | order |
| 只需要知識 | knowledge |
「需要查單」指 intent 是 order_status 或 return_refund,或 secondary_intents 包含 order_status;「需要知識」指 intent 是 product_qa 或 return_refund,或 secondary_intents 包含 product_qa。
另外加一條保險:主管抽出的訂單編號,必須真的出現在信件內容裡,否則當作空白。這樣可以擋掉模型自己猜一個編號的情況。
派工時交給專員的,是一張欄位明確的工單:
{
  "task_id": "c_EV13_w1",
  "question": "查出訂單 A10294 目前的狀態與預計到貨時間",
  "order_id": "A10294",
  "customer_email": "lee@example.com",
  "need_csv": "status,carrier,tracking_no,eta",
  "attempt": 1
}
寫工單時我會把握幾個原則。question 寫要查什麼,不寫怎麼查,工具怎麼用是專員的事。need_csv 列出需要回報的欄位,專員才知道做到哪裡算完成。只傳必要的資訊,不把整封信丟給專員,Day 22 會實測差異。attempt 記錄第幾次嘗試,退件重做時可以換做法,也能防止無限重試。
三位專員共用一份回報格式,主管只需要一套驗收邏輯:
{
  "task_id": "c_EV13_w1",
  "worker": "order_lookup",
  "status": "ok",
  "confidence": 1,
  "facts": [
    { "key": "status", "value": "packing(備貨中)", "source": "orders!A10294" },
    { "key": "eta", "value": "2026-09-17", "source": "orders!A10294" }
  ],
  "answer": "訂單 A10294 目前備貨中,預計 2026-09-17 到貨。",
  "missing": [],
  "notes": ""
}
status 只允許五種值:
| status | 意義 | 後續處理 |
|---|---|---|
| ok | 查到了 | 收下 facts |
| not_found | 查過了,資料不存在 | 列入 unresolved,回信誠實交代 |
| insufficient_info | 缺少必要資訊,沒辦法查 | 請客人補資料 |
| partial | 只查到一部分 | 收下查到的部分,缺的列入 unresolved |
| error | 工具或系統出錯 | 交給人 |
not_found 和 insufficient_info 一定要分開。前者的意思是「答案是沒有」,後者是「沒辦法查」。兩者混在一起,客人就會收到「查無此訂單」,但真正的原因其實是他沒提供編號。
驗收時最有效的一條規則是:facts 裡沒有 source 的資料一律丟掉。這條由程式執行,不交給模型判斷。
一個案件從收到信到寄出,會經過下圖這幾個狀態。
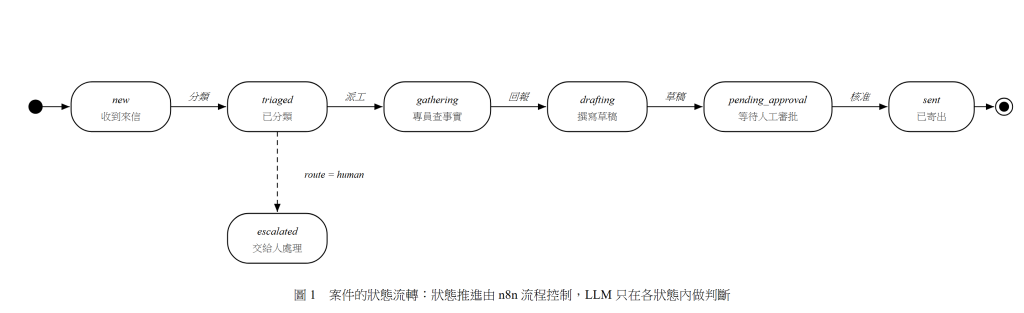
需要特別說明的是:狀態怎麼往下走,是由 n8n 的節點連線決定的,不是由 LLM 決定。LLM 只在每個狀態裡做判斷,例如分類、查資料、寫草稿。如果讓 LLM 自己決定「現在該進到哪個狀態」,整個系統的行為就很難預測。
| 步驟 | n8n 節點 | 實作在 |
|---|---|---|
| 分類 | AI Agent 加 Structured Output Parser | Day 17、Day 18 |
| 檢查分類結果、決定路線 | Code | Day 18 |
| 派工 | Switch 加 Execute Workflow,或 Call n8n Workflow Tool | Day 16、Day 18 |
| 查事實 | 查單專員、知識專員各自的 workflow | Day 11、Day 12 |
| 寫草稿 | 回覆專員的 workflow | Day 13 |
| 驗收 | Code 做規則檢查,必要時再加 LLM | Day 21 |
| 人工審批 | Wait 節點,或 Gmail 的 Send and Wait | Day 25 |
驗收的第一層刻意用 Code 節點。「facts 有沒有 source」「字數有沒有超過」「有沒有出現禁用詞」,都是程式一行就能判斷的事,交給 LLM 做又慢又貴,結果還不穩定。LLM 只負責語意層面的檢查,例如回信有沒有真正回答到客人的問題。
主管的規格包含四個部分:把信件整理成結構化欄位、依六種意圖分類、用程式規則決定派工路線、用共用格式驗收專員回報。其中客訴、優惠、其他三類直接交給人,而狀態怎麼推進由流程控制,LLM 只負責在每一步做判斷。
明天談專員的設計:一位專員該管多寬、工具要給多窄、要不要給記憶。


 iThome鐵人賽
 看影片追技術