
第二週開始。在動手做專員之前,先把架構想清楚:多個 Agent 要用什麼方式組織起來?
以下有四種常見的拓樸。它們最大的差別,在於「由誰決定下一步」。
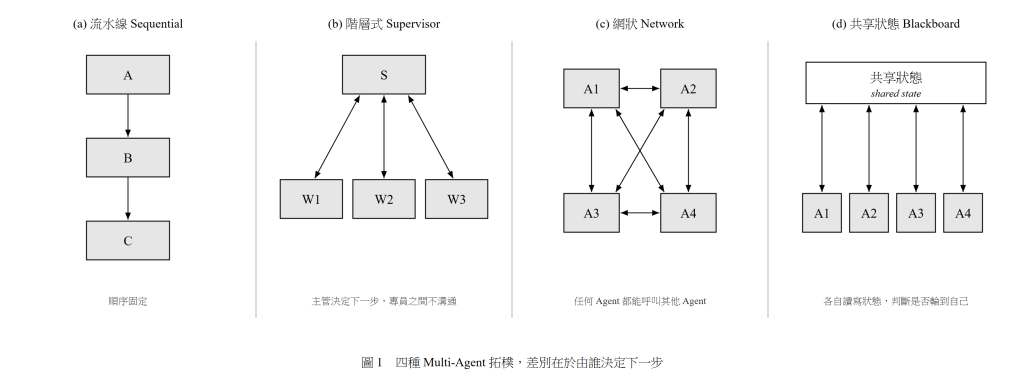
A 做完交給 B,B 做完交給 C,順序固定。
好處是完全可預測、成本最低、最好除錯;缺點是不會依內容調整路線。套到客服情境,就算客人只問咖啡豆怎麼保存,信也得先經過查訂單那一關。
CrewAI 的 Process.sequential,或 n8n 裡把幾個 AI Agent 直接串成一條線,都屬於這一類。適合流程本來就固定的工作,例如「擷取、翻譯、摘要」這種文件處理。
一位主管決定要派給誰、派幾位、要不要重做。專員只跟主管溝通,專員彼此之間不直接呼叫。
好處是路線可以依內容變化,出錯時知道是哪一位出了問題,加一位專員也不會影響其他人;缺點是主管判斷錯了,後面就全部跟著錯。
LangGraph 的 langgraph-supervisor、CrewAI 的 Process.hierarchical 都是這個模式。好豆選物這個系列採用的也是它。
每個 Agent 都能呼叫其他任何 Agent,由當下的 Agent 自己決定交給誰。OpenAI Agents SDK 的 handoff、AutoGen 的群組對話,用法接近這一類。
彈性最大,但也最難控制。兩個 Agent 很容易你推給我、我推給你,成本也難以預估。比較適合探索型的任務,例如研究或腦力激盪,客服這種要求穩定的場景我不建議。
沒有指揮者。所有 Agent 讀寫同一份狀態,各自判斷現在是不是輪到自己。LangGraph 的 StateGraph 以一份共享 state 為核心,概念上接近這一類。
好處是高度解耦,容易平行處理;前提是狀態要定義得非常嚴謹,否則很快就會亂成一團。
最直接的原因是客服信件的路線本來就不固定。純知識問題只需要知識專員加回覆專員,查單需要查單專員加回覆專員,退貨兩位專員都要,客訴則直接交給人。流水線做不到這種分岔。
第二個原因是除錯。Day 07 分析單兵 Agent 時,我只能一封一封讀回信,猜它在哪一步想錯。拆成主管和專員之後,每一位的輸入輸出都分開記錄,錯在哪一段一目了然。
第三個原因是權限。回覆專員沒有任何查詢工具,它能用的資料全部由主管提供,這在階層式架構下很自然就能做到。
主管的工作可以拆成四步:理解信件、決定需要哪些子任務、派工、驗收回報。
同樣重要的是劃清它不做的事:不自己查訂單、不自己寫回信、不直接跟客人溝通。LLM 很容易有「我自己來比較快」的傾向,這個界線在 Day 17 寫主管的 prompt 時會是重點。
單兵 Agent 的狀態就是那一串對話紀錄。拆成多個 Agent 之後,每個 Agent 的對話都是分開的,必須有一份在 Agent 之間傳遞、欄位定義清楚的資料。
我把它稱為「案件」(Case),一封信進來就建立一個。以 Day 06 的 T03 為例:
{
  "case_id": "c_EV13",
  "from_email": "lee@example.com",
  "intent": "order_status",
  "secondary_intents": ["product_qa"],
  "needs_human": false,
  "sentiment": "neutral",
  "clean_question": "詢問訂單 A10294 是否出貨,以及淺焙豆能否做冰滴",
  "order_id": "A10294",
  "route": "both",
  "facts": [
    { "key": "status", "value": "packing(備貨中)", "source": "orders!A10294" },
    { "key": "roast_guide", "value": "淺焙適合手沖、冰滴、冷萃", "source": "faq![BEAN-02]" }
  ],
  "unresolved": [],
  "draft": null
}
每個欄位都對應到 Day 07 找到的問題:
| 欄位 | 用途 | 對應 Day 07 的問題 |
|---|---|---|
| intent、route | 決定要派給誰,也是評估分類準不準的依據 | 優惠類、其他類照常回信 |
| needs_human | 轉人工變成布林值,流程可以直接判斷 | 承諾後續卻沒人跟進 |
| facts | 每一筆事實都附上 source | 套錯規則、暗示不存在的優惠 |
| unresolved | 查不到的事明確列出,回信要誠實交代 | 承諾後續卻沒人跟進 |
facts 的 source 是我覺得整個設計裡最實用的地方。有了它,「這句話有沒有依據」就變成程式可以檢查的事,不需要人去讀信判斷。
n8n 沒有現成的狀態物件。一種做法是讓案件 JSON 跟著 item 在節點之間流動,用 Code 節點逐步補欄位,好處是在 Execution 裡看得一清二楚;另一種是存進 Data table,每一步讀寫,好處是能跨 workflow、能保存。
這個系列兩種混用:主流程裡的案件跟著 item 流動,之後的人工審批和案件歷史才寫進 Data table。
不一定。「理解信件」一定需要 LLM,但如果意圖種類是固定的,「派給誰」完全可以用 n8n 的 Switch 節點寫死:
| intent | 派給誰 |
|---|---|
| order_status | 查單專員,再交給回覆專員 |
| product_qa | 知識專員,再交給回覆專員 |
| return_refund | 查單專員與知識專員,再交給回覆專員,並標記要人工審核 |
| complaint、promo_coupon、other | 不派工,直接交給人 |
寫死的版本快、便宜、可預測;交給 LLM 決定的版本則能處理沒列出的組合。哪一種比較好,Day 18 會把兩種都做出來,用同一批信比較。
四種拓樸的差別在於誰決定下一步。好豆選物選擇階層式,因為客服路線本來就會分岔,而且出錯要能快速定位。拆開之後,Agent 之間要靠一份定義明確的「案件」溝通,其中 facts 的每一筆都要附上出處。
明天把主管的規格定下來:意圖分類表、派工單、專員回報格式,以及案件的狀態流轉。


 iThome鐵人賽
 看影片追技術