
之前我們已經在網頁上把三個操作走過一遍,今天介紹如何讓 Claude 直接讀寫這座知識庫。下面的畫面都是 Claude,換成 Cursor 或 Claude Code 是同一套東西,差別只在怎麼接上去。
決定要做這個東西之後,第一個技術決策是:使用者要怎麼跟它互動。
最直覺的答案是做一個網頁。但那樣就只是又一個筆記軟體。這個模式的價值在於「你平常在用的 AI 工具可以直接讀寫這座知識庫」,而「你平常在用的 AI 工具」有好幾個,我不可能每個都寫一份整合。
MCP 就是為了這件事存在的。今天把為什麼選它、以及它實際上長什麼樣一次講完,重點放在程式。
MCP 是 Model Context Protocol,一套「AI 工具怎麼呼叫外部工具」的共同規格。我實作一次伺服器,Cursor、Claude Code、Claude.ai、ChatGPT 都接得上,讀寫的是同一座知識庫。
價值在使用情境上很明顯。你在 Cursor 裡寫程式,順手叫它把剛查到的東西記進知識庫;晚上用手機開 Claude.ai 問「上週那個效能問題後來怎麼解決的」,它讀到的是同一份筆記。中間不需要同步、不需要匯出匯入。
沒有 MCP 的話,我要嘛綁死一個平台,要嘛寫四份整合然後維護四份。
MCP 有一個特性我一開始沒意識到,後來它決定了整個產品的形狀:它是拉取模型。
流程永遠由 client 發起:Cursor 決定要呼叫某個工具,打一個請求給我的伺服器,伺服器回答。反過來不成立:我的伺服器沒辦法叫 Cursor 去做事。
這聽起來很自然,直到你想做這件事:使用者在網頁上按一顆「幫我編纂這則來源」的按鈕。
按鈕在我的網頁上,但真正有能力執行編纂的是使用者的 AI 工具,而我叫不動它。我能做的只有把提示詞複製到剪貼簿,請使用者自己貼進 Cursor。這在手機上根本不成立,手機沒有 Cursor。
所以後來多了第二條路:伺服器端自己跑 agent。使用者在設定頁存自己的模型 API key,網頁上的按鈕就由伺服器拿那把 key 去跑一個 agent,工具跟 MCP 那六個同名同介面,直接呼叫同一層資料存取。
兩條路現在並存。用 Cursor 或 Claude Code 的人不必填 key,費用包含在他們的工具方案裡;只用網頁或手機的人填一把 key,按按鈕就能動。
傳輸方式我選 Streamable HTTP,因為它就是普通的 HTTP,可以直接掛在既有的 Express app 上,不必另外開服務也不用處理 WebSocket。整個端點是這樣:
app.post('/mcp', byIp, bearerAuth, byToken, async (req, res) => {
  const auth = res.locals.auth as AuthContext;
  recordMcpCall(auth.userId);
  const server = createMcpServer(auth);
  const transport = new StreamableHTTPServerTransport({ sessionIdGenerator: undefined });
  res.on('close', () => {
    transport.close();
    server.close();
  });
  try {
    await server.connect(transport);
    await transport.handleRequest(req, res, req.body);
  } catch (err) {
    console.error('MCP request failed:', err);
    if (!res.headersSent) {
      res.status(500).json({ jsonrpc: '2.0', error: { code: -32603, message: 'Internal server error' }, id: null });
    }
  }
});

app.get('/mcp', bearerAuth, methodNotAllowed);
app.delete('/mcp', bearerAuth, methodNotAllowed);
有幾個地方值得逐項看。
sessionIdGenerator: undefined 代表無狀態。 每個請求開一個新的 server 實例,處理完就丟掉。代價是不能做伺服器主動推送的通知,好處是水平擴展完全不用煩惱:任何一台機器都能處理任何一個請求,記憶體裡不必維護連線狀態。對一組知識庫的讀寫工具來說,這個交換非常划算。
中介層的順序不是隨便排的。 byIp 先擋,因為那時候還不知道你是誰,只能用來源位址限流;bearerAuth 驗身分;byToken 再依 token 限流。認證前的限流防的是匿名洪水,認證後的限流防的是單一使用者跑太兇,兩者要分開算。
GET 跟 DELETE 也掛了 bearerAuth 才回 405。 先驗證再回「方法不允許」,才不會讓沒有 token 的人從回應差異推測出這條路徑存在。
res.on('close') 一定要收。 每個請求都會生出一個 server 跟一個 transport,client 中途斷線是常態,不清掉就是穩定的記憶體洩漏。
server.registerTool(
  'get_instructions',
  {
    title: '讀取編纂規則',
    description: '回傳 schema/ 層的 AI 編纂指令全文(等同知識庫的 CLAUDE.md)。動筆前先呼叫本工具。',
    inputSchema: {},
  },
  async () => text(await getInstructions(ws, lang)),
);
inputSchema 用 zod 寫,SDK 會自動轉成 JSON Schema 送給模型。有參數的工具長這樣:
inputSchema: {
  query: z.string().min(1).describe('搜尋關鍵字(子字串比對)'),
  folder: z.string().optional().describe('限定資料夾,例如 wiki 或 raw/papers'),
  tag: z.string().optional().describe('限定 front-matter 標籤'),
  limit: z.number().int().min(1).max(50).default(10).describe('最多回傳幾筆'),
},
那些 .describe() 不是寫給你看的註解,是寫給模型看的說明。min(1)、max(50)、default(10) 也一樣,它們同時是驗證規則跟給模型的提示。
bearerAuth 是一支普通的 Express 中介層:
export async function bearerAuth(req: Request, res: Response, next: NextFunction): Promise<void> {
  const header = req.header('authorization') ?? '';
  const token = header.startsWith('Bearer ') ? header.slice(7).trim() : '';
  const auth = token ? await authenticateToken(token) : null;
  if (auth) {
    res.locals.auth = auth;
    next();
    return;
  }
  res
    .status(401)
    .set('WWW-Authenticate', `Bearer realm="wikibrain", resource_metadata="${config.appUrl}/.well-known/oauth-protected-resource/mcp"`)
    .json({ jsonrpc: '2.0', error: { code: -32001, message: 'Unauthorized' }, id: null });
}
資料庫裡存的是 token 的雜湊不是明文,產生的時候回傳一次之後就再也拿不到。查詢時順便檢查 revoked_at IS NULL 與到期時間,而 last_used_at 的更新刻意做成「最多一分鐘一次、而且不擋請求」。那是給使用者看「這把 token 還活著嗎」的資訊,不值得為它多付一次同步寫入。
真正關鍵的是 401 裡那個 WWW-Authenticate。resource_metadata 是 OAuth 的探測入口:支援 OAuth 的 client 收到 401 之後會去讀那個網址,發現這台伺服器支援動態註冊,於是自己走完整個授權流程。沒有這個標頭,Claude.ai 只會告訴使用者「連線失敗」,沒有下文。
接上來的方式有兩種。
Bearer token 最簡單:使用者在設定頁產生一把 token,貼進 mcp.json。Cursor 和 Claude Code 都吃這一套,v1 我只做了這個。
但 Claude.ai 和 ChatGPT 的網頁版不吃手貼 token,它們走 OAuth:你在它們的介面貼上 MCP 網址,它自己跑一輪動態註冊、把你導到我的同意頁、你按允許,它拿到 token。這需要 OAuth 2.1 加上動態用戶端註冊,比 Bearer token 麻煩得多。
說明頁上把它寫成三種擇一或並用的方式:
| 你用的工具 | 怎麼接 | 要不要填 key |
|---|---|---|
| Cursor、Claude Code | 設定頁產生一把 MCP token,貼進 mcp.json |
不用,費用含在工具方案裡 |
| Claude.ai、ChatGPT | 在它的 connector 設定貼上 MCP 網址,走 OAuth | 不用 |
| 只用瀏覽器或手機 | 設定頁填自己的模型 API key,由伺服器端 agent 跑 | 要 |
前兩種走的是這篇講的 MCP 端點,第三種走的是前面那條伺服器端的路。
Claude.ai 那條的實際步驟長這樣:
左欄「自訂」→「連接器」→ 右上「新增」→「自訂連接器」→ 名稱填 WikiBrain、網址貼 MCP 網址 → 新增。第一次會跳到 WikiBrain 的登入與同意頁,按「允許」。
按完「允許」之後,連接器的設定裡會列出六個工具:讀取編纂規則、搜尋筆記、讀取筆記、建立筆記、更新筆記、列出資料夾。那就是前面 registerTool 註冊的那六個。title 欄位就是這裡顯示的中文名稱,所以工具的 title 不是給程式看的,是使用者真的會讀到的東西。
這一整段流程就是 401 那個標頭唯一看得見的成果:使用者從頭到尾只貼了一個網址,發現、註冊、授權全部是 client 自己跑完的。
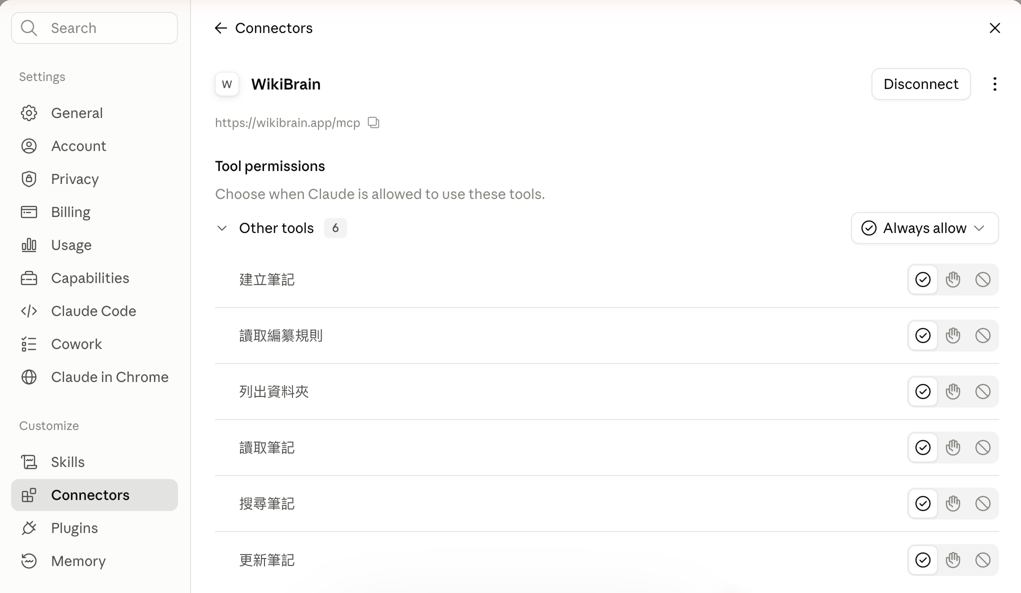
同一組 registerTool 註冊的六個工具,出現在別人的產品介面裡。列表上那六個中文名稱就是 title 欄位,而且每個工具旁邊都有「允許/每次詢問/拒絕」三個選項。使用者是逐個工具決定要不要授權的,所以工具的名字取得好不好,直接影響他敢不敢按允許。
授權後的連線會列在設定頁,標示 OAuth,隨時可以撤銷。存取 token 二十四小時到期,client 自動續期九十天。
接上之後就是這樣用:
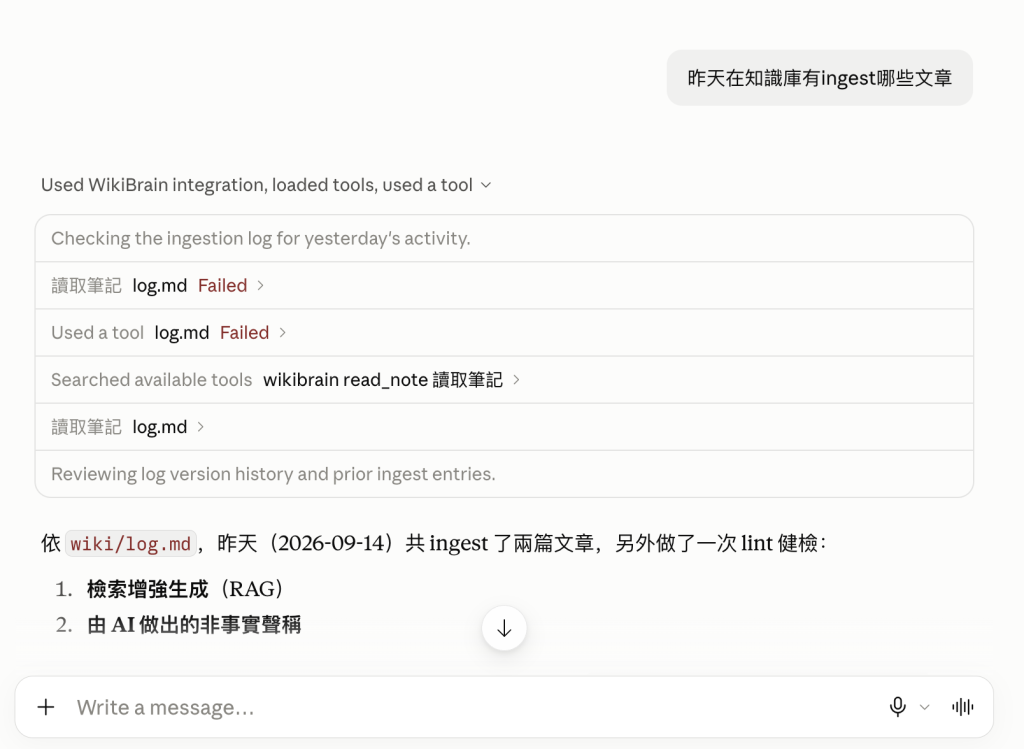
*問題裡沒有提到任何檔名,是它自己決定去讀 wiki/log.md。
中間兩次 read_note 失敗,它沒有重試同一件事,而是先去查一次有哪些工具可用,拿到工具名之後才成功。列表上顯示的「讀取筆記」就是 registerTool 註冊時那個 title。
同一件事在 Cursor 裡是一樣的,六個工具同名同介面,讀寫的也是同一座知識庫,只是那邊不走 OAuth,貼一把 token 就好。
寫完之後先用 curl 確認三件事,再去接真的 client:
# 沒帶 token → 401,而且要有 WWW-Authenticate
curl -i -X POST https://你的網域/mcp

# GET → 405,這條路徑只收 POST
curl -i https://你的網域/mcp

# 帶 token 列出工具
curl -s -X POST https://你的網域/mcp \
  -H 'authorization: Bearer <token>' \
  -H 'content-type: application/json' \
  -H 'accept: application/json, text/event-stream' \
  -d '{"jsonrpc":"2.0","id":1,"method":"tools/list"}'
第三個請求要看到六個工具的名稱與描述。看到了,Cursor 那邊就一定接得上。
MCP 在這個專案裡負責一件事:讓使用者原本就在用的 agent 直接讀寫這座知識庫。一支 /mcp 路由、六個工具、兩種接法,Cursor、Claude Code、Claude.ai、ChatGPT 接的都是同一份實作,讀寫的是同一份筆記。不必換工具,不必匯出匯入,也不必再填一把模型 API key。
它只能被呼叫,所以網頁上那些按鈕另外走伺服器端的 agent。兩條路不一樣的只有誰發動,工具與資料存取是同一層。


 iThome鐵人賽
 看影片追技術