
上一篇,我們做的工具可以算是蠻簡單的,今天這篇,我們來做些更複雜的工具,比較困難的點是在於今天我們在工具進行了上下文控制的選擇,模型可以給出一個範圍,讓得出的結果不至於無限制地塞爆上下文窗口。
可以思考看看,上一篇的
read_file()是不是有我剛提到的這個問題?可以怎麼解決呢?
有興趣的話看完這篇會有類似的「切片邏輯」可以參考去替read_file()做升級!
寫程式時,我們常常會叫 Agent 「幫自己檢查專案內 ... 的問題」,但是,我們目前只有 read_file() 可以讀檔以及 write_file() 可以編輯,但要怎麼知道要讀的檔案有哪些、路徑是什麼呢?
這時候,就需要一個工具可以列出資料夾內所有的檔案了!這樣一來,模型先去看了有哪些檔案,一一檢查檔案,定位出有問題的部分並做修改。
首先我們看到參數的部分:
pattern:如說明裡寫的,傳入「Glob 比對規則」 用來比對文件樣式,可以理解為以條件匹配的方式來做檔案搜尋。
Glob 是對路徑進行搜尋比對的功能,
這裡簡單講幾個常用的:
*單層匹配,例如*.py可以搜尋到main.py、tool.py(工作目錄為src/meowgent/的情況下)**向下匹配,只要是在工作目錄底下的子資料夾都在匹配範圍內。
看到下面
pattern: Annotated[...]的部分,分別表示:當前目錄下所有含有副檔名的檔案、當前目錄「底下」的所有副檔名為.py的檔案、src目錄下的任何項目。
offset:偏移量,搜尋出來檔案中的起始索引。limit: 最多列出幾筆檔案。
offset、limit是用來切片的數據,這裡預設 0、200,也就是列出索引 0 ~ 199。
在搜尋時最好讓模型可以在該檔案所在的資料夾內做搜尋(如果已知的話),可以減少搜尋到不相關檔案,避免佔據上下文。
# src/meowgent/tool.py
...

@tool_register(False) # 不需審核
def list_file(
    pattern: Annotated[str, "Glob 比對規則(例如 '*.*'、'**/*.py'、'src/*')"],
    # Glob 規則

    base_path: Annotated[str, "搜尋起點目錄路徑(預設為 '.' 當前目錄)"] = ".", # 搜尋起點
    offset: Annotated[int, "起始筆數偏移量(預設為 0,用於分頁讀取長清單)"] = 0,
    limit: Annotated[int, "本次最多讀取的檔案數量(預設為 200)"] = 200
) -> str:
	"""
	列出檔案
	如果要尋找專案外或使用者家目錄的檔案(例如 Downloads, Desktop),
    請務必修改 base_path 參數(如 '~/Downloads' 或 '/Users/...')
	"""
接下來把檔案給列出來放進 files 串列中:
路徑依然做物件化和轉為絕對,而由於 .glob() 產生迭代器物件,用 for 的 file 來接住搜尋到的 Path 物件。
這邊迴圈內的邏輯是這樣的:
排除資料夾,只針對純檔案(.is_file())處理。
透過 search_idx >= offset 跳過上一頁已看過的項目。
當收集的檔案達到 limit 上限時,標記 has_more = True 並提早中斷迴圈。
最後一樣加上 try...except 例外處理。
# src/meowgent/tool.py
...

@...
def list_file(...) -> str:
	""" ... """

	files = []
    search_idx = 0 # 紀錄總共已經搜尋到多少個了(非保留多少個)
    has_more = False # 後面還有內容
    try:
        for file in Path(base_path).expanduser().glob(pattern):
            if file.is_file():

                if search_idx >= offset: # 達到起始點索引

                    if len(files) < limit:
                        files.append(str(file))
                    else:
                        has_more = True
                        break
                        # 告知後面還有內容,且退出迴圈(如果沒內容自己就結束迴圈了,不會到這)

                search_idx += 1

    except Exception as e:
        return f"錯誤:找不到路徑 '{base_path}':{e}"
最後把串列變為字串形式,每個檔名之間換行隔開,若總數超過 limit 的數量,回傳提示後面還有內容:
# src/meowgent/tool.py
...

@...
def list_file(...) -> str:
	...

    return_files = "\n".join(files)

    if has_more:
        return_files += f"\n\n...[僅顯示第 {offset+1}~{offset + limit} 筆,
            若要看下一頁,請傳入 offset={offset + limit}]"
    return return_files
雖然我們前面已經有 read_file() 可以閱讀文件了,但若傳入的是一篇小說又或者是數千行的代碼,而模型只是想看「其中一部分內容」時,就會浪費掉大量的上下文。
看到參數部分:
pattern:這裡和 list_file() 不同,採用的是 Regex 表達式
base_path:不是單獨一個文件,而是從起點目錄下去做搜尋,更方便於在專案中查詢。Glob 和 Regex 都是搜尋用的表達方式,前者針對路徑,後者針對字串。
# src/meowgent/tool.py
import re
...

@tool_register(False) # 不需審核
def grep_search(
    pattern: Annotated[str, "要搜尋的正則表達式或文字關鍵字(Regex Pattern)"],
    # Regex 表達式 -> 要比對的文字

    base_path: Annotated[str, "搜尋起點目錄路徑(預設為 '.' 當前目錄)"] = "." # 搜尋起點
) -> str:
    """ 搜尋文字檔內容 """
因為等等 pattern 會被迴圈多次使用,所以在這預先編譯好,也加上例外捕捉:
什麼是預先編譯 -
re.compile()?
你可以先看一下搜尋部分的邏輯,運用的是「迴圈」,也就是說,要搜尋很多次,每搜尋一次都要重新對正則做一次編譯,所以我們可以在搜尋前先編譯好並存下來,迴圈內直接用就好,對效能有不小的幫助!
# src/meowgent/tool.py
...

@tool_register(False) # 不需審核
def grep_search(...) -> str:
	""" ... """

	try:
        rx = re.compile(pattern) # 預先編譯,不用每次迴圈都編譯一次

    except re.error as e: # 捕捉正則編譯錯誤
        return f"錯誤:無效的正則表達式 '{pattern}':{e}"
然後是搜尋的邏輯:
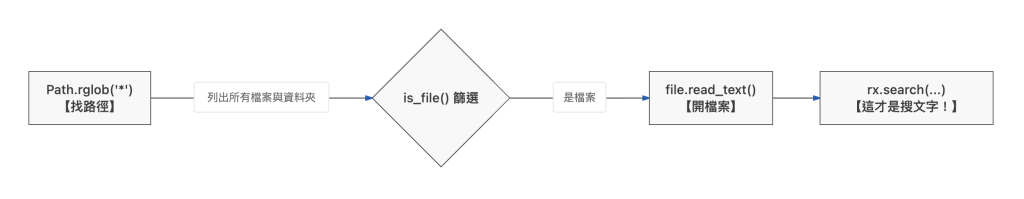
for file in Path(base_path).expanduser().rglob("*"): 先把起點路徑以下的檔案(包含資料夾)列出。read_text() 讀取文件文字,同樣 "utf-8" 確保編碼形式,而若遇到非文字檔(例如 .pdf)會自動跳過。for line_num, line_content in enumerate(content.splitlines(), 1):.splitlines() 切成一行一行來做搜尋,用 enumerate() 來寫上行數(起始索引設為 1).search() 做搜尋,搜尋到則加入 match_contents 串列。rx。這裡來看一下
rglob()和glob()的差異:
其實rglob()本質上就是glob()搭配**/的「語法糖(Syntactic Sugar)」,
所以rglob("*")相當於glob("**/*"),也就是當前目錄底下(**)所有項目(*)。
# src/meowgent/tool.py
...

@tool_register(False) # 不需審核
def grep_search(...) -> str:
	...

	try:

        match_contents = []
        for file in Path(base_path).expanduser().rglob("*"):

            if not file.is_file():
                continue # 非檔案,跳過

            try:
                content = file.read_text(encoding="utf-8")
            except Exception:
                continue # 非文字檔,跳過

            for line_num, line_content in enumerate(content.splitlines(), 1):
            # 切成行,計數從 1 開始

                if rx.search(line_content):
                    match_contents.append(
                        f"{file}:{line_num}:{line_content.strip()}"
                    )
最後是為了節省上下文的切片以及回傳:
# src/meowgent/tool.py
...

@tool_register(False) # 不需審核
def grep_search(...) -> str:
	...

	return_matches = "\n".join(match_contents[:100]) # 只保留 100 個

        if len(match_contents) > 100:
            return_matches += "\n\n...(僅顯示前 100 筆比對結果,
                請使用更精確的搜尋 pattern 來縮小範圍)。"

        return return_matches
    except Exception as e:
        return f"錯誤:找不到路徑 '{base_path}'"
這篇,我們又完成了兩個工具,讓 Agent 能做更多事了,下一篇,來加入最後兩個強大的工具:讓 Agent 能使用「終端指令」以及「上網」!


 iThome鐵人賽
 看影片追技術