
今天要來實作第二層的壓縮 -「語意滾動壓縮」,當我們進行了上下文裁剪後,上下文窗口還是高達 75% 時(或者手動打指令),
我們就要來實作這個壓縮方式。
原本的 history_messages 是一個內部為「字典」的結構,且在工具調用回傳內部還有 XML 的結構(<tool_response>...</tool_response>),
有太多冗餘的部分,不易閱讀也耗費更多效能(越多 token 輸入,模型算越久)。
所以,我們需要將 history_messages 的結構給「扁平化」:
同時要注意須保留讓模型理解這是「使用者」、「工具」還是「模型」給出的內容。
先宣告一個空串列 lines 用來放要拼接的文字,然後用迴圈遍歷每個字典:
# src/meowgent/context/compactor.py
from .pruner import turn_separation
from typing import List
import re
import ollama
from config.config_manager import ConfigManager # 為避免循環引入,不直接從 config 匯入

def _format_history_msgs(history_messages: List[dict]) -> str:
    """
    將 history_messages 轉為扁平的文字格式(list -> str)
    1. 將使用者問題、工具結果、模型回答用文字區分
    2. 刪除工具調用結果的 XML 標籤
    """

    lines = []
    for msg in history_messages:

        role = msg["role"]
        content = msg["content"]
第一種情況,role 為 user,而這又會出現兩種情況,是「工具調用結果」或真的是「使用者」。
是工具的話(開頭為 <tool_response>),用正則的方式找出工具名(group(1))及工具回傳的文字(group(2))。
如果正則找不到的話(可能格式有錯),就簡單去除 XML 標籤就好。
而如果真的是使用者就很簡單了,直接把 content 放進去就好。
兩者都要記得
[工具 工具名]或[使用者]標籤喔!
# src/meowgent/context/compactor.py
from ...
...

RX_STRIP_TOOL_RESPONSE = re.compile(
	r"<tool_response>\s*(?:\[工具\s*(\w+)\s*執行結果\]:)?\s*\n?([\s\S]*?)\s*</tool_response>"
)

def _format_history_msgs(...) -> ...:
	for msg in history_messages:
		...

		if role == "user":

            if content.startswith("<tool_response>"):

                match = RX_STRIP_TOOL_RESPONSE.search(content)

                if match:
                    tool_name = match.group(1)
                    tool_content = match.group(2)

                else: # 正則沒找到 -> 簡單刪除標籤

                    tool_name = "工具輸出"
                    tool_content = content.replace("<tool_response>", "").replace("</tool_response>", "").strip()

                lines.append(f"[工具 {tool_name}]:\n{tool_content}")

            else:
                lines.append(f"[使用者]:{content}")
而如果是模型回答也只要把內容放入,然後記得標上 [模型] 就好,
最後,就可以用 "\n\n".join() 把 lines 拼接起來回傳了!
兩個換行達成**「空行分段」**的效果。
# src/meowgent/context/compactor.py
from ...
...

def _format_history_msgs(...) -> ...:
	for ...:
		...

		if role == "user":
			...

		elif role == "assistant":

			lines.append(f"[模型]:{content}")

    return "\n\n".join(lines)
把 history_messages 格式處理好,就可以開始來做負責壓縮的函數。
在這個函數之中,只需關注:
agent.py 來檢查。# src/meowgent/context/compactor.py
...
def macro_compaction(
history_messages: List[dict],
keep_turns: int = 2
) -> List[dict]:
""" 調用模型進行上下文壓縮 """
# src/meowgent/context/__init__.py
from ...
...
from .compactor import macro_compaction
為什麼會發生循環匯入?(如果
compactor.py直接從config匯入):
cli/commands.py匯入了context.macro_compaction。context/compactor.py寫了from config import ConfigManager, repair。config/__init__.py匯入了config_repair.py。config_repair.py匯入了cli.CLIRenderer。cli/__init__.py又回頭匯入commands.py。
沒錯,首先,就是跟 turn_separation() 一樣先確認輪數,界定好邊界:
這部分,跟
pruner_tool_text()前面部分完全相同。
# src/meowgent/context/compactor.py
...

def macro_compaction(...) -> ...:
	...

	turn_indices = turn_separation(history_messages)

    if len(turn_indices) <= keep_turns:
        return history_messages

    cutoff_idx = turn_indices[-keep_turns] # 訂出邊界
邊界界定好後,我們要把 history_messages 切成「需要壓縮」和「不需壓縮」。
後期,要把壓縮完的前者和後者做拼接,組成新的
history_messages。
# src/meowgent/context/compactor.py
...

def macro_compaction(...) -> ...:
	...
	# 切出壓縮部分
	old_history_msgs = _format_history_msgs(history_messages[:cutoff_idx])

	# 切出保留部分
    recently_history_msgs = history_messages[cutoff_idx:]
然後,prompt 的部分:
# src/meowgent/context/compactor.py
...
RX ...

COMPACTION_SYSTEM_PROMPT = """
你是一個程式碼開發助理的對話壓縮專家。
請將以下歷史對話紀錄提煉為一份結構化的「進度筆記」。
這份筆記將交給下一位接手的助理繼續工作,請嚴格按照以下四個標題輸出,不要包含任何無關客套話:

1. 【原始任務目標】:使用者最初要求解決的核心問題、任何特定限制或規則。
2. 【已知關鍵資訊】:已確認的專案架構、關鍵檔案路徑、函式位置。
3. 【已完成變更】:已經成功建立、修改的檔案,以及執行成功的終端指令。
4. 【目前狀態與下一步】:目前停在哪個步驟、遇到的錯誤或接下來準備執行的動作。

內容如下:
"""

...

def macro_compaction(...) -> ...:
	...

	prompt = f"{COMPACTION_SYSTEM_PROMPT}\n\n{old_history_msgs}"
這裡又是一個字串分行的方式!用
""" ... """,
另外兩個分別是 Day 9 時我們用textwrap.dedent()跟昨天的("...\n", "...\n", ...)拼接。
接下來,就可以開始調用模型了!
但在這之前,別忘了先取得設定檔。
而呼叫模型的部分,有發現不大一樣嗎?先前不論是在主 Agent 還是子 Agent 都是採用 ollama.chat(),
這裡,主要的差異在於是否支援多輪對話,在 ollama.generate() 是不支援的,好處就是不用額外去維護多輪的格式,只需要傳入 prompt 就好了,而回傳的是 GenerateResponse 物件,內容大同小異,我們要用到的答覆放在 response 屬性裡。
在
options之中,我們透過num_predict限制了輸出的長度,以及repeat_penalty來加強對重複(跳針)的懲罰。
 # src/meowgent/context/compactor.py
...

def macro_compaction(...) -> ...:
	...

	_, config = ConfigManager.load_config() # 取得設定檔

    compaction_content = ollama.generate(
        model=config.models.default_model,
        prompt=prompt,
        options={
            "num_ctx": config.models.max_context,
            "temperature": 0.1,
            "num_predict": 1024, # 限制輸出 token
            "repeat_penalty": 1.15 # 重複懲罰
        }
    ).response
最後,我們把模型回覆和保留的 keep_turns 輪對話拼接後回傳就搞定了:
 # src/meowgent/context/compactor.py
...

def macro_compaction(...) -> ...:
	...

	return [
        {
            "role": "user",
            "content": f"[系統提示:以下為前期歷史紀錄的壓縮筆記]\n{compaction_content}"
        },
        {
            "role": "assistant",
            "content": "已完整接收前期工作進度與任務目標,我將接續進行。"
        }
    ] + recently_history_msgs
壓縮邏輯搞定了,接下來就是要把它接入 Agent() 以及指令了。
Agent()接續第一層的裁剪後,繼續語意滾動壓縮,先判斷是否超過 75% 佔用:
因為順序是:
有超過keep_turns輪對話 -> 第一層壓縮 -> 佔用還是太大 -> 第二層壓縮。
原先
get_context_status_text()計算出的percentage這裡我把它存到了self.context_percentage裡:self.true_token: Optional[int] = None...self.context_percentage = round((total_token / max_context) * 100, 1)...return f"[{total_token_k}k/{max_context_k}k] {self.context_percentage}%"...
# src/meowgent/agent.py
from ...
from context import ..., macro_compaction

...

class Agent():
	def chat(...) -> ...:
		...

		if token_gap > 0 and self.true_token:
            self.true_token ...

		self.get_context_status_text() # 獲取上下文佔比

	    if self.context_percentage > 75:
而我會在 main.py 加入渲染的邏輯,
所以,這邊新增一下狀態到 LLMResponse 裡:
# src/meowgent/providers/base.py
...

@dataclass
class LLMResponse:
    status: Literal[
        ...,
        "compacting",
        "compact_done",
        "compact_fail"
    ]
render_compaction_spinner()利用了之前子 Agent 使用過的Spinner()。
render_compaction_end()中,我在自動呼叫時回傳的訊息不打算有幾 % 壓到幾 % 的資訊(而在指令的部分想要有)。
我的想法是因為自動呼叫時,使用者通常是無意識的(根本沒發現需要壓縮),所以就不特別再調用get_context_status_text()獲取到新的百分比;
而如果是使用者自主利用指令想進行壓縮,那還是加上提示效果會比較好。
# src/meowgent/cli/renderers.py
class CLIRenderer:
	...

	def render_compaction_spinner(self) -> Group:
        """ 渲染上下文壓縮時的轉圈圈動畫 """
        return Group(Padding(
	        Spinner("dots", text="[dim]正在進行對話歷史壓縮...[/dim]"),
	        (0, 0, 0, 2)
        ), self.get_rule())

    def render_compaction_end(
	    self,
	    precentage: Optional[Tuple[float, float]] = None
    ) -> Group:
        """ 壓縮完成的提示 """
        if precentage:
            old, new = precentage
            text = f"[dim]{escape(f'[{old}→{new}]')}[/dim]"
        else:
            text = ""

        return Group(Padding(
	        f"[green]✔ 對話歷史已完成壓縮![/green]{text}",
	        (0, 0, 0, 2)
        ), self.get_rule())

    def render_compaction_fail(self) -> Group:
        return Group(Padding(
	        "[yellow]對話輪數仍在近期保護區內,無需壓縮。[/yellow]",
	        (0, 0, 0, 2)
        ), self.get_rule())
Agent()判斷完需要壓縮後,首先回傳狀態,讓 main.py 可以呼叫渲染,
接著,記錄下舊的 self.history_messages 長度,用於比較是否有成功壓縮(跟昨天的 pruner_tool_text() 一樣的邏輯)。
然後就可以調用剛做好的 macro_compaction() 來嘗試壓縮,壓縮完後進到 if len(self.history_messages) < old_len: 判斷壓縮結果。
成功則更新 self.true_token 為 None、回傳狀態;失敗則單純回傳狀態。
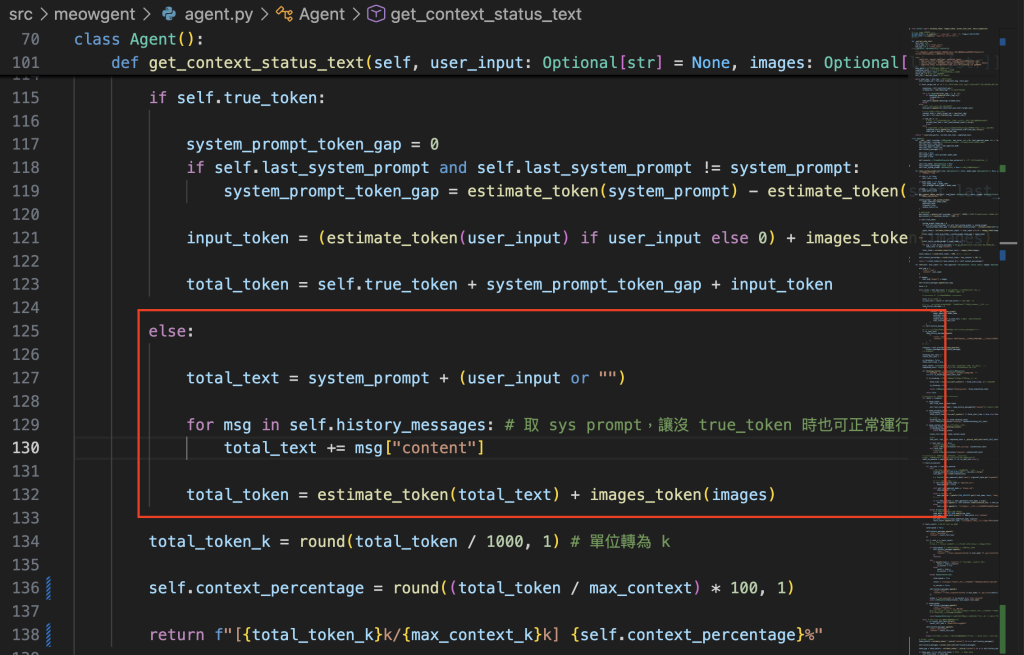
self.true_token為None則會進到框起來的部分:
# src/meowgent/agent.py
...
class Agent():
	def chat(...) -> ...:
		...

		if self.context_percentage > 75:
            yield (LLMResponse(status="compacting"))

            old_len = len(self.history_messages)

            self.history_messages = macro_compaction(history_messages=self.history_messages)

            if len(self.history_messages) < old_len:
	            # 有壓縮 -> 更新 token

                self.true_token = None
                # 沒有 true_token -> 走到 get_context_status_text() 的 else 全部用估計的

                yield LLMResponse(status="compact_done")

            else:
                yield LLMResponse(status="compact_fail")
main.py 來呼叫渲染這邊就只是在對應的狀態呼叫對應的函數來渲染:
在
compact_done和compact_fail時需要把compacting的轉圈圈動畫清掉。
# src/meowgent/cli/main.py
...
if __name__ == "__main__":
	...
	try:
		while ...:
			...
			with Live(...) as live:
				try:
					for ...:
						...

						elif stream_content.status == "compacting":
                            live.update(cli.render_compaction_spinner())

                        elif stream_content.status == "compact_done":
	                        live.update("")
                            cli.console.print(cli.render_compaction_end())

                        elif stream_content.status == "compact_fail":
	                        live.update("")
                            cli.console.print(cli.render_compaction_fail())
					...
這麼一來,「自動」的語意滾動壓縮就完成了,馬上繼續指令的部分吧!
先獲取原先的長度和百分比:
# src/meowgent/cli/commands.py
from ...
from context import macro_compaction
from rich.markup import escape

...

@cmd_registry("/compact")
def _compaction(cli: CLIRenderer, model_object: Agent, **kwargs):
    """ 強制呼叫模型進行上下文壓縮 """

    old_len = len(model_object.history_messages)
    old_percentage = model_object.context_percentage
這裡由於不在 main.py 的 with Live(...) as live 裡,要自己建一個,然後就可以呼叫 macro_compaction 了:
# src/meowgent/cli/commands.py
@cmd_registry(...)
def _compaction(...):
	...

	with Live(...) as live:
        live.update(cli.render_compaction_spinner())

        model_object.history_messages = macro_compaction(
	        history_messages=model_object.history_messages
        )
而這邊,跟 agent.py 的做法是差不多的,一樣先判斷有沒有壓縮,
有的話,更新 true_token 為 None、調用 get_context_status_text()(因為這裡我想渲染百分比差異)。
然後也是要 live.update("") 來把轉圈圈清掉,接著做渲染(要填入 context_percentage)。
沒有的話則只要 live.update("") 然後渲染就搞定了。
# src/meowgent/cli/commands.py
@cmd_registry(...)
def _compaction(...):
	...

	if len(model_object.history_messages) < old_len:

        model_object.true_token = None

        model_object.get_context_status_text()

        live.update("")
        cli.console.print(cli.render_compaction_end(
            precentage=(
	            old_percentage,
	            model_object.context_percentage
            )
        ))

    else:
	    live.update("")
        cli.console.print(cli.render_compaction_fail())
趕緊去試試輸入 /compact 有沒有效果吧!
今天,我們完成了可以從兩種方式調用的語意滾動壓縮,也就是說,兩層的壓縮正式被我們完成了,告別了上下文不夠用的問題!
哇~終於啊,整個專案的功能部分基本上是完成了。
明天的話,沒意外會嘗試看看能否把整個專案打包成安裝檔,甚至像 codex、claude code 那樣可以直接在終端用指令安裝,最後,講一下這 30 天以來的心得,結束這個系列!
(今天,再度突破字數新高,一萬一千字!!!然後,又是壓線發了哈哈)


 iThome鐵人賽
 看影片追技術