

一句摘要:Stream 描述資料隨時間逐步流動的模型;Web Streams 的三個名稱則描述資料管線中的角色與端點。一條 stream 不必同時經過三種角色,只有把端點接起來時才形成 pipeline。
前置知識:可以先理解 Day 12 的 Async Iterator 可以幫助我們理解「資料為什麼會在未來才逐筆到來」;
學習路線: 初步認識 Web Stream 建立自己的心智地圖。
標籤:Web Streams API ReadableStream WritableStream TransformStream pipeThrough() pipeTo()
ReadableStream 為何是有順序、消費式的介面,而不是可任意索引的集合。ReadableStream、WritableStream、TransformStream 各自提供的端點。輸入 與 輸出 的管線概念因為找了很多實務上 async iterator 應用會常常出現 Stream,所以就補補自己對 Web Streams 還不足的部分,從 JavaScript 的「迭代資料」,正式走進瀏覽器的「資料流」。
不過因為這個觀念我剛開始看很不好理解(太多名詞和流程),我覺得先建立自己的理解地圖;在應用 Web Streams 上才會比較順手,這裡死背會用得很痛苦😂。
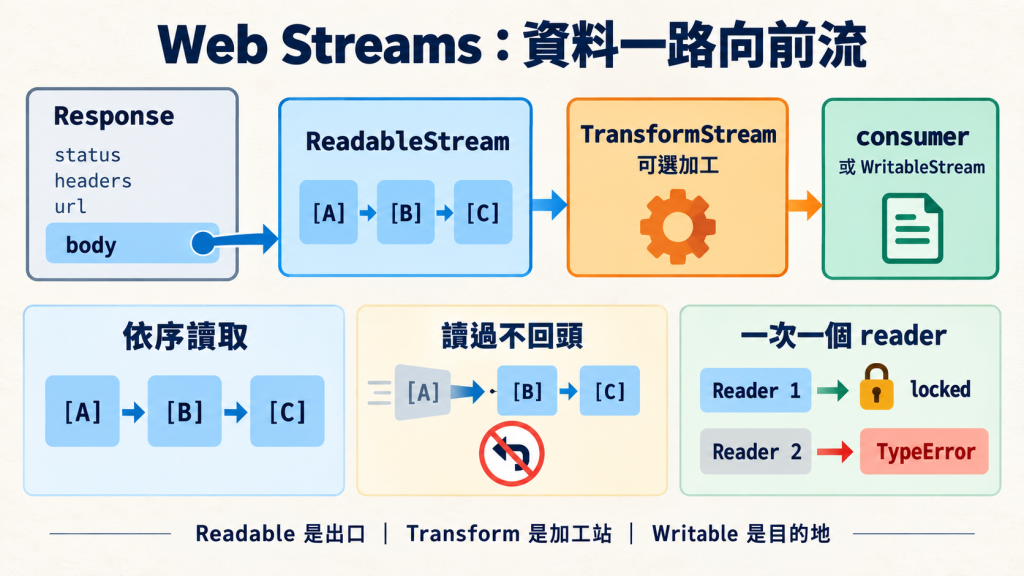
身為一名前端工程師常常跟後端協作串接 API,我很容易把網路資料想成一個簡單完整結果:
發送 request
    ↓
等待完整 response
    ↓
拿到全部資料
    ↓
開始處理
但其實現實很多場景,資料不是一次送完回傳的,例如:
這時候適合的模型不是「完整資料 → 處理」,而是讓 consumer 在資料尚未全部完成時,持續處理每個抵達的 chunk:
chunk
  ↓
chunk
  ↓
chunk
  ↓
consumer 持續處理
Stream 描述的就是這種「資料隨時間逐步流動」的模型。它的核心價值不只是快,而是:
資料還沒有全部完成時,consumer 就可以開始處理。
順帶一提,Web Streams 並不是因應 AI 串流才出現的。WHATWG 在 2013 年開始設計,Chrome 在 2015 年透過 response.body 提供 ReadableStream,2016 年起開發者也能自己建立它。之後其他瀏覽器才陸續跟上。
前幾天談 Iterator 時,我們建立了一個重要的心智模型:consumer 要資料時,再取得下一筆。
consumer
   ↓ next()
producer
   ↓
value
再到了 Async Iterator 加入了非同步概念,可以處理下一筆資料可能未來才會回傳的情境:
consumer
   ↓ await next()
producer
   ↓
未來某個時間
   ↓
value
這已經慢慢接近 Stream 的世界。Stream 再往前問的是:
如果資料會持續產生,而且 producer 與 consumer 的速度可能不同,Web 平台要怎麼建立一條
可管理的資料管線來規範?
ReadableStream 這個名字可能很陌生,但如果用過 Fetch API,其實可能早就遇過它。即使只是一般的 JSON API,response body 也會以 stream 暴露:
const response = await fetch('https://api.escuelajs.co/api/v1/products');

console.log(response instanceof Response);
// true

console.log(response.body);
// ReadableStream 或 null
也可以使用網頁 dev tool 直接觀察 response.body,會出現 ReadableStream。
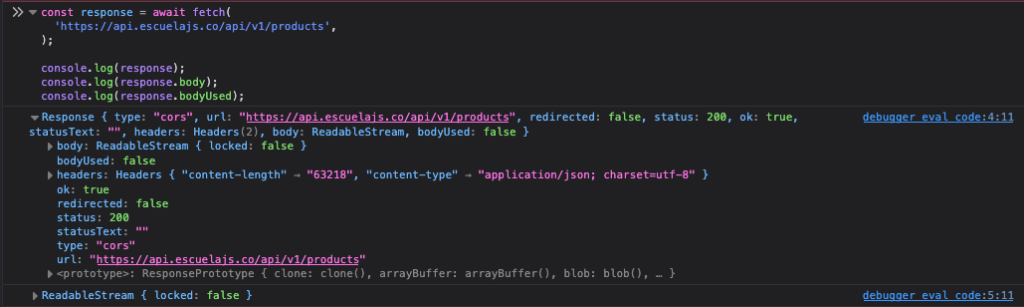
Response 本身不是 stream。它是包含 status、headers、URL 與 body 的 HTTP 回應物件;真正可逐步讀取的是 response.body。
有內容時,它是瀏覽器收到 response bytes 後持續提供給 consumer 的可讀出口;沒有 body 的 response 則可能是 null。
Response
├── status
├── headers
├── url
└── body → ReadableStream<Uint8Array> | null
所以,await fetch() 取得 Response 時,不代表完整 response body 已經全部下載完成。只要有內容,瀏覽器就可以透過 response.body,把逐步收到的 bytes 繼續交給前端程式。
差別只在於我們選擇怎麼消費這條 stream。
平常呼叫的 response.text()、response.json()、response.blob(),可以理解成瀏覽器幫我們把 body stream 消費完,最後組成一個完整結果:
這裡也可以先注意著 response.json() 解析完讀取完資料,會被標記這個 response 被消費過。
const response = await fetch('/api/users');
const users = await response.json();

console.log(response.bodyUsed);
// true
以 response.json() 為例,瀏覽器會先讀完整個 body,再把內容解析成 JavaScript value;它不是逐筆產生 JSON:
response.body(ReadableStream)
→ 讀完所有 bytes
→ 解碼文字
→ JSON.parse()
→ users
如果不想等瀏覽器組成完整結果,也可以從 response.body 取得 reader,先讀取下一個 chunk:
const response = await fetch('/api/users');

if (!response.body) {
  throw new Error('這個 response 沒有 body');
}

const reader = response.body.getReader();
const result = await reader.read();

console.log(result);
// { value: Uint8Array(...), done: false }

reader.releaseLock();
這裡先觀察結果就好,知道 value 是這次取得的 bytes,done 表示 stream 是否已經結束即可。
所以並不是只有名稱寫著 streaming 的 API 才有 Stream:
普通 JSON API ─┐
圖片或檔案 API ├→ fetch() → Response.body → ReadableStream
SSE / AI API  ─┘
先初步透過API回應結果理解三件事就行:
Response 本身不是 stream,response.body 才是。response.body 的型別是 ReadableStream | null;例如 HEAD、204 No Content 等沒有 body 的回應可能是 null。response.json() 一次讀完。使用 Fetch API 時,即使是一般 JSON API,response body 也會以
ReadableStream暴露;平常呼叫response.json(),只是選擇讓瀏覽器替我們把這條 stream 全部讀完並解析
第一次跟我一樣初步接觸 Streams 概念,在 MDN-Stream API 或其他文章都看到三種 Stream,很容易以為資料被規定要走完三個步驟,然後看得一頭霧水😵💫😵:
ReadableStream → TransformStream → WritableStream
其實 Web Streams 拆開的不是「處理步驟」,而是資料流動方向與端點能力:
ReadableStream:資料從這裡出來
WritableStream:資料往這裡進去
TransformStream:資料從一端進去,加工後由另一端出來
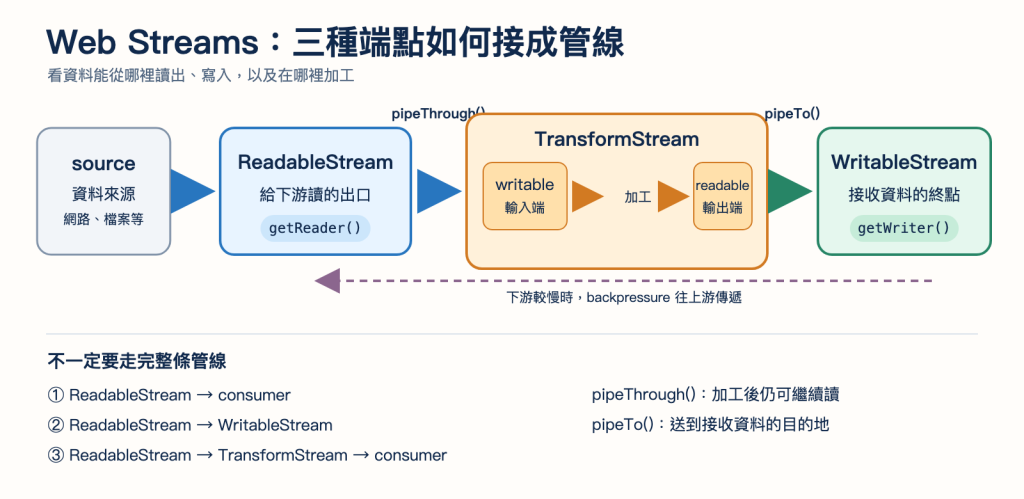
真實世界的資料來源不一定同時能讀、能寫、又能轉換。例如 response.body 的責任是交出伺服器回傳的 bytes;consumer 不應該透過它把資料寫回 HTTP response。因此,它只需要暴露「可讀」能力。
反過來,一個接收 log、儲存檔案或送出資料的目的地,可能只需要接收資料,不需要讓上游再從相同端點把資料讀回來。這種角色只需要「可寫」能力。
在資料管線裡,「提供資料」、「接收資料」與「加工後再提供資料」是不同的端點能力。Web Streams 分別用 ReadableStream、WritableStream 和 TransformStream 表達它們。
Web Streams 強制區分的是「每個端點能做什麼」,不是強制應用程式一定要使用全部三種 Stream;需要兩種能力時,也可以把可讀端與可寫端組合起來。
| 建構子名稱 | 入口方法(writable) | 出口方法(readable) | 比喻 |
|---|---|---|---|
ReadableStream |
❌ | ✅ | 取件口 |
WritableStream |
✅ | ❌ | 收件箱 |
TransformStream |
✅ | ✅ | 翻譯機 |
這裡在讀文件時,我自己也常看到這些資料流有提供 writable 方法,會直覺想成「寫出去、輸出」。
但 Web Streams 內部API的名字是站在「使用這個端點的程式」的角度 取的,避免跟 Stream 建構子名稱小小搞混:
你的程式 ──寫入──→ [ writable ]   資料從這裡「進去」
你的程式 ←─讀取── [ readable ]   資料從這裡「出來」
ReadableStream:只有出口ReadableStream 面向 consumer。資料可能來自網路、檔案或程式內部,但 consumer 只需要知道一件事:可以從這裡依序拿到下一個 chunk。
const response = await fetch('/api/users');

response.body.getReader();    // ✅ 出口:可以讀
// response.body.getWriter(); // ❌ 沒有入口,沒有這個方法
source → producer → [ ReadableStream 出口 ] → consumer
ReadableStream 和陣列最大的不同是:陣列可以反覆讀,stream 不行~
有兩個主要兩個特性:
每呼叫一次 read(),就依序拿走一個 chunk。被拿走的 chunk 會從 stream 裡消失,沒有辦法倒回去重讀。
可以把它想成迴轉壽司🍣🍣:盤子經過你面前,拿走了就沒了,不會再繞回來同一盤。
const letters = new ReadableStream({
  start(controller) {
    controller.enqueue('A');
    controller.enqueue('B');
    controller.enqueue('C');
    controller.close();
  },
});

// 第一個 reader 讀兩次
let reader = letters.getReader();
console.log(await reader.read()); // { value: 'A', done: false }
console.log(await reader.read()); // { value: 'B', done: false }
reader.releaseLock();

// 換一個新的 reader,會不會從 A 重新開始?
reader = letters.getReader();
console.log(await reader.read()); // { value: 'C', done: false } ← 不會!接著從 C 開始
console.log(await reader.read()); // { value: undefined, done: true }
text
[ A ][ B ][ C ] → read() 拿走 A → read() 拿走 B → 換 reader → read() 只剩 C
換一個 reader,不等於從頭開始。 A、B 已經被讀走,stream 裡只剩下 C。
這也是為什麼 response.json() 不能呼叫兩次:第一次已經把 response.body 讀到底了。
const response = await fetch('/api/users');

await response.json(); // ✅ 讀完整個 body
await response.json(); // ❌ TypeError:body 已經被讀過了

console.log(response.bodyUsed); // true
一條 ReadableStream 呼叫 getReader() 後就會被鎖定(locked)。在這個 reader 釋放之前,其他人都拿不到 reader。
const letters = new ReadableStream({
  start(controller) {
    controller.enqueue('A');
    controller.close();
  },
});

const readerA = letters.getReader();
console.log(letters.locked); // true

const readerB = letters.getReader();
// ❌ TypeError:ReadableStream is locked
為什麼要這樣設計?
回到特性一:chunk 拿走就沒了。如果兩個 reader 可以同時讀,A 拿到第一個、B 拿到第二個,雙方都只拿到殘缺的資料,還不知道缺了什麼。鎖定就是在保證:同一時間,只有一個 consumer 在消費這條 stream。
WritableStream:只有入口的「收件箱」WritableStream 的工作只有一個:收下資料,然後處理掉。
它可以把資料印出來、畫到畫面上、存進檔案,但資料進去之後,不會再從這個端點的其他地方出來。流程在這裡結束。
const inbox = new WritableStream({
  // 每收到一筆資料,就會呼叫一次 write
  write(chunk) {
    console.log('收到:', chunk);
  },
});

const writer = inbox.getWriter(); // 拿到「投遞工具」

await writer.write('A'); // 收到:A
await writer.write('B'); // 收到:B
await writer.close();    // 告訴它:沒有資料了
'A' ──→ [ WritableStream 入口 ] ──→ console.log('收到:A')
                                      (流程結束)
這段程式裡有兩個角色,不要混在一起:
inbox(WritableStream):收件箱本身,決定「收到資料後要做什麼」。writer:投遞工具,負責「把資料放進收件箱」。為什麼要先
getWriter()?
因為WritableStream本身沒有write()方法,要先拿到 writer 才能投遞。拿到 writer 的同時,這個收件箱會被鎖定,避免其他地方同時寫入。之後改用pipeTo()時,Web Streams 會替我們處理寫入,就不必自己拿 writer。
WritableStream沒有getReader()。
它只有入口、沒有出口。如果你希望資料「處理完還要交給下一站」,要用的是TransformStream。
TransformStream:入口 + 出口的「翻譯機」
TransformStream是中間加工站:一邊放原料進去,另一邊拿成品出來。
它和 WritableStream 最大的差別是:身上同時有兩個端點。
const transform = new TransformStream(/* 加工邏輯 */);

transform.writable; // 入口:一個 WritableStream
transform.readable; // 出口:一個 ReadableStream
                  TransformStream
       ┌───────────────────────────────────┐
原料 ─→ │ writable ──→  加工  ──→ readable  │ ─→ 成品
       │ (入口)                 (出口)  │
       └───────────────────────────────────┘
這是今天最關鍵的一句話:
TransformStream不是全新的東西,它就是「一個WritableStream入口」加上「一個ReadableStream出口」,中間夾著加工邏輯。
所以 transform.writable 裡的 writable,和上一小節的 WritableStream 是同一種東西。差別只在:
readable 那一側,讓下一站繼續拿。TextDecoderStream瀏覽器內建的 TextDecoderStream 就是一台 TransformStream,工作是:
把 bytes(
Uint8Array)翻譯成文字(string)。
            TextDecoderStream
       ┌────────────────────────────┐
bytes →│ writable → 解碼 → readable │→ string
       └────────────────────────────┘
實務上我們很少手動操作它。但為了看清楚「入口寫、出口讀」,這裡刻意手動做一次:
const decoder = new TextDecoderStream();

// 入口:從 writable 拿 writer,準備放 bytes 進去
const writer = decoder.writable.getWriter();

// 出口:從 readable 拿 reader,準備讀出文字
const reader = decoder.readable.getReader();

// 準備一筆 bytes(「你好」編碼後的結果)
const bytes = new TextEncoder().encode('你好');

// 先在出口等著拿,再從入口放進去
const readPromise = reader.read();
await writer.write(bytes);

const { value } = await readPromise;
console.log(value); // '你好'
看這段程式時,只要注意兩件事:
decoder.writable,讀取用 decoder.readable。 同一台翻譯機,兩個端點分工完全不同。為什麼要「先讀、再寫」?
TransformStream的出口預設不會預先存放成品:出口沒有人在等,入口的await write()就會一直等下去。 所以這裡先呼叫reader.read()表示「我在出口等了」,現在只要記得順序即可。
WritableStream 與 TransformStream兩者都能寫處理邏輯,差別不是「能不能執行程式碼」,而是有沒有出口。
判斷只需要問一個問題:資料處理完,還要不要往下傳?
- 不用,到這裡就結束 →
WritableStream- 要,加工後繼續往下傳 →
TransformStream
有了三種角色之後,把「出口」接到下一站的「入口」,就是一條 pipeline。
三種角色不需要每次都全部出現,可以依需求組合:
ReadableStream → consumer 自己讀

producer 自己寫 → WritableStream

ReadableStream → TransformStream → consumer 自己讀

ReadableStream → WritableStream

ReadableStream → TransformStream → WritableStream
上一節我們手動拿 writer、拿 reader,是為了看清楚每個端點。實際開發時,通常交給兩個 pipe 方法幫我們接:
| 方法 | 用途 | 回傳 | 之後還能接嗎? |
|---|---|---|---|
pipeThrough(transform) |
經過加工站 | 加工站的出口(ReadableStream) |
✅ |
pipeTo(writable) |
抵達終點 | Promise,全部送完時 resolve | ❌ |
pipeThrough():經過加工站const textStream = response.body.pipeThrough(
new TextDecoderStream(),
);
pipeThrough() 在幕後幫我們做了兩件事:
response.body 的出口,接到 TextDecoderStream 的入口(.writable)。TextDecoderStream 的出口(.readable)回傳給我們。response.body(bytes)
↓ 自動接到入口
TextDecoderStream.writable
↓ 解碼
TextDecoderStream.readable
↓ 回傳出來
textStream(string)
pipeThrough()回傳的仍然是ReadableStream。
所以textStream可以交給 consumer 自己讀,也可以再接下一個pipeThrough()或pipeTo(),一直串下去。
pipeTo():抵達終點const screen = new WritableStream({
write(text) {
console.log('顯示:', text);
},
});
await textStream.pipeTo(screen);
textStream(string)── pipeTo() ──→ screen(WritableStream)
pipeTo() 會把資料一筆一筆送進 screen,不需要自己呼叫 getWriter() 或 write()。它回傳的 Promise 會在所有資料送完後 resolve,所以可以 await 等整段傳完。
這裡刻意新建一個
screen,沒有沿用前面的inbox。inbox已經被getWriter()鎖定並呼叫過close(),再拿去pipeTo()會出錯。
await response.body
  .pipeThrough(new TextDecoderStream()) // 經過翻譯機:bytes → string
  .pipeTo(screen);                      // 抵達收件箱:顯示文字
response.body ─pipeThrough→ [ TextDecoderStream ] ─pipeTo→ [ screen ]
   出口 (bytes)                 入口 → 解碼 → 出口            入口 (顯示)
簡單記法:中途加工用
pipeThrough(),抵達終點用pipeTo()。
先記住大方向,不要先背 API:
| 名稱 | 一句話 | 比喻 |
|---|---|---|
| writable | 資料的入口,程式把資料寫進去 | 投信口 |
| readable | 資料的出口,程式把資料讀出來 | 取件口 |
ReadableStream |
只有出口,給 consumer 讀 | 取件口 |
WritableStream |
只有入口,資料送到這裡就結束 | 收件箱 |
TransformStream |
入口 + 出口,加工後繼續往下傳 | 翻譯機 |
pipeThrough() |
經過加工站,回傳出口,還能繼續接 | 中途站 |
pipeTo() |
抵達終點,回傳 Promise | 終點站 |
這些問題都需要先有一張共同地圖:哪一端是入口、哪一端是出口、加工站同時有兩個端點。 地圖先建好,後面才不會把角色和操作混在一起。
pipeline 則是端點被接起來之後才出現的資料路徑;它不一定要以 WritableStream 結束,consumer 自己讀也可以。
如果前面 Iterator 系列學的是:
不要先問資料有多少,而是問下一筆資料怎麼取得。
那 Web Streams 再往前一步:
當資料持續產生時,怎麼讓它在 producer、transform 與 consumer 之間安全地流動?
今天讀了好多以前不太熟悉的東西,雖然知識量有點大,平常工作滿少看到算是挑戰新知識。
我覺得不用逼自己每一步都要立刻搞懂,知道這一串資料處理流程怎麼走,還有 Stream API 的一些特性我覺得對於前端初中階使用應該滿夠的,希望接下來能多找些範例當參考,看這類 Web API 在開源上應用程度如何~繼續加油 😇
ReadableStream(2013)


 iThome鐵人賽
 看影片追技術