

一句摘要:Day 13 的 ReadableStream 是給 consumer 讀的出口;取得 reader 的獨占讀取權後,可用 read() 逐筆等待資料,或以 for await...of 簡化消費。跨過網路時,讀到的是 bytes,還要自己解碼。
前置知識:先理解過 Web Streams大方向:Readable、Writable、Transform 是什麼?;知道 Day 12 介紹過的 Async Iterator。
學習路線:今天專注 consumer 如何持有、讀取與結束一條可讀出口,並嘗試看看 Hono stream() 一次跨網路的完整路徑,最後會發現:chunk 邊界不等於訊息邊界。
標籤:Web Streams API ReadableStream getReader read for await...of TextDecoderStream
專注在利用 ReadableStream 去持有、讀取與結束一條可讀出口,並用 Hono stream() 看一次跨網路的完整路徑。
今天可以不用那麼宏觀去看到資料下上游怎麼連接,把看問題的角度縮小一些,站在 consumer 這一端回答:
我要怎麼等待下一筆值、怎麼知道我有 Stream 持有讀取權,以及如果資料讀完或提早停止時要做什麼,順便把自己的 Web Stream 基礎打穩一些~
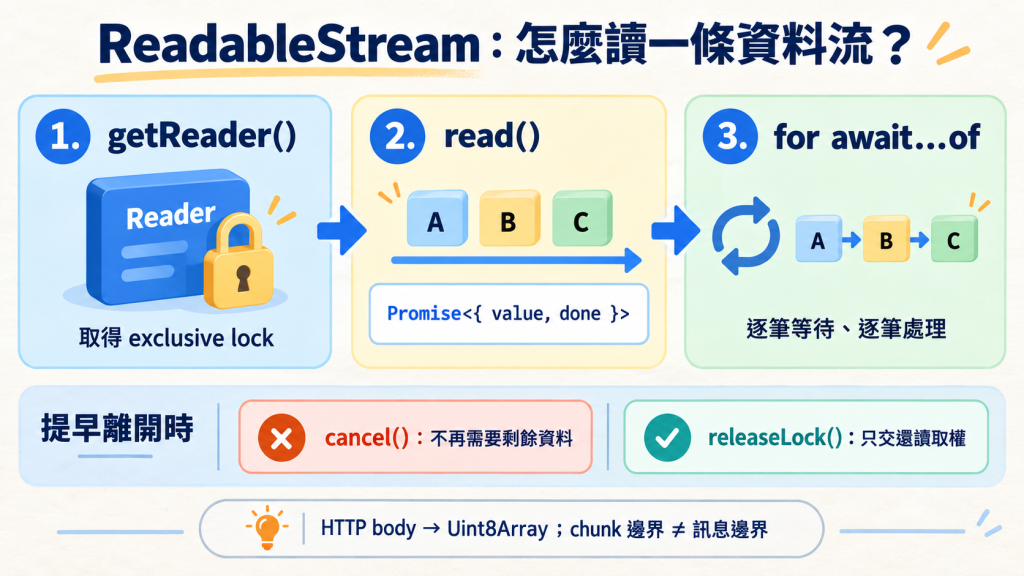
Day 12 的 Async Iterator 以 next() 表達「下一筆好了嗎」; ReadableStream 的 reader 則用 read() 等待下一筆資料:
Async Iterator.next()
→ Promise<{ value, done }>
ReadableStreamDefaultReader.read()
→ Promise<{ value, done }>
結果形狀相似,不表示兩者是同一個 API。Async Iterator 是 ECMAScript 的迭代協議;ReadableStream 與 ReadableStreamDefaultReader 是 Web Streams API,另外還定義了 reader、關閉、失敗、取消與排隊等生命週期。
可以先這樣分工:
Async Iterator:ECMAScript 定義「如何非同步等待下一筆」的協議
ReadableStream:Web API 的可讀出口與生命週期模型
reader.read():consumer 對可讀出口做的明確讀取操作
不過兩者也不是各走各的, WHATWG Streams Standard 在 ReadableStream 上定義了 [Symbol.asyncIterator],讓它主動實作 ECMAScript 的 async iterable 協議:
typeof ReadableStream.prototype[Symbol.asyncIterator];
// 'function'
ReadableStream 也是透過統一的迭代協議提供非同步資料的消費入口:
ECMAScript 定義 async iterable 協議
        ↓
Web Streams 選擇在 ReadableStream 上實作它
        ↓
consumer 才能寫 for await...of stream
每次使用 ReadableStream,或請 AI 幫忙寫一段讀取程式,通常都會先看到這行,忍不住問自己為什麼 😅:
const reader = stream.getReader();
乍看之下,getReader() 好像只是拿到一個方便呼叫 read() 的物件。但它其實還做了一件更重要的事:
決定接下來由誰負責消費這條資料流。
像 Array 這種資料,已經完整存在記憶體裡:
const arr = [1, 2, 3];

console.log(arr[0]); // 1
console.log(arr[0]); // 1
同一份資料可以重複讀取,也可以同時被不同程式使用。
但 ReadableStream 代表的不是一份已經準備好的完整資料,而是一個持續往前移動的資料來源:
producer
   ↓
chunk A
   ↓
chunk B
   ↓
chunk C
   ↓
consumer
consumer 每取走一個 chunk,這條 stream 的消費位置就往前推進,而且不會倒回去:
讀取前            讀完 A 之後
[A] [B] [C]       [B] [C]
 ↑                 ↑
 下一筆從這裡       A 已經離開,不會再出現
所以 stream 除了「有哪些資料」之外,還多了一個很重要的狀態:
目前已經消費到哪裡。
這就是 Web Streams 需要 getReader() 的原因。
呼叫之後,reader 會取得這條 stream 的 exclusive lock ,之前用 response body 回傳時有偷偷看過 ReadableStream 會有一個是否鎖定狀態:
const reader = stream.getReader();

console.log(stream.locked); // true
在 lock 釋放以前,不能再替同一條 stream 建立第二個 reader:
const reader1 = stream.getReader();
const reader2 = stream.getReader(); // TypeError
為什麼要限制成一次只能有一個 reader?因為如果兩個 consumer 同時讀:
readerA.read();
readerB.read();
就會出現一個沒有答案的問題:
chunk 1 → A?
chunk 2 → B?
chunk 3 → 誰?
由於消費位置只有一個,哪個 consumer 該拿到哪一筆會變得不明確。所以 Web Streams 的設計選擇是:
同一時間,只讓一個 reader 負責推進這條 stream 的消費進度。
如果真的需要兩個獨立的 consumer,要用規格提供的 tee() 把一條 stream 分成兩條,而不是搶同一條。
這裡要特別區分:
locked ≠ consumed
只取得 reader、還沒真正讀取就釋放,其他 reader 仍然可以完整接手:
const reader = stream.getReader();
console.log(stream.locked); // true

reader.releaseLock();
console.log(stream.locked); // false
但只要已經讀過:
const reader = stream.getReader();
await reader.read(); // A 被消費掉了

reader.releaseLock();
const reader2 = stream.getReader();
reader2 只能從 B 繼續,不會重新讀到 A。releaseLock() 交還的是「誰有權讀取」,不是「讀到哪裡」。
因此可以把 ReadableStream 想成:
一個除了連著資料來源,也保存「目前讀到哪裡」狀態的物件。
而 getReader() 決定的是:現在由誰負責推進這個進度。誰取得讀取權,誰就要負責把它讀完、取消,或在不再需要時釋放它。
res.json()fetch() 回傳的 response.body 本身就是一條 ReadableStream:
const res = await fetch('/api/user');

console.log(res.body); // ReadableStream
平常我們不一定會自己呼叫 getReader(),因為 res.json()、res.text()、res.blob() 已經幫我們扮演 consumer。以 res.json() 為例,概念上做的是:
ReadableStream
   ↓ 取得讀取權
   ↓ 持續讀取 chunk
   ↓ 讀到 done
   ↓ 組合完整內容
   ↓ 解碼
JSON.parse()
所以 body 一旦被消費,就不能重新再讀一次:
const res = await fetch('/api/user');

const data = await res.json();
await res.text(); // TypeError:body 已被使用(res.bodyUsed === true)
反過來也一樣。如果先自己拿走 reader:
const reader = res.body.getReader(); // res.body.locked === true

await res.json(); // TypeError:body 的讀取權已被 reader 持有
真的需要讀兩次,要先 res.clone()。它底層正是用 tee() 把 body 分成兩條,讓兩個 consumer 各自持有自己的讀取權。
拿到 reader 之後,真正開始讀資料靠的是這行。不過會發現它不是單純回傳資料,還多了一個 done:
const { value, done } = await reader.read();
可以先用一句白話理解它:
「下一筆資料好了嗎?好了就給我;如果整條 stream 已經結束,也告訴我。」
這也是為什麼 read() 不能直接回傳資料,而要回傳一個 Promise。
假設這條 stream 正在從遠端陸續收到資料:
producer                    consumer

chunk A ───────────────→    read()
chunk B ────還在路上────→    ?
chunk C ────還沒產生────→
第一次 await reader.read() 時,A 已經準備好,可以很快拿到。但下一次呼叫時,B 可能還沒送達。
這時 read() 不能直接回答「沒有」——因為**「現在沒有資料」不代表 stream 結束了**。所以它回傳 Promise,把「等待」和「結果」分成兩段:
await reader.read()
        ↓
  下一筆準備好了嗎?
        └─ 還沒 → 等待,直到資料到達、stream 結束或發生錯誤
        ↓
   Promise settled
        ├─ fulfilled { value, done: false }            → 這次讀到的資料
        ├─ fulfilled { value: undefined, done: true }  → stream 已正常結束
        └─ rejected                                    → stream 發生錯誤
假設 stream 依序產生 A → B → C → 結束,每次 read() 會得到:
{ value: 'A', done: false }
{ value: 'B', done: false }
{ value: 'C', done: false }
{ value: undefined, done: true }
done: true是單獨一次read()的結果,不會和'C'一起交付。而且它不是「現在暫時沒有資料」,而是「這條 stream 已經確定結束」——如果只是下一筆還沒來,read()會繼續等,不會先回一個{ value: undefined, done: false }讓你重試。
知道這個規則後,下面這段就很好理解了:
// 手動 loop                          // for await...of
const reader = stream.getReader();    // ← 自動取得
while (true) {                        // ← 自動重複
  const { value, done } =
    await reader.read();              // ← 自動等待下一筆
  if (done) break;                    // ← 自動判斷結束
  console.log(value);                 //   這行才是你真正要做的事
}
reader.releaseLock();                 // ← 正常讀完時自動釋放
看完上面那段,你可能會覺得:只是要逐筆處理資料,怎麼要寫這麼多行?確實可以更短:
for await (const value of stream) {
  console.log(value);
}
兩種寫法讀的是同一條 stream,差別只在那些「維護工作」誰來做:
之所以可以這樣寫,是因為:ReadableStream 已經實作了 async iterable 協議,所以 for await...of 認得它。
那什麼時候該用哪一種?
| 需求 | 較適合的寫法 |
|---|---|
| 只要逐筆處理資料 | for await...of:語法較簡潔。 |
| 要明確掌握讀取、取消或釋放 lock 的時機 | getReader():lifecycle 比較直接可見。 |
for await...of 不是較高級的 reader,它只是把常見的 consumer 工作包起來。也因為包起來了,有些決定它替你做了
value 是什麼型別,要看這條 stream 的 producer 放進了什麼。自己建立的 stream 可以交出任何 JavaScript value:
const stream = new ReadableStream({
  start(controller) {
    controller.enqueue('hello');
    controller.enqueue({ name: 'Rafael' });
    controller.close();
  },
});
讀到的就是 'hello' 或 { name: 'Rafael' }。
但只要資料跨過網路:
const res = await fetch('/api/data');
const reader = res.body.getReader();
response.body 傳遞的是網路收到的 bytes,因此讀到的會是 Uint8Array:
網路
 ↓ bytes
ReadableStream
 ↓ reader.read()
Uint8Array
所以有時候要把 bytes 轉回文字需要另外解碼,
要把 bytes 轉回文字,得再經過一次解碼,「解碼」就是這一步——
res.text()、res.json()會先把整個 body 讀完,再一次把 bytes 解碼成字串。自己讀 stream 時,這一步就要自己做,工具是TextDecoder(或它的 stream 版本TextDecoderStream)。
一條 stream 不會永遠讀下去;但「停下來」不是只有一種意思。先只記兩件事:誰在說話,以及剩下的資料要不要保留。
這四個名稱不在同一個物件上。
自己建立 stream 的 producer 像是用 ReadableStream 建構子自己包裝會拿到 controller;
像前端透過 fetch() response body 的 stream consumer,通常拿到的是 reader,也是前端在接收資料處理端比較常見:
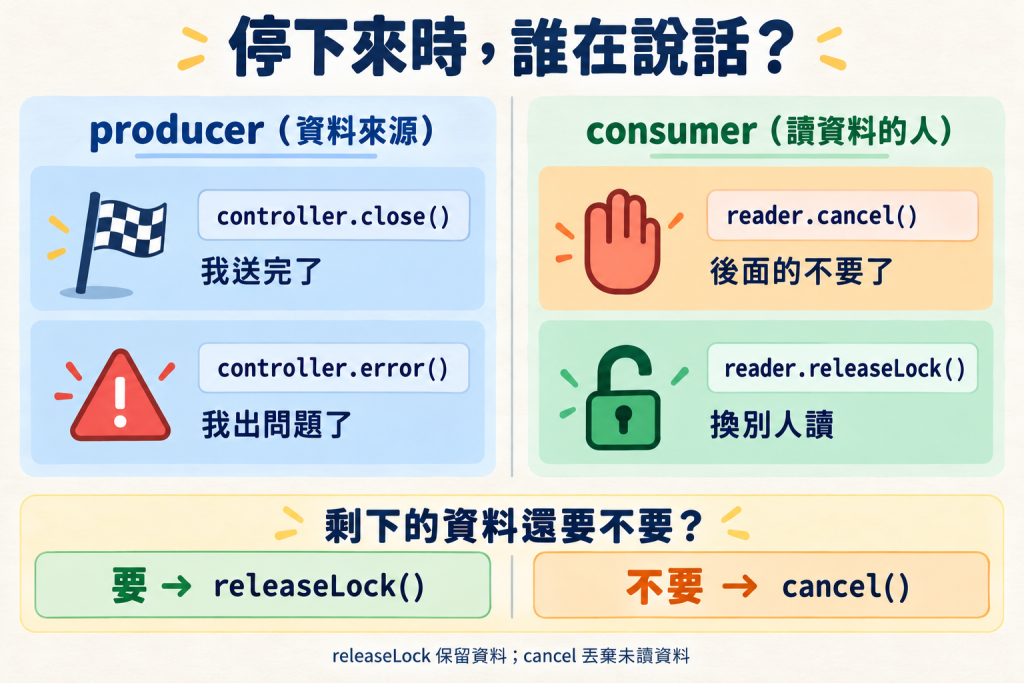
換句話說,consumer 通常只能觀察 close 或 error 的結果;真正由自己決定的是 cancel() 和 releaseLock()。
| 誰做的 | 名稱 | 用一句話理解 | 接下來會怎樣? |
|---|---|---|---|
| producer | controller.close() |
「我送完了。」 | queue 裡的資料仍可讀;清空後,read() 才得到 done: true。 |
| producer | controller.error() |
「這條 stream 壞掉了。」 | 等待中的、之後的 read() 都會 rejected。 |
| consumer | reader.cancel() |
「剩下的資料我不要了。」 | 未讀資料會被丟棄,並通知資料來源可以停止。 |
| consumer | reader.releaseLock() |
「我不讀了,請交給下一位。」 | 只交還讀取權;資料仍留在 stream,下一個 reader 從目前位置繼續讀。 |
它們都由 consumer 呼叫,但問的問題不同:
剩下的資料還要不要?

要  → releaseLock():保留資料,只換 reader
不要 → cancel():丟棄剩下資料,請來源停止
releaseLock() 不會讓已讀的資料回來;它交還的是「誰能讀」,不是「讀到哪裡」。所以新 reader 只能從前一位 reader 停下的地方繼續。
預設是 cancel()。for await...of 的 break 表示「後面的值不需要了」,因此不只離開迴圈,也會取消剩下的 stream:
如果你只想暫停,之後交給別人繼續讀,才需要手動管理 reader 並使用 releaseLock();stream.values({ preventCancel: true }) 也能讓 for await...of 提早離開時不取消,細節可以再多查文件,這邊比較深入一點。
記憶口訣:
close和error是資料包裝來源交代結果;cancel和releaseLock是讀取者決定接下來還要不要資料。
前面都站在 consumer 這一端,也就是取用資料的人。但實務上會看到不少開源自己建立 ReadableStream,把資料包裝成可讀出口再交出去。
看到這種程式碼時不必緊張,也不需要背完整的 producer API。把它理解成一件事就好:資料是怎麼被組裝進這條 stream 的。
最小的寫法是在建立 ReadableStream 時,於 start() 拿到 controller,再把值交進這個可讀出口:
const messages = new ReadableStream({
  start(controller) {
    controller.enqueue('first');
    controller.enqueue('second');
    controller.close();
  },
});
enqueue() 將值放入 stream;close() 表示 producer 已正常結束。若 producer 無法繼續,controller.error(reason) 會讓讀取失敗。
producer enqueue("first")  ─→ stream queue ─┐
producer enqueue("second") ─→ stream queue ─┤─→ reader / async iteration
producer close()            ─→ normal completion marker
                              (queued values drain first, then done: true)
在 start() 一次把資料推完只是最簡單的情況。若要做到「consumer 需要時才產生下一筆」,會改用 pull(controller),並搭配 highWaterMark 與 controller.desiredSize 調節速度,也就是 flow control 與 backpressure。今天先知道有這條路即可。
前面五節的 producer 都是自己 new ReadableStream() 手動 enqueue,資料從頭到尾沒離開過記憶體。實務上真正會遇到的 ReadableStream 多半來自網路,所以這一節用 Hono 起一個會漸進輸出的 endpoint,再拿今天學的 reader 去讀它。
這裡選 Hono 還有一個學習上的理由:
它是以 Web 標準為基礎的框架,用的就是
Request、Response、ReadableStream、TransformStream這些 Web API,包裝得很輕量。所以待會看到的東西,和前面五節講的是同一套 API,不必為了跑起一個 server,先去多學一套 Node.js 專屬的 stream 介面(node:stream的Readable、Writable和 Web Streams 是不同的東西)。同一份理解也能直接帶到 Deno、Bun 或 Cloudflare Workers
~至少對於前端來說 底層都是 Web API 實作出來,沒有太多模組包裝,對想學習一些Web API 應用是不錯參考😍。
Hono 的 stream() 將 server 的漸進式寫入包裝成 HTTP response。它以 TransformStream 接住寫入內容,再把可讀的一端作為 response body;client 端拿到的仍是可由 reader 或 async iteration 消費的 ReadableStream。
以下是有限的文字串流。callback 結束時,Hono 會自動關閉 response,因此這個例子不需手動 close():
import { Hono } from 'hono';
import { stream } from 'hono/streaming';

const app = new Hono();

app.get('/greeting', (c) =>
  stream(c, async (output) => {
    await output.writeln('hello');
    await output.writeln('world');
  }),
);
將 helper 名稱暫時拿掉,hono stream 資料處理的路徑大概流程:
Hono callback
  → output.write() / output.writeln()
  → TextEncoder:字串 → bytes
  → TransformStream 的 writable
  → TransformStream 的 readable
  → HTTP 網路傳輸(bytes)
  → client 的 Response.body:ReadableStream
  → reader.read() / for await...of
write() 收到字串時會先以 TextEncoder 轉成 bytes,再寫進底層 writer。await output.write() 等的是這段寫入流程,不是使用者畫面已顯示文字的確認;網路傳送、proxy buffering 與 UI 更新仍在更後面。
server 那端交出的是 response body,client 這端拿到的就是一條普通的 ReadableStream,可以直接用第三節的 for await...of 消費:
const res = await fetch('http://localhost:3000/greeting');

for await (const chunk of res.body) {
  console.log(chunk);
  // Uint8Array(6) [104, 101, 108, 108, 111, 10]
}
換成 getReader() 加 while loop,行為完全一樣,差別只在生命週期要不要自己管。 像是第三節那張對照表在真實資料上的樣子。
印出來不是 'hello\n',而是一串數字。原因在第三節已經提過:這條 stream 的 producer 是 runtime 的網路層,它交付的是還沒解碼的 bytes。
如果改成 await res.text(),就會直接拿到字串——因為它把整個 body 讀完後才一次解碼。但那樣也就等於放棄了漸進處理,回到「等完整結果」的模式。
想一邊讀一邊處理,就會需要自己組裝工具,像是是 TextDecoder,或 Day 13 已經看過的加工站形式 TextDecoderStream ~以前接 json 格式的 API 習慣了,多了解看看這個既有的功能也不錯😇:
res.text()        讀完整個 body → 一次解碼 → 字串(但要等到最後)
自己讀 + 解碼      每個 chunk 到達 → 逐段解碼 → 逐段處理
本篇專注在讀取權與生命週期,所以解碼到這裡先停住:知道 value 是什麼型別、由誰決定,比急著轉成文字更重要。
還有一點要和解碼分開看:server 呼叫了兩次 writeln(),client 並不保證收到兩個 chunk。網路傳輸與 proxy buffering 可能把兩次寫入合併,也可能把一次寫入切開。
解碼     → 解決「這些 bytes 是什麼字」(TextDecoder 的責任)
訊息邊界 → 解決「一則訊息到哪裡結束」(資料格式的責任)
就算 bytes 已經正確解碼成文字,還是不知道一則訊息在哪裡結束——那要靠雙方事先約定的格式,例如以換行分隔。
讀到這裡可能會想:既然一個 chunk 不見得剛好是完整內容,那我一直讀下去、等 done: true 再一次處理,不就好了?
可以,但那等於放棄串流。先看實際跑起來的結果。server 明明分兩次寫:
await output.writeln('hello');
await output.writeln('world');
client 收到的卻是一個 chunk:
chunk 1: Uint8Array(12) [104,101,108,108,111, 10, 119,111,114,108,100, 10]
                          h   e   l   l   o   \n   w   o   r   l   d  \n
兩次寫入被合併了。反過來也會發生:一次寫入被拆成好幾個 chunk 陸續抵達。chunk 的邊界是傳輸層切的,和你的程式邏輯無關。
所以這裡其實有三件不同的事,很容易混在一起:
chunk 到了         → 傳輸層切出來的,可能是半則訊息,也可能是三則
一則訊息結束了      → 要看雙方講好的格式(例如「以換行結尾」)
整條 stream 結束    → done: true
done 只回答最後一個。它說的是「不會再有資料了」,不是「這一則訊息收完了」。
這也正是不能等 done 的原因:聊天室、AI 逐字回覆或 SSE 這類連線可能開著好幾分鐘,等到 done 就等於等到最後——那和一開始就用 res.text() 沒有差別,漸進處理的意義也就沒了。
想在 stream 還開著的時候就知道「這則收完了」,只能靠事先約定的格式。例如講好一則訊息以換行結尾,consumer 就自己累積,看到 \n 才交出一則:
收到 "第一段\n第二"   → 交出「第一段」,剩下的 "第二" 先留著
收到 "段\n第三段\n"   → 和 "第二" 接起來交出「第二段」,再交出「第三段」
順帶一提,這和前面的解碼是兩個不同層次的問題:
解碼      → 這些 bytes 是什麼字(TextDecoder 的責任)
訊息邊界  → 一則訊息到哪裡結束(資料格式的責任)
就算 bytes 都正確解碼成文字了,仍然不知道一則訊息在哪裡結束。
把這兩個問題放回 Day 13 的起點,會發現它們不是 stream 的缺陷,而是代價:
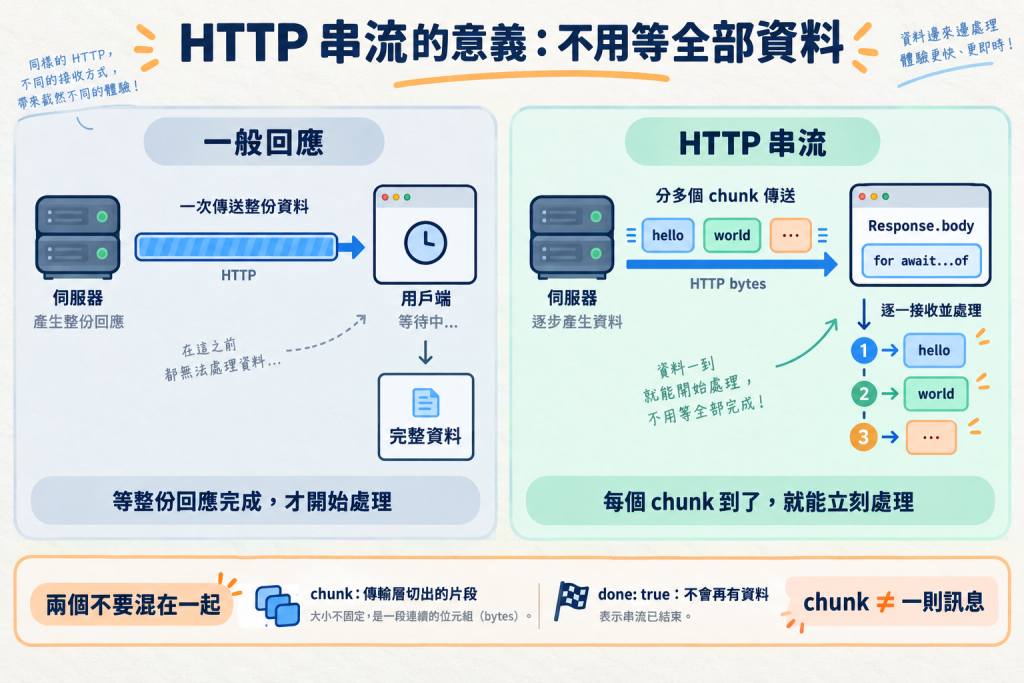
res.json() 之所以完全不用擔心這些,正是因為它選擇等到最後——第二節那張流程圖裡的「組合完整內容 → 解碼 → JSON.parse()」,就是它替你把三件事一次做完。
所以當你決定不等,原本被「等到最後」順手解決掉的問題,就會回到你手上。這不是做錯了什麼,而是串流本來就是這樣的交換:用多做一點事,換提早拿到資料。
第四節說 cancel() 是 consumer 表達「我不想再等剩下的資料」。跨過網路之後,這個訊號不會停在 client:若 client 停止讀取,response body 的取消可通知到 Hono。
實務上的無限串流應以 output.aborted 或 output.onAbort() 清除 timer、訂閱或上游工作。
這也再次說明取消的界線:它是連線生命週期的通知,不保證已開始的資料庫交易或遠端工作會自動回復,這點倒是AbortSignal 一樣,前端取消API請求後,因為通道已經建立,後端還是需要做一些對應處理,希望後續有機會也可以找找相關知識。
→ 取得 reader,也取得 stream 的 exclusive lock
→ res.json() / res.text() 也是 consumer,所以 body 只能讀一次
→ Promise<{ value, done }>
→ 結束 reader 的持有關係,不等於取消 stream
→ 簡化逐筆消費;提早離開走的是 cancel(),不是 releaseLock()
→ 想中途停下、之後還要讀:回到手動 loop
→ value 是 Uint8Array,尚未解碼
→ chunk 邊界由傳輸層決定,不等於訊息邊界
今天是慢慢建立心法,認識 ReadableStream 本身就有的特性和一些 API 規則 :
從 Stream「可讀出口」走到 consumer 的具體操作:先取得讀取權,再等待每一筆資料,明確區分正常完成、失敗、取消與釋放 lock,最後用一條真實的 HTTP 串流確認這些規則在網路上同樣成立。
WHATWG Streams Standard — Readable StreamsReadableStream 的核心模型、關閉、錯誤與 queue。
WHATWG Streams Standard — ReadableStreamDefaultReader
reader、read()、lock 與釋放規則。
WHATWG Streams Standard — Async iterationReadableStream 的 async iterator、values({ preventCancel }) 與提前離開時的行為。
WHATWG Fetch Standard — Body mixinres.json()、res.text()、bodyUsed 與 body 只能消費一次的規則。
WHATWG Streams Standard — cancel()
consumer 取消可讀 stream 的語意。
Hono Streaming Helperstream()、自動關閉與 abort 通知。
Day 12|從 Async Iterator 協議到 for await...of
回顧 next()、手動 loop、for await...of 與提早離開時的清理。


 iThome鐵人賽
 看影片追技術