
你可能也做過:打開 Claude Code 或 Cursor,講幾句話,一個下午就做出一個能跑的小工具。你自己用得很順,截圖貼到社群,有人按讚,有人留言問哪裡可以下載。
這時候你會給他嗎?
給了之後,那就不只是你自己的玩具了。它在別人的電腦上跑,別人照著它顯示的東西做決定,而你不在旁邊。
Andrej Karpathy 在 2025 年 2 月提出「vibe coding」這個詞的時候,其實就把界線講得很清楚:對 AI 的產出全部按接受、不看改動差異(diff)、錯誤訊息直接貼回去,這樣做「拿來做用完就丟的週末專案還不錯」。
問題是,做得好用的專案,常常不會被丟掉。
我用 vibe coding 做了一個叫 usage 的開源工具,放在 macOS 頂端選單列或 Windows 系統匣,用來顯示 Claude Code、Codex、Antigravity、Grok CLI 的額度還剩多少、今天花了多少錢。後來又陸續長出接續上次進度、省 token 模式、token 浪費健檢和 HTML 報告,介面支援五種語言。
專案在 2026 年 5 月 17 日送出第一個 commit。到了第 6 天,GitHub 上就有了第 100 顆星;到今天累積了 322 顆星、54 個 fork,可以直接用 brew 或 PyPI 安裝,前後發布了 210 個版本號。
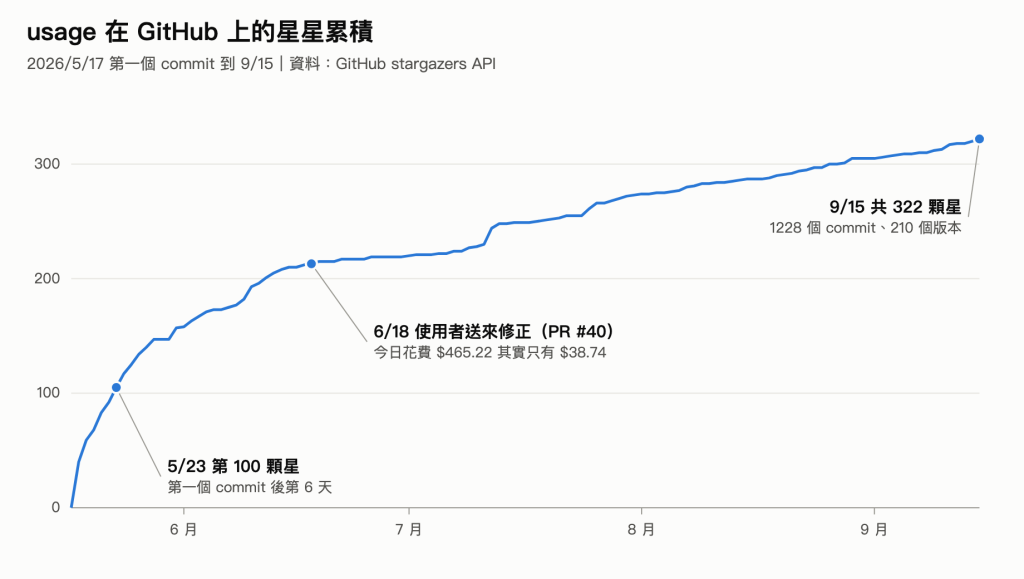
有一位使用者 ericweichun,從 5 月底開始陸續送了 27 個 PR(修改建議)過來。6 月 18 日他送出第 25 個(PR #40),說明裡寫了一行:
Real-data verification: today's total dropped from the false $465.22 to $38.74
我的工具告訴使用者,今天 Codex 花了 465.22 美元。但實際上只有 38.74 美元,差了 12 倍。
原因有兩個:Codex 分支對話會把前面的歷史紀錄再記一次,工具把它重複算了進去;推理消耗的 token(計費單位)已經包含在輸出總數裡,工具又加了一次。
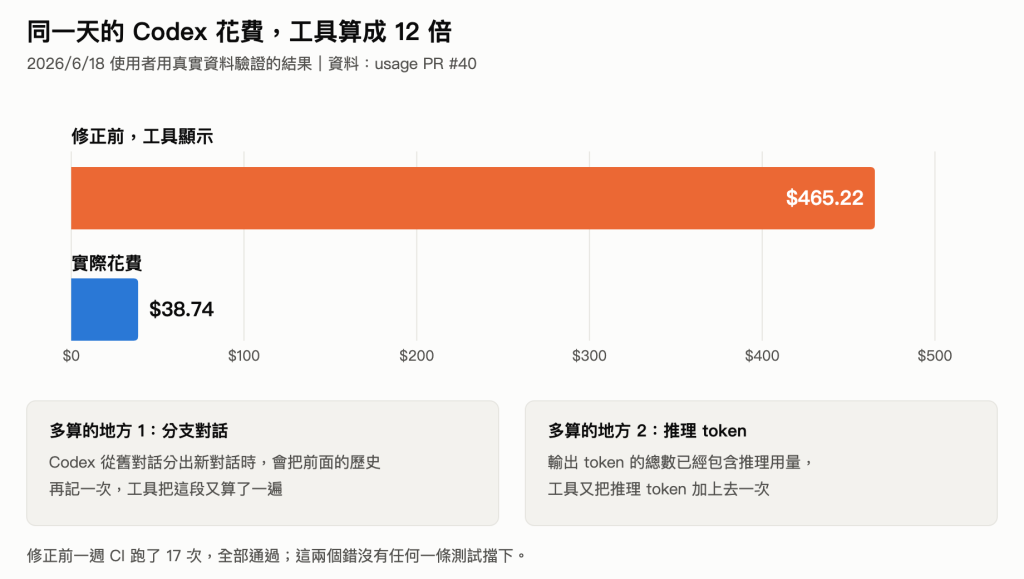
這段程式是 AI 寫的。它的測試檔也是 AI 在第二天建的,之後改過 22 次。修正前那一週,CI(每次改動程式時自動跑的檢查)跑了 17 次,17 次全部通過。那位使用者修正時,另外補了兩百多行測試。
如果是自己用的週末專案,算錯了就算了。但一旦有人安裝,數字就會被拿去做決定:要不要停下來、要不要換方案、這個月是不是超支。那位使用者願意花時間送 27 個 PR,代表他是真的在用這些數字,而其中一個關鍵數字,我給錯了。
測試只會檢查寫測試的人想得到的情況。那段程式和它的測試是同一個 AI 寫的,AI 沒想到 Codex 分出新對話時會把舊歷史再記一次,測試也就不會去測。所以 CI 綠了 17 次,一直要等到有人拿真實的使用紀錄去跑,這個錯才浮出來。
那位使用者修正時補上的測試,現在留在專案裡,之後每次改動 CI 都會跑一遍。同一個錯,不會再安靜地溜過去。
這也是這 30 天我想寫的:在 vibe coding 做出原型之後,怎麼讓一個由 AI 寫出來的東西,改了一千多次還能被信任。
Simon Willison 對 vibe coding 下過一個很嚴格的定義:用 AI 寫軟體,而且不審查它寫的程式碼。如果有審查、有測試、能向別人解釋原理,他說那就只是軟體開發。
照這個定義,usage 是真正的 vibe coding,因為我不逐行讀 AI 寫的 code。
這是整個系列的前提,也是限制:既然不靠讀 code 把關,每一次改動有沒有改壞東西,都得靠 code 以外的方法來確認。指令怎麼下、測試誰來寫、CI 擋什麼、另一個 AI 怎麼審,這些才是這 30 天要談的重點。
每一篇都會從 usage 發生過的真實事件出發,附上 commit 或 PR 讓你回查。
如果符合以下幾點,這個系列就很適合你:
也先說清楚這裡不會有什麼:
明天就從 5 月我對 AI 講的第一批指令開始:看看一句話能做出什麼,又漏掉了什麼。


 iThome鐵人賽
 看影片追技術