

Day 2 把 Guardrails 可以介入的位置展開了:從使用者輸入、檢索資料,到工具執行前後,都可能需要控制。但架構圖、流程圖畫完,工程師還有一個問題沒得到答案:每個檢查點,究竟要依什麼條件放行?
「不要洩漏個資」聽起來很明確。直到客服需要替客戶修改地址,團隊才發現,地址本身就是個資。全部擋掉,服務做不下去;全部放行,又違反原本的要求。
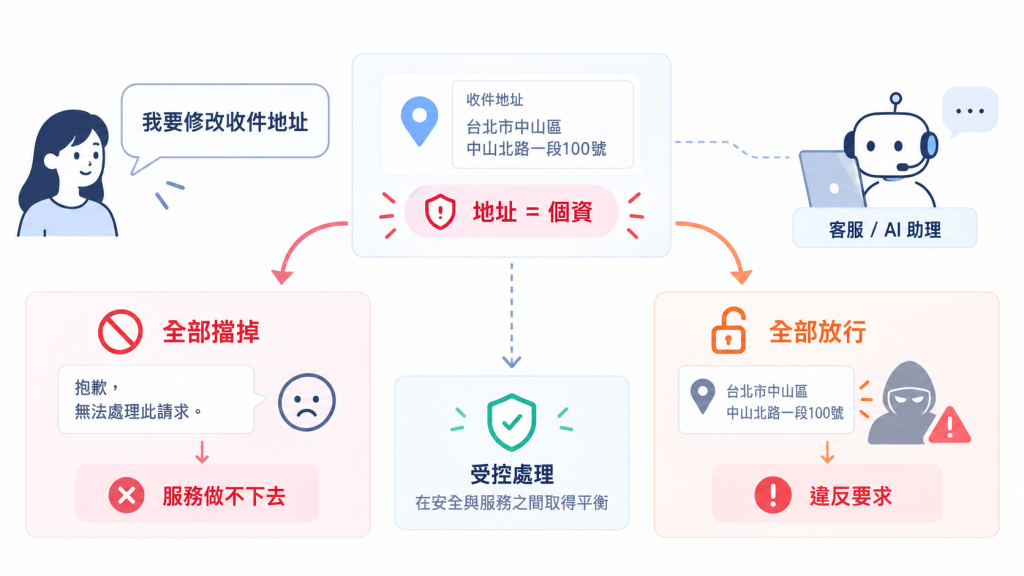
問題卡在政策還沒寫成工程可用實現規格;今天沿用客服案例試著把一句要求,拆成可以實作、也能驗收的控制項。
假設公司的規定是:「客服使用 AI 時,不能把客戶個資送到未核准的外部服務」。
這句話方向沒錯,但對工程師來說還不夠;因為系統真正需要知道的是:
例如:客戶想修改收件地址。
一種比較安全的做法是讓地址直接填在受控表單裡,再交給內部訂單系統處理。外部 LLM 只需要知道「客戶想修改地址」,幫忙理解需求或產生回覆,不一定需要看到完整地址。
參考:像是在 Chatbot 裡新增 Human In The Loop + Pop Up Windows
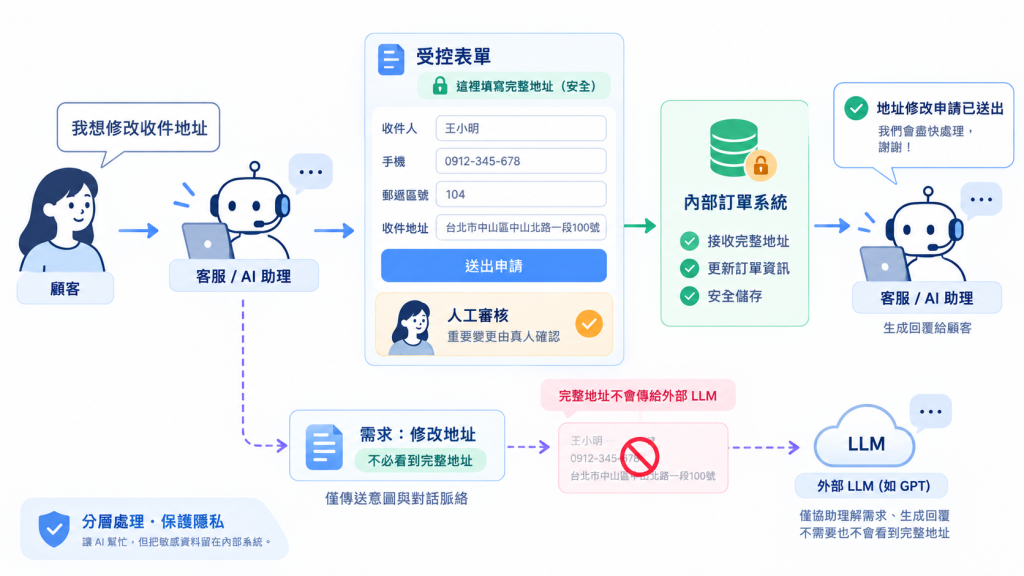
而比較明確的描述會是:
送出模型請求以前,先檢查這次準備送出去的內容,
有沒有超出目的端被允許接收的資料範圍。
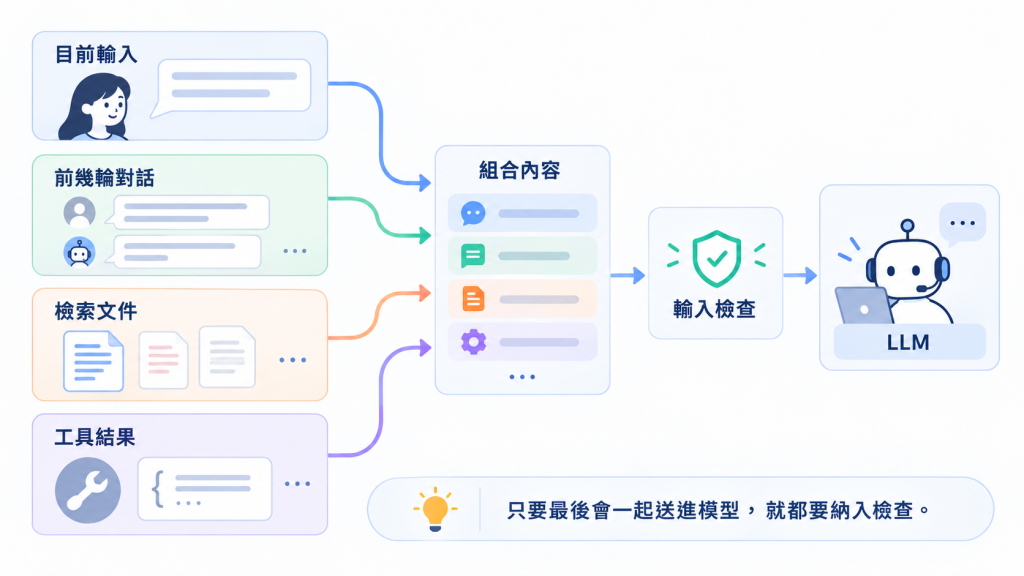
而且不能只看使用者最新輸入的那一句話。
因為個資可能不止藏當前的使用者輸入中、有可能在前幾輪對話、RAG 找回來的文件,甚至工具剛剛回傳的結果裡。只要最後會一起送進模型,就都應該納入檢查。(題外話:早期的 Prompt Injection 就有用過這類的手法來繞過 Guardrails / LLM 內部的 Limitation;甚型到近期也還有案例)
延伸閱讀:Why do multi-turn prompt injections create more risk for agentic AI systems?
實務上 Detector 會有不同技術方法,像是:
Tips: 大量詞彙時,也可以使用 Trie 或 Aho–Corasick 演算法提升搜尋效率
Tips:事實上臺灣政府的資料標準平台已經整理了許多關於台灣在地的 PII 或相關內容,在設計Guardrails 解決方案或應用時可以先參考。
Tips:Twinkle Al 社群開源了針對臺灣 PII 偵測的模型「privacy-filter-tw」可以去申請看看。
Tips:LLM 確實可以處理部分需要語意判斷的 PII 情境,但它的成本或延遲性可能也是最高的;讀者再評估一下是不是 LLM is All You Need;還是因地制宜選對工具、做合理且合適的事情。
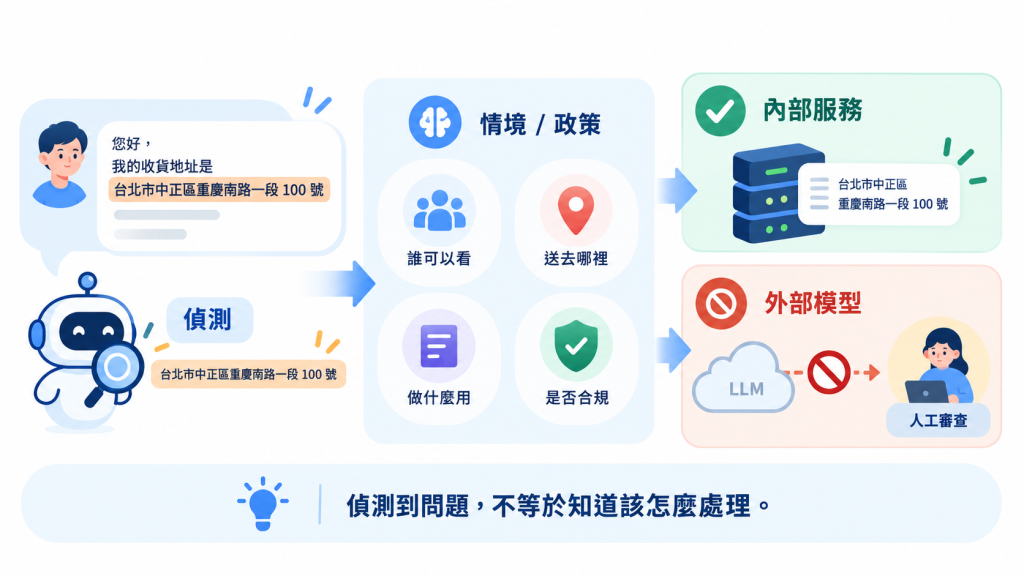
以判斷使用者內容是否有地址的案例而言、Detector 雖然可以回報疑似地址文字及其在內容中位置,但在系統層面上它未必知道誰有權使用、要交給哪個服務,以及目前任務是否真的需要。
因此,測試案例不能只有一段文字和 has_pii: true。至少要把影響政策判斷的情境帶進來(其實就是要考量任務的語境啦)。
| 案例條件 | 本案例的預期處置 | 驗證重點 |
|---|---|---|
| 客戶在對話貼上完整地址,目的端為未獲准接收地址的外部 LLM | 阻止原請求外送,引導使用受控表單 | LLM 未收到原始地址;使用者仍有下一步 |
| 受控表單取得地址,使用者與訂單授權均通過,提交核准的內部修改服務 | 允許地址進入該業務服務 | 只有指定服務收到必要欄位;模型請求沒有夾帶地址 |
| 可信資料契約確認某數值是非敏感測試訂單代碼,且在該任務的允許欄位中 | 允許該欄位進入模型請求 | 不因外觀像電話就一律刪掉,也不只相信自由文字自稱「訂單編號」 |
| 目的端核准資訊缺少,或必要檢查逾時 | 停止外部模型呼叫,轉替代流程 | 未知或錯誤沒有被記成「檢查通過」 |
這樣的情境列得越詳細、越具體,我們就能設計出更好的 Detector 以及測試案例,用於後續驗證及測試;但只有案例是不夠的,還是要考量到底在偵測到問題之後,還有什麼比較彈性的方法,讓內容可以被管理以及被標註分類來執行後續的動作。
接下來我們會參考不同產品的處理方法有哪些、比較對象涵蓋開源、閉源產品以及工具。
筆者有一個很深刻的印象,是早期在做臨床醫療情境中併發症發生的分類預測;那時候的訓練、驗證和測試結果的準確度或召回率都很高。
但筆者當以為萬無一失的時候,在臨床訪談裡,我們卻受到一個像是潑了冷水的反饋。
當模型告訴我這個人會不會發生已經很準,現場的第一線醫療工作者更在意的是:「發生了,那要我去做什麼?」或者是「可以做什麼來介入,避免它發生」。
而在 GRC Engineering / AI Guardrails 的任務情境也是一樣,偵測到了、能判斷到,只是第一步;後續永遠都是要讓當前再生效的時候,告訴後續流程我應該怎麼做,才是實際上要考量的。
以下我們用三步驟的心法來進行思考以及評估:
當然,這些問題早就被不同的開源、閉源供應商思考過了;筆者見賢思齊,為大家整理了以下不同工具產品的處理方式。
| 工具 / 平台 | 類型 | 偵測後處置方式 | 主要設計重點 |
|---|---|---|---|
| Amazon Bedrock Guardrails | Cloud SaaS | 敏感資訊可 BLOCK、MASK/ANONYMIZE,也可以使用 detect mode,只回傳偵測結果而不立即阻擋 |
需要確認實際資料路徑;官方明確指出工具呼叫參數、tool result、model invocation log 與 trace 中的原始值,不會因此自動被遮罩 |
| Microsoft Foundry/Azure AI Content Safety | Cloud SaaS | 依類別與嚴重度回傳 annotations,可選擇 annotate-only 或 block,也可搭配 blocklist |
偵測結果與阻擋結果分開,應用程式仍需根據 detected、severity 與 filtered 決定後續流程 |
| NVIDIA NeMo Guardrails | Open Source | 將控制點拆成 input、retrieval、dialog、execution 與 output rails,可驗證、修改或阻擋內容 | 不只檢查輸入與輸出,也可以檢查 RAG 內容、工具參數與工具結果 |
| Guardrails AI | Open Source | 提供 NOOP、EXCEPTION、REASK、FIX、FILTER、REFRAIN 與 FIX_REASK 等 OnFailAction |
可以依 validator 失敗類型採取不同處置,也能把錯誤交給應用程式自行分流 |
| Microsoft Presidio | Open Source | 對偵測到的文字 span 執行 redact、replace、mask、hash 或 encrypt |
適合把 Detector 與後處理分離,讓不同 PII 類型使用不同匿名化策略 |
這邊為讀者們整理比較常用或通用的動作清單,實務上應該會涵蓋大部分的使用情境:
ALLOW:允許繼續處理,接續處理後續流程BLOCK:拒絕請求或回應罐頭訊息或生成拒絕內容MASK:使用遮罩處理敏感內容:像 [陳大文] 會變成 【###】REPLACE:以標記、假名或替代值取代原;像 【陳大文】會變成 【陳先生】WARN + LOG:允許通過,但留下警告與稽核紀錄RETRY:要求模型重新產生符合政策的結果HUMAN_REVIEW:轉交人工判斷DENY_TOOL_CALL:拒絕執行工具呼叫,或阻止敏感參數送往外部系統如果政策禁止客戶資訊離開內網,偵測服務本身就必須納入同一份資料流與信任邊界;不能先把原文送到外部偵測服務,再請它判斷這段資料能不能外傳(迷之音:雲端服務還是有其能力邊界的)
註一:筆者私心認為地端或雲端都應該要有 Guardrails 的服務,這樣才可以在善用「Cloud / Local」算力時更安心,也是有效的手段
註二:只有對要處理的內容情境、例外及限制有清楚了解,才可以打造以及組合出對應的 AI Guardrails 工具,才能更好地服務使用者與客戶


 iThome鐵人賽
 看影片追技術