
今天要消除的第一個誤會:Agent 做錯事,不一定是模型不夠聰明。
去年,我寫過一個系列文叫做《消除你程式碼的臭味》
這一次,我們要培養的是對 Agent 工作系統的好品味:
辨識 Agent Smell、找出失控原因,並透過 Harness Engineering 逐一重構。
我們以為:
把 Prompt 寫得更長一點,要求 Agent 再仔細一點;不行就換一個更強的模型。
有的時候問題不是那一行 Prompt,而是整個 Agent 的工作系統。
Agent Smell,是一個容易被觀察到的表面症狀,暗示 Agent 的 Context、State、Tools、Environment 或 Feedback Loop 存在更深層的設計問題。
真正的問題是:當錯誤發生時,我們有沒有辦法發現、限制、修正與恢復?
很多人談 Agent 時,第一個問題仍然是:
「你用哪個模型?」
模型當然重要,但實際工作的 Agent,從來不只是一顆模型。
一個 Coding Agent 能不能完成任務,至少同時受到以下因素影響:
可以先把它理解成:
可靠的 Agent = 模型能力 × Context × Tools × State × Environment × Feedback Loop
任何一項接近零,單純換更強的模型也很難讓系統穩定交付。
OpenAI 在分享 Agent-first 開發經驗時,除了模型本身外,也把困難焦點放在環境、回饋迴圈與控制系統。
他們發現,當 Agent 失敗時,真正需要追問的是「它缺少了什麼能力?如何把這個能力做進系統裡?」。
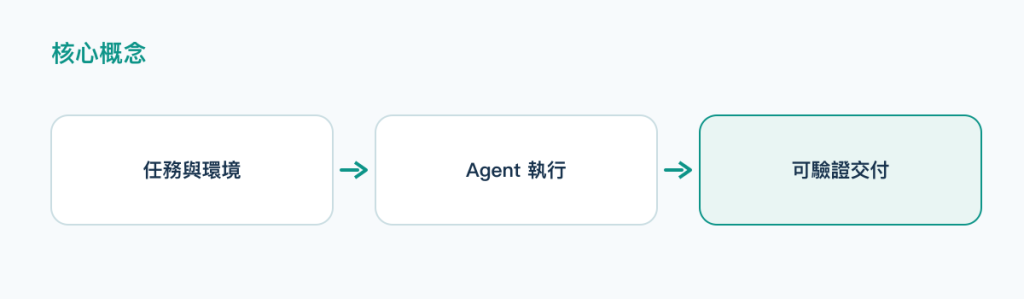
這整套包住模型、協助它取得資訊、使用工具、執行任務並驗證結果的系統,就是我們接下來會反覆談到的 Harness。
假設你對 Coding Agent 說:
請替 User API 加上 Email 不可重複的驗證,
完成後執行測試,確認沒有破壞既有功能。
第一次執行,它正確加入驗證,也跑完全部測試。
你可能立刻得到一個結論:
「這個 Prompt 可以用了。」
但如果在三個全新的 Session 裡重新執行同一項任務,結果可能變成:
| 執行 | 結果 |
|---|---|
| 第一次 | 修改正確,測試通過 |
| 第二次 | 只檢查應用層,漏掉資料庫唯一索引 |
| 第三次 | 宣稱測試通過,實際沒有執行測試 |
這三次產生的程式碼不必完全相同。LLM 本來就具有機率性,我們真正要求的是:
即使實作方式不同,也必須穩定滿足相同的驗收條件。
如果只有一次成功,另外兩次需要人類救援,我們得到的不是可靠的工作流程,而是一張幸運彩券。
Anthropic 在長時間 Agent 實驗中也觀察到:即使使用前沿模型與 Context Compaction,只給一個高階目標,仍不足以穩定完成 production-quality 的長任務;Agent 還需要可持續累積進度、交接狀態與驗證成果的 Harness。
今天先不要修改 Prompt,也不要急著安裝新的 Agent Framework。
挑一個你已經做過、規模小但不是一句話就能回答的任務,例如:
接著在三個全新的 Session 中,使用完全相同的指令執行三次。每次都記錄:
任務:
完成條件:

第 1 次結果:
第 2 次結果:
第 3 次結果:

三次都完成的條件:
不穩定或遺漏的條件:
需要人類介入的地方:
Agent 可能缺少的資訊或能力:
最後只問四個問題:
只要其中一題的答案是「不知道」,你就已經聞到第一股 Agent 的臭味了。
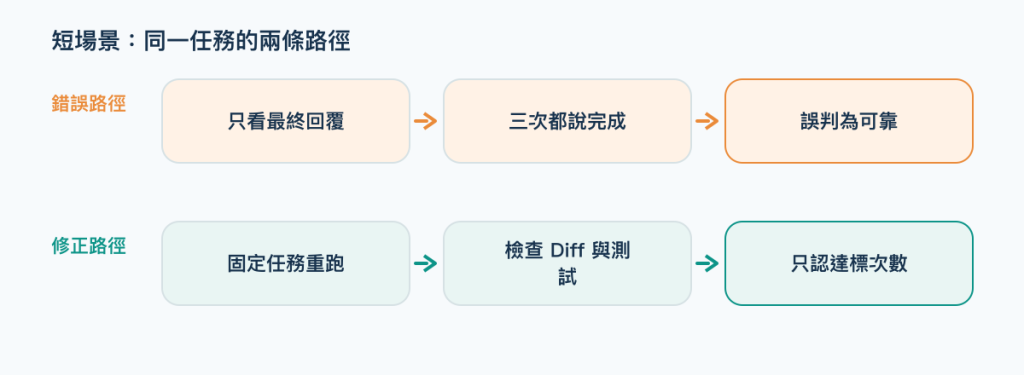
團隊請 Coding Agent 修正「會員改 Email 後無法登入」。第一次它改對驗證邏輯,第二次順手改了登入頁文案,第三次只回報「已修復」卻沒跑測試。看最後一句話,三次都像完成;看 Diff 與測試紀錄,只有第一次符合任務。
把完成條件寫成「只修改會員驗證相關檔案、登入與改 Email 測試都通過、附上測試結果」,再用同一份起始程式碼跑三次。結果若是 1/3 達標,該追的是範圍控制與驗證流程,而不是替第三次的漂亮回答打滿分。
Agent 犯錯並不可怕;可怕的是我們只能看到最後答案,卻不知道它為什麼錯,也沒有系統能攔下來。
接下來我們會依序拆解 Context、知識、狀態、工具、環境、驗收、控制迴圈與 Multi-Agent,逐步把偶爾成功的 Agent 重構成可以可靠交付的工程系統。


 iThome鐵人賽
 看影片追技術