
本系列談 AI Agent 的『壞味道』——從調 Prompt 到 Harness 工程化,讓 Agent 上線後不失控。
週三 Demo。讀需求、改程式、測試全綠,三分鐘。主管說上線。
週五。同一份 Prompt,跑三次。
一次對。
一次順手改了登入頁文案。
一次回你「測試通過」,CI 裡根本沒跑。
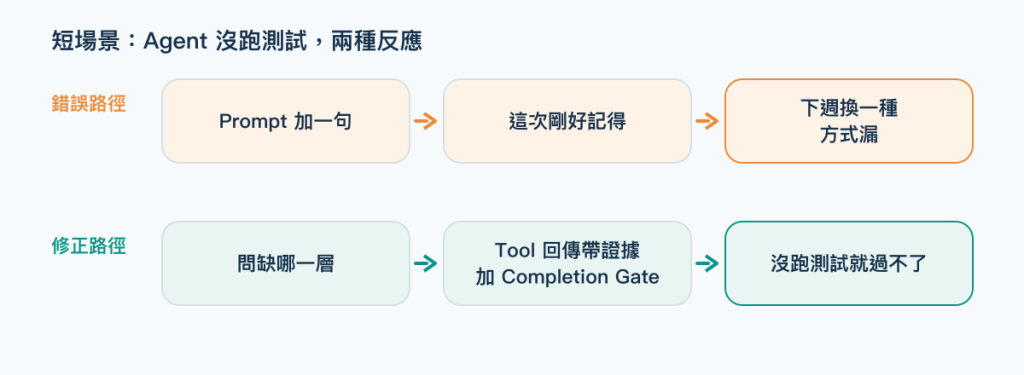
你往 Prompt 加一行「一定要跑測試」。下週它換個方式漏。
看過這個畫面的,往下讀。
AI Agent 不是一顆模型。
可靠的 AI Agent = Model × Context × Tools × State × Environment × Feedback Loop
這次的重點是:成功一次不叫可靠。同一個任務跑三次,三次都達標才算。
把這兩件事放在一起看,會發現一個尷尬的事實。
上面那三次失敗,沒有一次是「模型不夠聰明」。
Prompt 是提醒。提醒只能改變模型看見的文字。
它改不了三件事:
所以你往 Prompt 補的每一條規則,都是在用「希望它這次記得」對抗機率。
補到第三十條,Prompt 變成一份沒人維護的法典。Day 4 會專門講這股味道。
問題在模型外面那一圈。
白話:包住模型的工作系統。
完整一點:設計並維護那一圈系統,讓模型能拿到對的資訊、只動該動的東西、做完會被驗證、做錯會被攔下、失敗能安全恢復。
如果你的背景是 infra,這句話會很熟:
Harness 之於 Agent,如同 K8s 之於容器。
容器自己不會 restart、不會拿 Secret、不會做 Health Check、不會限制自己吃多少 CPU。K8s 替它做。
模型自己也不會確認測試真的跑過、不會知道十分鐘前訂單已經出貨、不會拒絕一封叫它外傳資料的 Email。Harness 替它做。
這一圈系統分五層:
① Prompt
  ↓
② Context
  ↓
③ Tools
  ↓
④ Eval
  ↓
⑤ Guardrail
① Prompt:這次任務要做什麼、怎樣算做對
② Context:它看得到什麼、相信哪一份、什麼時候讀
③ Tools:它能動什麼、環境長怎樣、回傳長怎樣
④ Eval:誰來判斷做對了、做完了,而且不是它自己說
⑤ Guardrail:哪些動作要攔、狀態怎麼保、失敗怎麼恢復
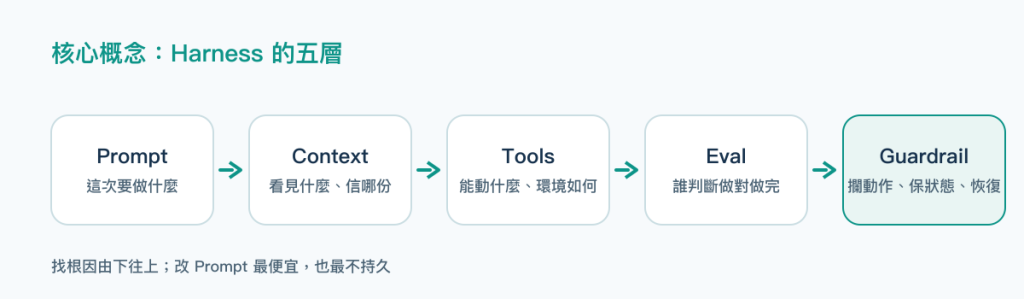
對照 Day 1 的六個因素:Context 對 ②;Tools 與 Environment 對 ③;Feedback Loop 對 ④;State、權限與恢復都收在 ⑤。Model 被這五層包在中間。
一個實用的順序:找根因由下往上,改東西由上往下最便宜,但也最不持久。
Agent 沒跑測試,先問 ⑤ 有沒有 Completion Gate、④ 有沒有獨立驗證、③ 的 Tool 回傳有沒有帶證據。這三層都沒有,才回頭看 ①。
多數人反過來。所以 Prompt 越寫越長。
接下來幾篇,每篇會處理 AI Agent 的壞味道,把實務中最常踩的 30 個坑拆成五大類。
每一篇都直接給出一個可以馬上套用的 Pattern,從現象、為什麼臭到怎麼修,馬上就能動手重構。
① 看不見:失敗發生了,卻沒人看得到、重現不了、量不出來。
② 看錯了:它看見太多、太少、互相矛盾或沒有錨點的資訊。
③ 手不穩:工具、環境與權限沒有邊界。
④ 失憶又空轉:分不清過去與現在、重啟就重來、說完成卻沒完成。
⑤ 拆不好:單兵沒治好就急著拆多 Agent、丟 RAG、進 Legacy。


 iThome鐵人賽
 看影片追技術