
同一份學習投入問卷,可以算信度、做因素分析,也可以估計題目(item)反應模型(model)。這三條路各自回答什麼?如果把它們排成「做完信度,再做效度」的清單,讀者很容易以為每跑完一個分析,就離「量表合格」更近一步。前五天已固定任務與規格,今天要用概念圖釐清:每個方法替哪一段分數解釋提供證據。
我的概念圖不從方法名稱開始,而從一個判斷開始:我看到的是學生對題目的反應,卻想談「學習投入」以及某種分數用途。中間每一條箭頭都需要理論、模型或證據。
先沿分數用途往下讀到作答反應,再看下方三個分析分支;最後沿右側虛線回到分數用途(見圖 6-1)。
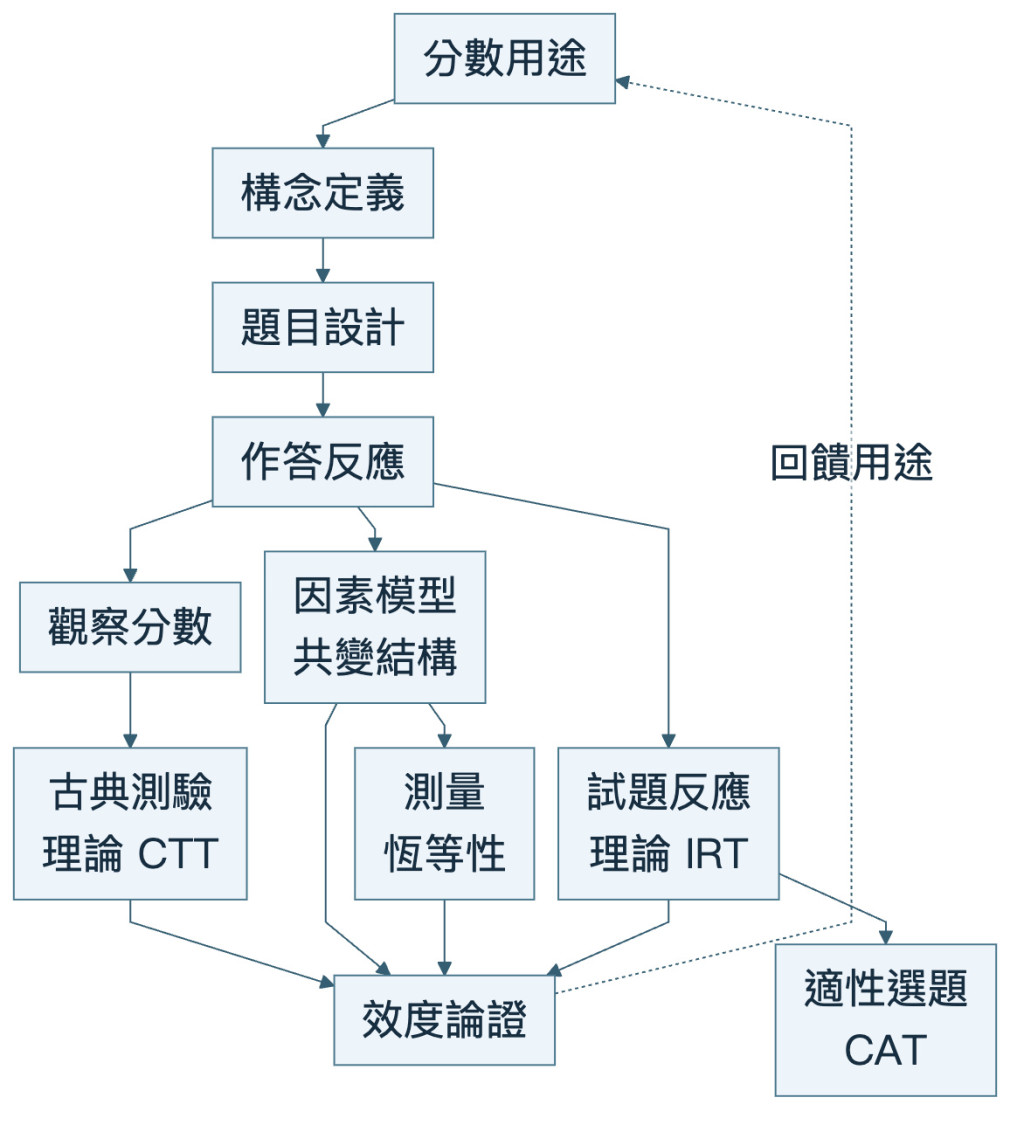
圖 6-1 心理計量概念地圖。實線表示閱讀依賴,右側虛線表示效度論證回饋分數用途;箭頭不是因果證據。CTT 討論分數誤差與信度,因素模型討論共變結構,IRT 討論題目反應機率。圖僅整理本系列主線,節點的工作狀態另見正文表格。
這張圖的用途是顯示依賴和回饋,不是宣稱心理計量只有這幾個分支。Generalizability theory、DIF(差異試題功能)、linking 與 fairness(公平性)都重要,但不在三十天主線。Bayesian IRT(試題反應理論,把人與題目放在同一把尺上)也一樣,需要時再延伸。例如 Day 19 的 2PL(雙參數邏輯模型)題:a = 1.5、b = .5,在 θ = .5 時答對機率 .5、題目資訊量 1.5² × .25 = .5625。
把預定章名交給 Claude 時,可以要求它列出概念節點、先後關係,以及每條箭頭的理由。要特別檢查一種看似合理的畫法:「信度 → 效度」。若圖只剩這條單向流程,讀者便可能把效度當成最後取得的一張證書;這是讀圖時應攔下的錯誤示例,不是本輪重現的模型回答。
我改成回路:分數用途在一開始決定我們需要什麼證據;信度、因素結構、恆等性與 IRT 分析提供部分證據或暴露限制;這些結果再回頭調整分數解釋與用途。Kane 的 argument-based approach 也提醒我,欲主張的 interpretation(分數解釋)/use 愈遠,所需推論與假設愈多。
第二個修正是把作答反應和分數(score)分開。題目反應是資料,總分或潛在(latent)分數是依規則建構的量。如果圖上直接由題目指向構念(construct),中間的步驟就被跳過了。被掩蓋的是 scoring(計分)、模型與誤差。Claude 可以提出節點,但「這條箭頭需要什麼證據」才是教師的閱讀任務。
ENGAGE-v1 是本系列自建的合成示範量表:大學生學習投入三構念各四題,第 8 天會固定題本與生成資料。以 ENGAGE-v1 為例,構念暫分行為、情緒與認知投入,各四題。作答者在五點量尺上回應,產生 12 個 ordinal 作答反應(有序類別)。接著至少有三條分析路。第一條把題目加總後用 CTT(古典測驗理論,把觀察分數拆成真分數與誤差)討論分數變異與可靠度。第二條用 EFA(探索性因素分析)/CFA(驗證性因素分析,把理論寫成可被資料反駁的模型)討論共變結構是否符合三構念假說。第三條用 IRT 討論不同投入程度下,某題反應機率如何改變。
第二條路的具體樣子,是 Day 17 要寫的三因素設定:
| 因素 | 量測題目 | lavaan 語法 |
|---|---|---|
| BE | BE01–BE04 | BE =~ BE01 + BE02 + BE03 + BE04 |
| EE | EE01–EE04 | EE =~ EE01 + EE02 + EE03 + EE04 |
| CE | CE01–CE04 | CE =~ CE01 + CE02 + CE03 + CE04 |
三條路都不能單獨完成效度論證。高信度不表示題目代表了欲談的投入;三因素 fit(模型與資料摘要的相容程度,不證明模型正確)可接受不表示分數用途合理;IRT 題目 fit 也不會自動處理題目內容與後果。這個完整例題讓「方法」回到同一個資料與用途。例如 CFI(比較配適指標)/TLI 摘要相對 baseline 模型的改善、RMSEA(近似誤差均方根)摘要近似誤差與自由度、SRMR 摘要標準化殘差,三者都不證明模型正確。
反例是把概念圖改成軟體選單:psych::alpha、psych::fa、lavaan::cfa、mirt::mirt。這能安排教學示範,卻把研究問題變成函數依賴。只要套件改版,圖就失效;更重要的是,讀者會先問「該按哪個函數」,而不是「我現在要識別哪個目標」。
圖 6-1 心理計量概念地圖。實線表示閱讀依賴,右側虛線表示效度論證回饋分數用途;箭頭不是因果證據。CTT 討論分數誤差與信度,因素模型討論共變結構,IRT 討論題目反應機率。圖僅整理本系列主線,節點的工作狀態另見正文表格。
| 工作狀態 | 在圖中如何使用 |
|---|---|
| 定義 definition | 構念定義先固定用語與範圍 |
| 判斷 decision | 分數用途決定需要哪些證據 |
| 前提 assumption | 三條方法分支各有要明說的假設 |
| 可觀察量 observable | 作答反應與依規則得到的觀察分數 |
| 方法 method | CTT、因素模型、恆等性、IRT 與適性選題 |
| 證據 evidence | 分析結果送入效度論證後,評估能支持哪個主張 |
例如 CFA 的 CFI(比較配適指標)是 observable-derived fit index,不是 evidence 的全部,更不是構念定義。這個分類可以攔下一種語言滑動:從「模型與資料摘要差異不大」滑到「理論已被證實」。
我用刪除測試檢查概念圖。若拿掉「分數用途」,可靠度係數再精確也無法回答是否足以支援班級回饋或個人決策。若拿掉「作答機制」,同一個 1–5 反應會被當成無條件的心理屬性,無法討論題意、反應風格與情境。若拿掉「模型假設」,EFA、CFA 與 IRT 只剩三套輸出格式。
新增節點也要接受同樣檢查。例如想加入機器學習預測時,先問它是否改變本系列的分數用途、是否有後續文章承接,以及需要哪些新證據。若只是增加一個熱門方法,就先放延伸閱讀。每個主線節點都應對應讀者需要做的判斷。
圖中的效度論證雖然畫在末端,工作卻橫跨全程。右側回饋線提醒讀者:題目內容、內部結構、與外部變項關係、作答過程及使用後果等證據,不會在同一天完成。後續每篇只能說明這個結果支持哪一段論證,不能用一句「信效度良好」收掉。
最後,概念圖會隨勘誤更新,但穩定 ID 不變。若 Day 18 發現群體比較還需補一個 fairness 節點,新增的是依賴與版本紀錄,不是偷偷把 Day 7 的用途改寫。這是概念圖和一般心智圖最大的差別:它同時是閱讀導航,也是變更影響圖。
現在可以沿圖 6-1 說出章節順序,也能用表格分辨定義、前提與證據。還缺的一步,是替 ENGAGE-v1 寫出具體用途:究竟要調整全班活動,還是判斷個別學生?這個選擇會改變後面需要的信度、結構與公平性證據。
基礎閱讀是 Standards(美國教育與心理測驗標準) 2014 的測驗、分數解釋與用途語言;發展閱讀是 Kane 的推論論證;研究閱讀可沿各方法節點進入原始論文。下一篇會先寫 score-use argument(論證):同一組題目若用於課堂回饋、個人高風險決策或跨群體比較,所需證據為何不同。


 iThome鐵人賽
 看影片追技術