

Production 出錯時,程式碼只告訴我們可能發生什麼,Logs 和指標才告訴我們剛才發生了什麼。今天替任務追蹤 App 加入足夠但不過量的觀測資訊,再設計一次線上錯誤調查。
一次更新失敗時,我們需要知道哪個版本、哪個端點、何時發生、結果類型和可串聯的請求識別碼。Log 使用結構化欄位,讓人能依時間、錯誤 code 和版本搜尋。一般情況不記錄完整任務標題、Token、密碼或資料庫連線字串;診斷價值不足以交換敏感資料。
指標至少包含請求量、錯誤率和延遲,並區分核心操作。健康檢查只能反映服務是否能回應,不代表資料庫和外部 API 的使用者流程都正常。告警應對應可採取的行動,避免每個偶發錯誤都通知,最後沒人相信告警。
情境是部署後更新任務的錯誤率上升。先確認時間和版本,再查對應端點、錯誤 code 與資料庫狀態;比較部署前後,找出只在新版本出現的變化。讓 Codex 根據遮蔽後 Log 與相關 diff 提出假設,每個假設都要有下一個檢查,不直接修改正式環境。
「根據提供的時間範圍、版本、指標和已遮蔽 Log,列出最多三個可檢驗原因。引用具體欄位與相關程式,先提出最小查證步驟;不要讀取或輸出額外使用者資料,不要直接修改正式環境。確認根因後再提出修正、測試和回復方案。」
修正後不只看錯誤消失,也要確認錯誤率回復、核心流程成功、沒有把 Log 關掉或把例外吞掉。若觀測資料不足以定位問題,應記錄缺口,再補有目的的欄位或指標。
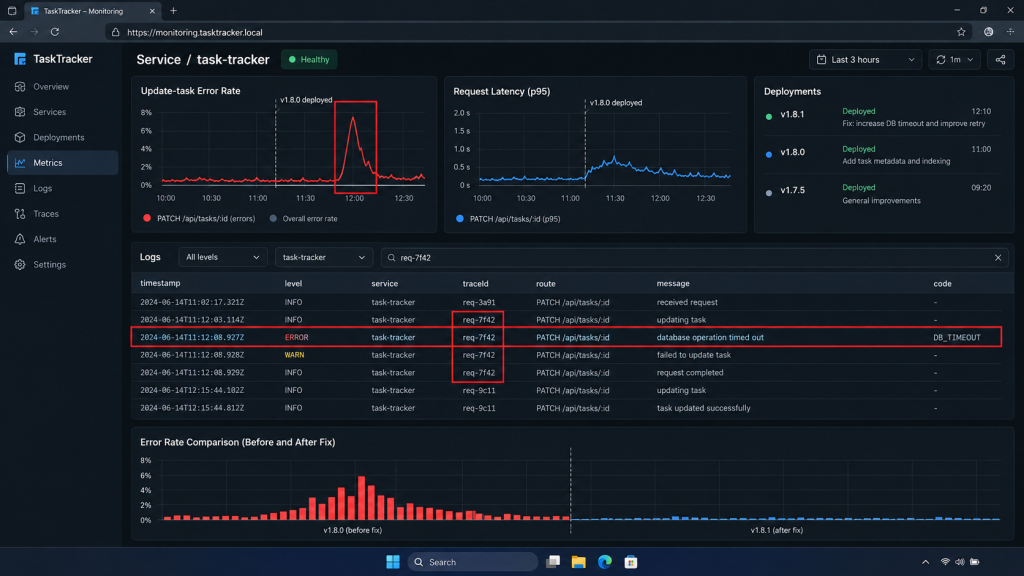
本文完成可觀測性需求與事件調查流程,尚未部署監控或取得線上事件。選用工具、保存時間與成本要在部署時依實際平台決定,不能用本文假設代替。
可觀測性不是上線後才補的裝飾,而是讓人和 AI 能以證據調查系統。明天把 Codex 放進真正陌生的 Repository,看看前面的方法能否帶走。


 iThome鐵人賽
 看影片追技術